Résoudre l’erreur Extra data en reconnaissant le format JSON Lines
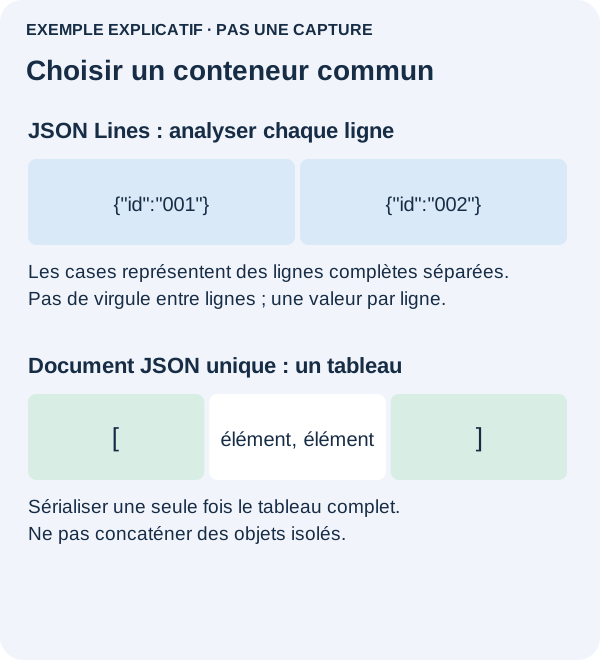
Quand un analyseur accepte le premier objet puis échoue au suivant, examinez le format du fichier avant de modifier les données. Un document JSON possède une seule valeur au premier niveau. JSON Lines stocke une valeur JSON complète par ligne. Deux objets valides placés ensemble ne forment pas nécessairement un document valide.
Une conversion JSONL vers CSV signalée publiquement échouait à la deuxième ligne. Dans une autre discussion, un script écrivait plusieurs objets sérialisés à la suite ; son auteur a confirmé que l’ajout d’un saut de ligne après chaque objet corrigeait le format ligne par ligne souhaité. Cela ne signifie pas que toute erreur Extra data provient de JSON Lines.
Choisissez le lecteur adapté au fichier
Ouvrez une copie dans un éditeur de texte et observez les premiers enregistrements. Si chaque objet complet tient sur une ligne physique, il peut s’agir de JSON Lines. Si un objet s’étend sur plusieurs lignes, la méthode ci-dessous ne convient pas. Si les objets sont collés sans séparateur, corrigez le programme qui les écrit ou utilisez un analyseur prévu pour ce flux ; découper sur les accolades fermantes casserait les objets imbriqués et le texte entre guillemets.
Pour un petit fichier JSON Lines, cette fonction JavaScript conserve le numéro de ligne en cas d’erreur. Elle accepte un saut de ligne final, mais ne supprime pas discrètement les enregistrements vides.
function readJsonLines(text) {
  if (text === "") return [];
  const lines = text.split(/\r?\n/);
  if (lines.at(-1) === "") lines.pop();
  return lines.map((line, i) => {
    if (!line.trim()) throw new Error(`Blank record on line ${i + 1}`);
    try { return JSON.parse(line); }
    catch { throw new Error(`Invalid JSON on line ${i + 1}`); }
  });
}
const source = '{"id":"001"}\n{"id":"002"}\n';
const records = readJsonLines(source);
console.log(records.length); // 2
const ordinaryJson = JSON.stringify(records, null, 2);
const jsonLines = records.map(item => JSON.stringify(item)).join("\n") + "\n";
Choisissez ordinaryJson lorsque le programme destinataire attend un document contenant un tableau unique. Choisissez jsonLines lorsqu’il attend un enregistrement par ligne. N’ajoutez pas de virgules entre ces enregistrements. Pour un ensemble vide, écrivez un fichier JSON Lines vide plutôt que le saut de ligne unique produit par la dernière expression d’exemple.
Comparez le nombre d’enregistrements analysés au nombre attendu dans la source et examinez les premiers et derniers identifiants. Si une ligne échoue, inspectez-la dans la copie originale. La sauter peut faire « réussir » la conversion tout en perdant silencieusement une commande ou un événement de journal. Indiquer le numéro de ligne est plus prudent que journaliser l’enregistrement entier s’il contient des informations privées.
Si le fichier est trop volumineux pour tenir confortablement en mémoire, remplacez cette fonction pour petits fichiers par un lecteur de lignes en flux. Conservez les mêmes contrôles d’erreur et de nombre d’enregistrements. JSON Lines définit les limites des enregistrements ; il ne transforme pas automatiquement les valeurs imbriquées en colonnes CSV.
Les limites des enregistrements font partie du format
La fonction accepte les fins de ligne LF et CRLF, pas CR seul. L’extension .json ne suffit pas à définir le format des enregistrements. Si vous produisez du CSV, décidez comment répartir les champs absents et imbriqués dans les colonnes, puis utilisez un générateur CSV pour gérer les virgules, les guillemets et les sauts de ligne intégrés.
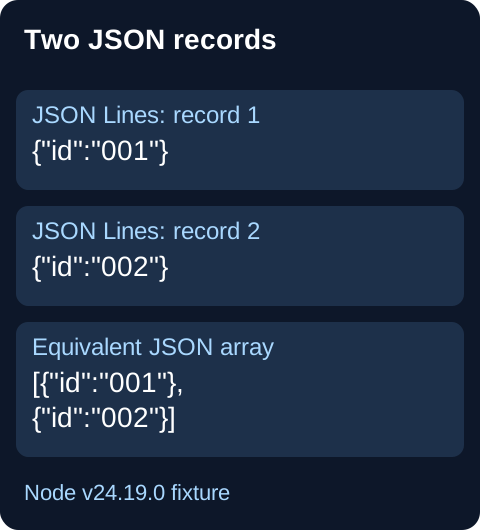
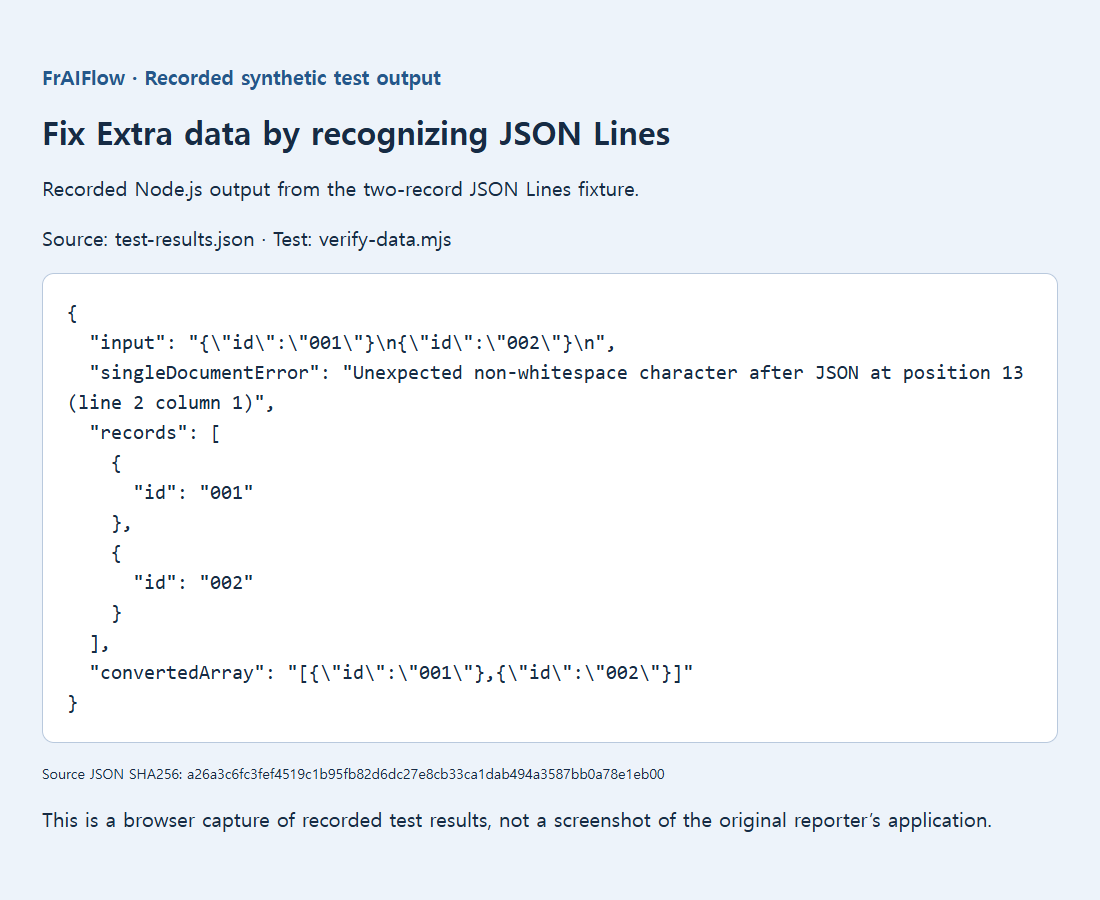
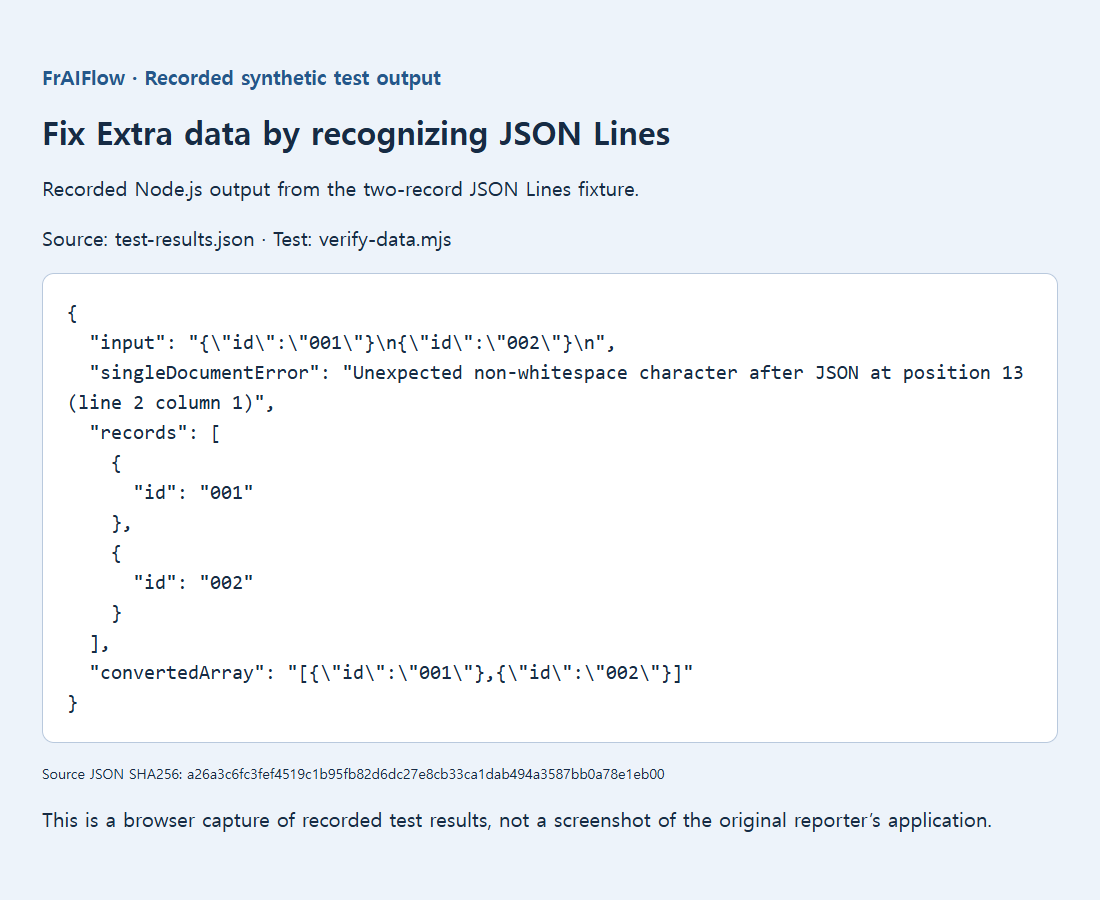
Notre test sous Node v24.19.0 utilisait {"id":"001"} et {"id":"002"} sur des lignes distinctes. Analyser tout le contenu d’un coup échouait au deuxième objet ; analyser les deux lignes donnait deux enregistrements, et JSON.stringify(records) produisait un document tableau valide. Le texte des erreurs et leur position varient selon l’environnement.
Définissez explicitement le format de sortie
La documentation Python prévient que des appels répétés à dump ne créent pas un document JSON unique valide : JSON n’est pas un protocole qui délimite une suite de messages. Un nom de fichier en .json ne suffit pas à définir ce découpage. Confirmez le format attendu auprès de l’outil qui lira le résultat.
Sources, exemples et lectures complémentaires
- Schéma explicatif d’origine
- Discussion publique : conversion JSONL vers CSV et JSONDecodeError Extra data
- Discussion publique : JSONDecodeError après écriture puis lecture du même fichier JSON
- Documentation Python de l’encodeur et du décodeur JSON
- Preuve conservée du test local
- Pourquoi les identifiants JSON changent après l’analyse