Hvorfor JSON-ID'er ændrer sig efter parsing
Et langt JSON-ID kan ændre sig, før formatteringsværktøjet viser det. JavaScript Number kan ikke repræsentere alle heltal over 9007199254740991 nøjagtigt. Hvis et ID ender i den type, kan et pænt output allerede indeholde andre cifre.
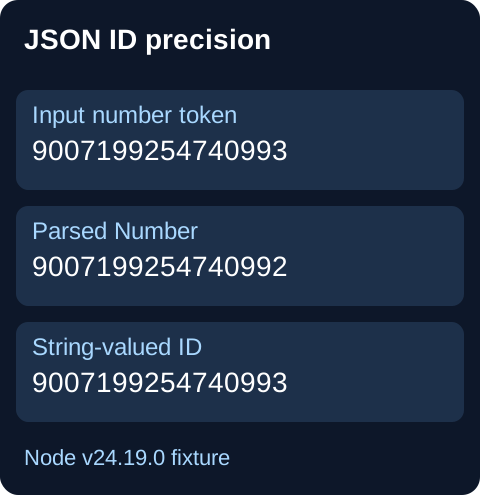
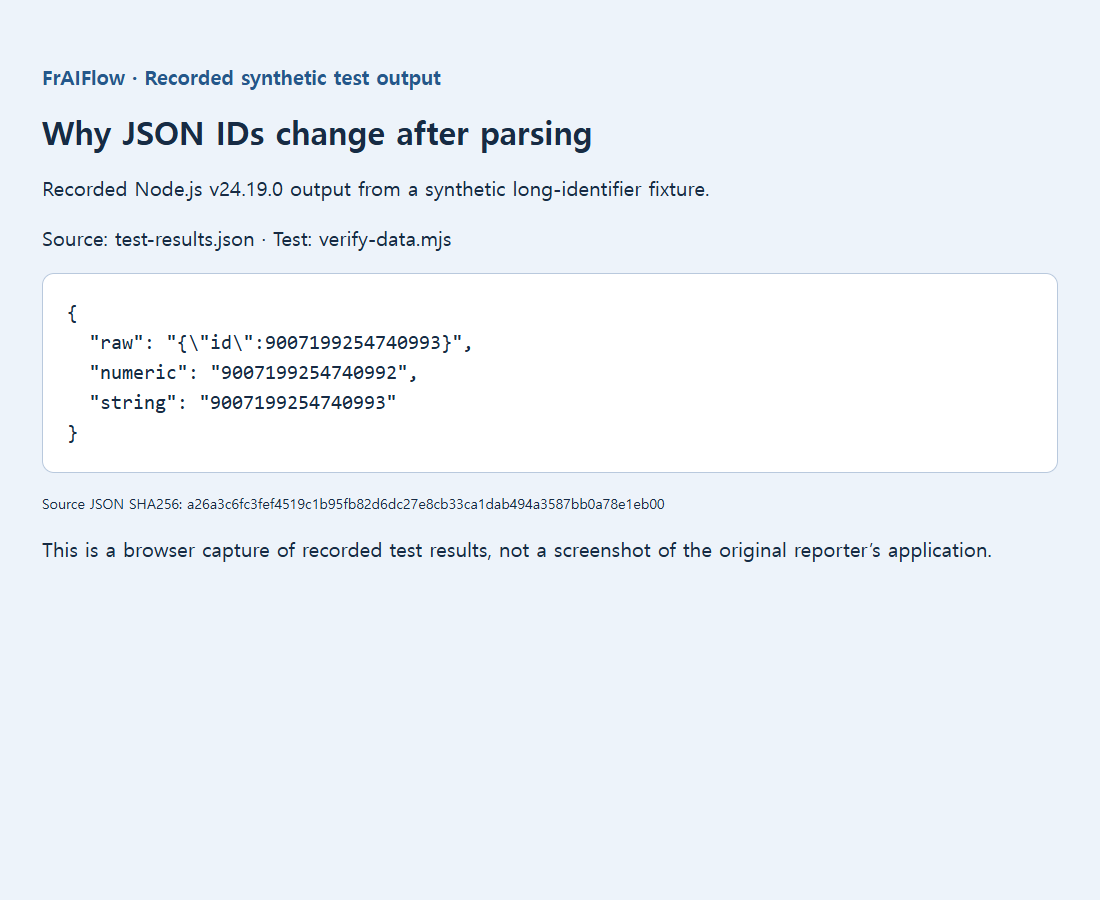
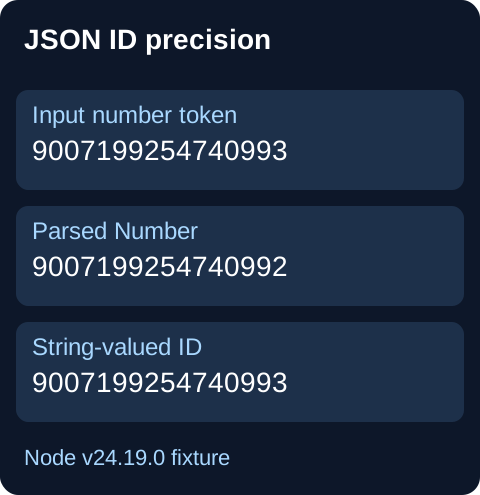
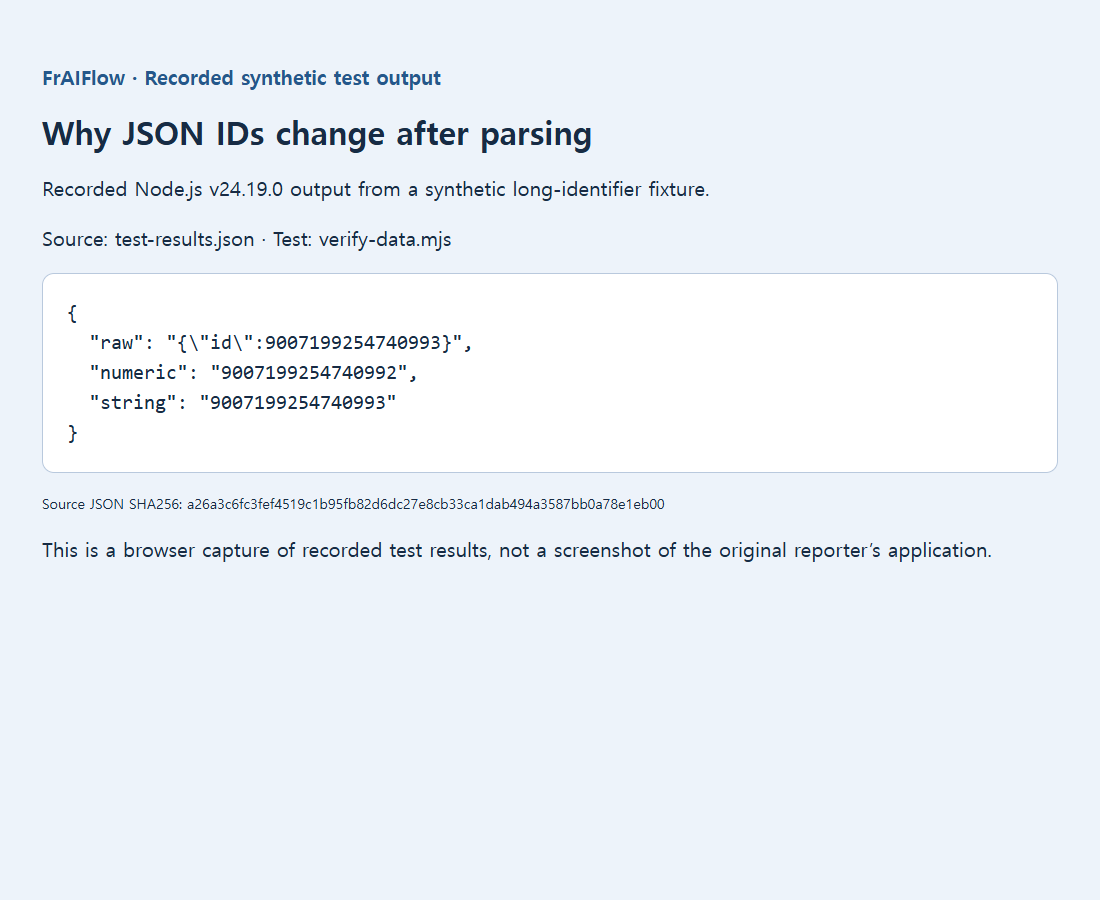
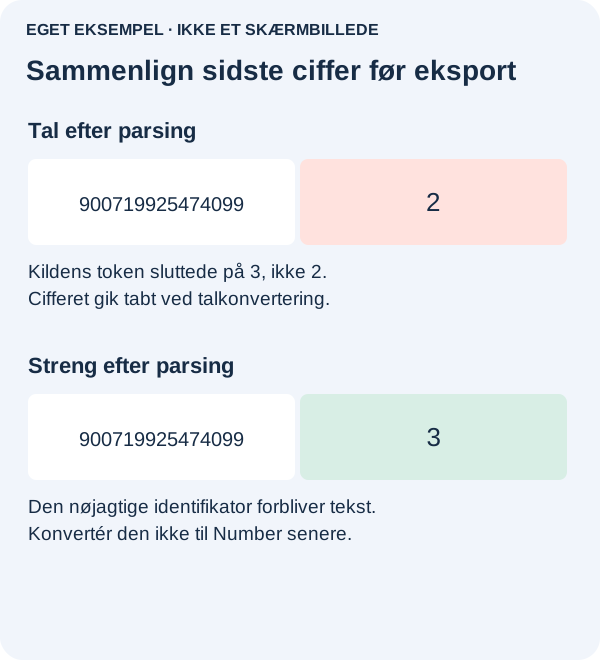
Offentlige rapporter beskriver, at JSON.parse ændrer store tal, og at Google Apps Script mister præcision. En gemt Node.js-test læste tallet 9007199254740993 som 9007199254740992, mens strengen i anførselstegn bevarede sine cifre. Dette kontrollerede resultat er ikke en test af et live-API eller FrAIFlows aktuelle formatteringsværktøj.
Ret overgangen, før du formaterer resultatet
Forestil dig, at et ordre-ID slutter på 993 i svaret, men på 992 efter import. Sammenlign først det urørte svar med det parsede objekt. Et formatteringsværktøj kan ikke reparere en værdi, der allerede er afrundet. Bevar den oprindelige svarfil, og undgå under undersøgelsen at åbne og gemme den igen gennem en anden numerisk importør.
const numeric = JSON.parse('{"id":9007199254740993}');
const exact = JSON.parse('{"id":"9007199254740993"}');
console.log(numeric.id); // 9007199254740992
console.log(exact.id);   // 9007199254740993
console.log(typeof exact.id); // string
For et ID er den anden repræsentation normalt den nyttige. Bed API-udbyderen sætte ID'et i anførselstegn, og kontrollér derefter alle aftagere: En senere Number(id) eller regnearksimport kan ophæve rettelsen. En kundekode bliver ikke til en mængde, blot fordi den indeholder cifre.
Hvis afsenderen ikke kan ændres, skal du ikke parse først og forsøge at reparere bagefter. En kildebevidst reviver kan læse det oprindelige token i understøttede runtimes. Eksemplet nedenfor håndterer bevidst kun et felt med navnet id; tilpas det til dit skema i stedet for at konvertere alle tal.
let supportsSource = false;
JSON.parse("1", (key, value, context) => {
  supportsSource = context?.source === "1";
  return value;
});
if (!supportsSource) throw new Error("Use a lossless JSON parser");
const record = JSON.parse('{"id":9007199254740993}',
  (key, value, context) => {
    if (key === "id" && typeof value === "number") {
      if (!context || !/^-?\d+$/.test(context.source)) {
        throw new Error("Expected a decimal integer ID");
      }
      return context.source; // Keep the exact token as a string.
    }
    return value;
  });
console.log(record.id === "9007199254740993"); // true
Kontrollér en værdi lige under og lige over grænsen for sikre heltal, og eksportér og genimportér derefter et eksempel. Hvert ciffer skal stemme med kilden. Hvis du har brug for regning og ikke identitet, skal du vælge en bevidst BigInt- eller decimalstrategi og beslutte, hvordan resultatet serialiseres. Omdan ikke et afrundet Number til BigInt i den tro, at den manglende præcision er vendt tilbage.
Hvad numerisk konvertering kan miste
En almindelig reviver modtager et Number efter parsing, for sent til at genskabe kasserede cifre. Den kildebevidste metode ovenfor afhænger af runtime-understøttelse og feltets skema. Hvis den ikke understøttes, skal du vælge en parser, der bevarer tokens. Sæt ikke anførselstegn omkring numeriske tokens med et bredt regulært udtryk: Det kan også påvirke indhold i strenge eller felter, som faktisk skal være numeriske.
Til regning skal BigInt oprettes fra den oprindelige decimalstreng, ikke fra et Number, der allerede er afrundet. Planlæg serialisering udtrykkeligt: Almindelig JSON.stringify serialiserer ikke BigInt-værdier direkte. Et visningsformat eller en rettelse af afsluttende nuller kan ikke genskabe den oprindelige identitet.