Varför JSON-ID:n ändras efter tolkning
En lång JSON-identifierare kan ändras innan formatteraren visar den. JavaScript Number kan inte representera alla heltal över 9007199254740991 exakt. Om en identifierare hamnar i den typen kan ett prydligt resultat redan innehålla andra siffror.
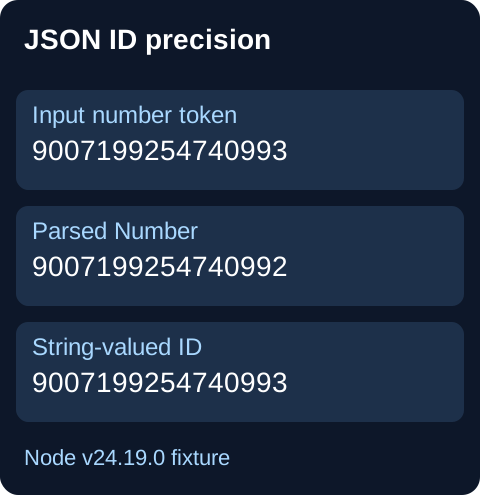
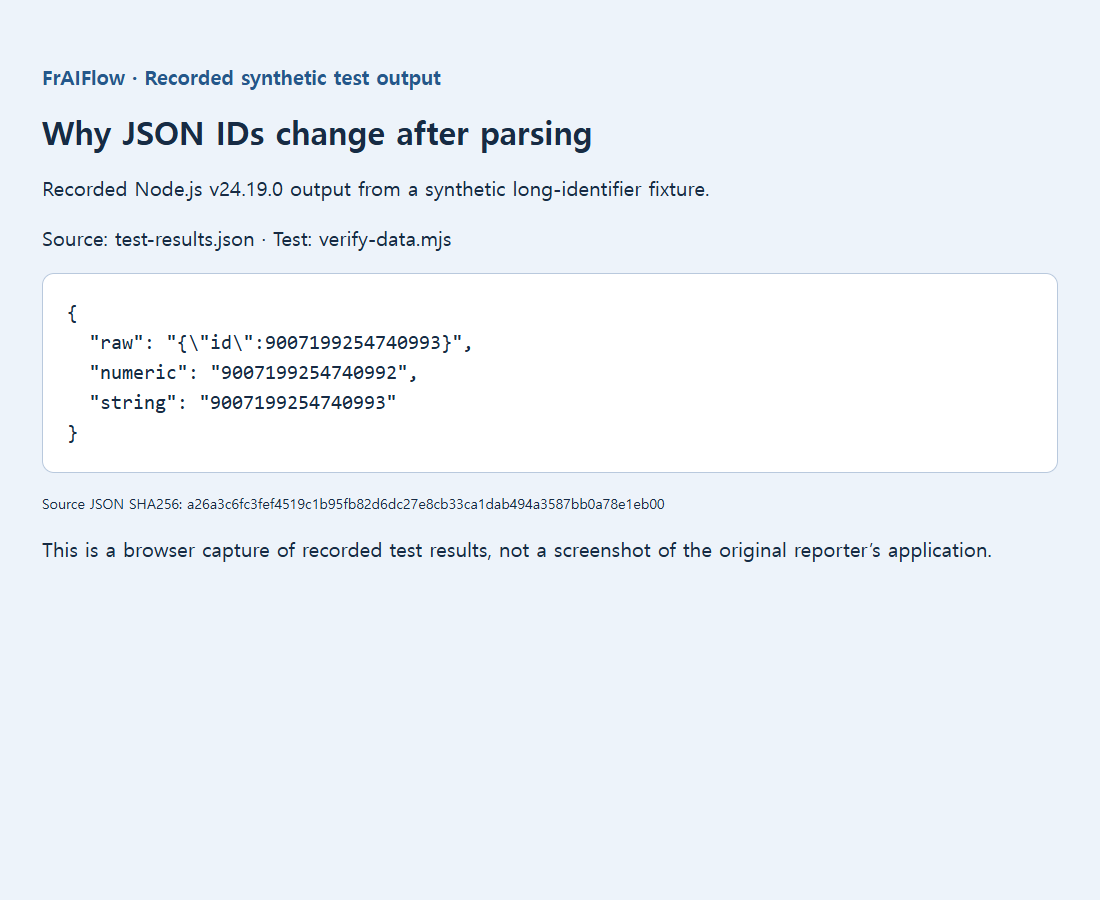
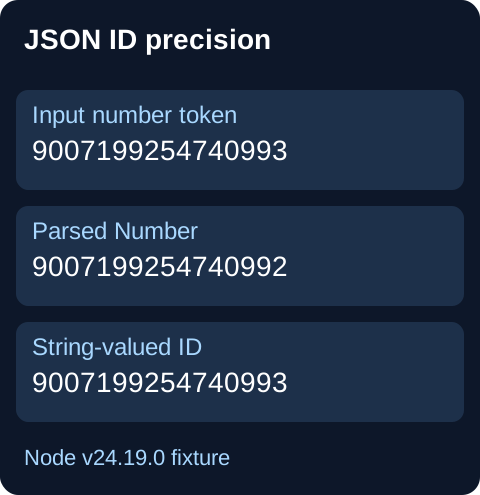
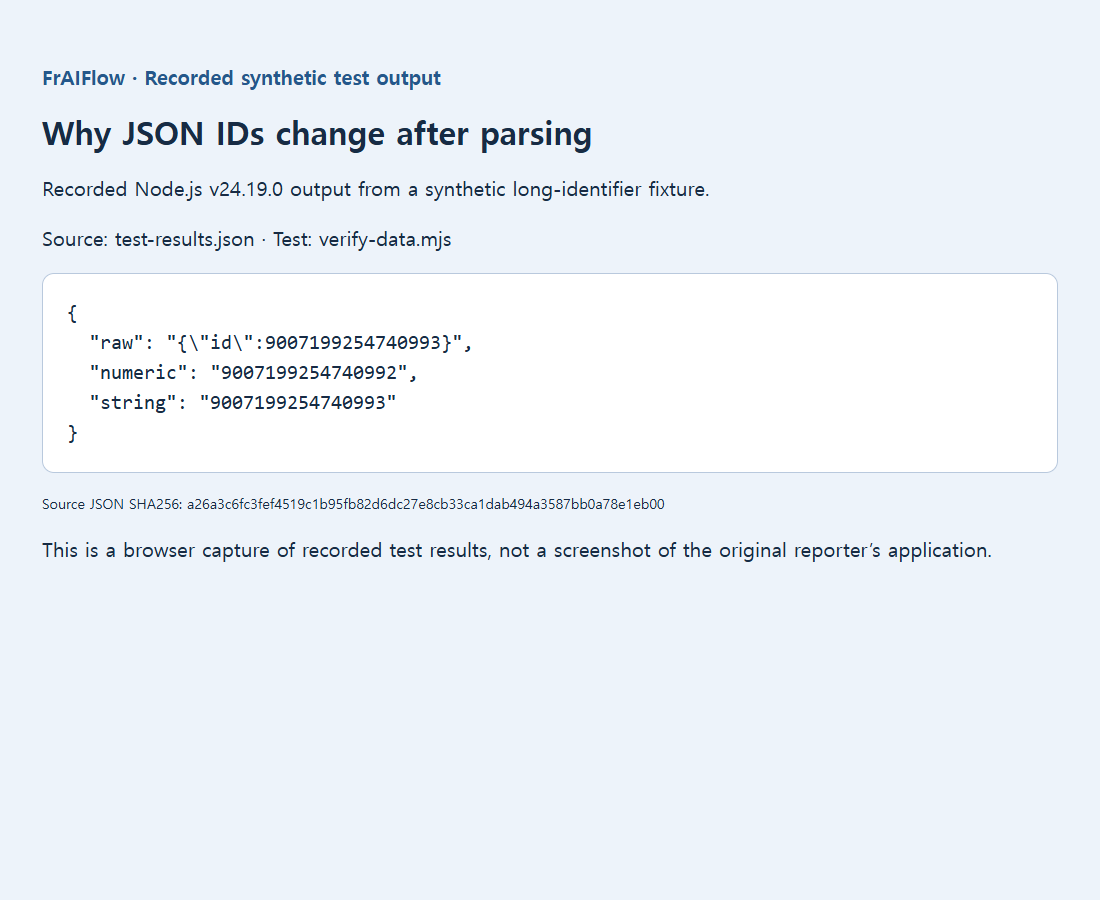
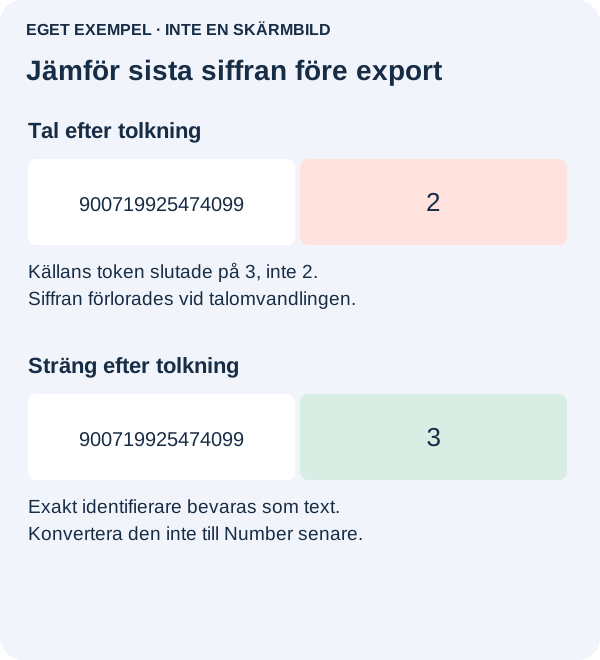
Offentliga rapporter beskriver hur JSON.parse ändrar stora tal och hur precision går förlorad i Google Apps Script. Ett sparat Node.js-test tolkade talet 9007199254740993 som 9007199254740992, medan den citerade strängen behöll sina siffror. Det kontrollerade resultatet är inte ett aktivt API-test eller ett test av FrAIFlows nuvarande formatterare.
Rätta gränsen innan du formaterar resultatet
Anta att ett order-ID slutar på 993 i svaret men på 992 efter import. Jämför först det orörda svaret med det tolkade objektet. Snygg utskrift kan inte reparera ett värde som redan avrundats. Bevara originalsvaret som fil och undvik att öppna och spara om det genom en annan numerisk importör under undersökningen.
const numeric = JSON.parse('{"id":9007199254740993}');
const exact = JSON.parse('{"id":"9007199254740993"}');
console.log(numeric.id); // 9007199254740992
console.log(exact.id);   // 9007199254740993
console.log(typeof exact.id); // string
För en identifierare är den andra representationen oftast användbar. Be API-producenten sätta ID:t inom citattecken och kontrollera sedan varje konsument: ett senare Number(id) eller en kalkylbladsimport kan förstöra rättningen. En kundkod blir inte en kvantitet bara för att den består av siffror.
Om producenten inte kan ändra ska du inte tolka först och försöka reparera sedan. En källmedveten reviver kan läsa originaltoken i körmiljöer som stöder det. Exemplet nedan hanterar avsiktligt bara ett fält med namnet id. Anpassa det till ditt schema i stället för att konvertera varje tal.
let supportsSource = false;
JSON.parse("1", (key, value, context) => {
  supportsSource = context?.source === "1";
  return value;
});
if (!supportsSource) throw new Error("Use a lossless JSON parser");
const record = JSON.parse('{"id":9007199254740993}',
  (key, value, context) => {
    if (key === "id" && typeof value === "number") {
      if (!context || !/^-?\d+$/.test(context.source)) {
        throw new Error("Expected a decimal integer ID");
      }
      return context.source; // Keep the exact token as a string.
    }
    return value;
  });
console.log(record.id === "9007199254740993"); // true
Verifiera ett värde strax under och strax över gränsen för säkra heltal, exportera sedan och återimportera ett exempel. Varje siffra ska stämma med källan. Om du behöver aritmetik snarare än identitet använder du en genomtänkt BigInt- eller decimalstrategi och bestämmer hur resultatet ska serialiseras. Omvandla inte ett avrundat Number till BigInt och anta att den saknade precisionen har återkommit.
Vad numerisk konvertering kan förlora
En vanlig reviver får ett Number efter tolkningen, för sent för att återställa bortkastade siffror. Den källmedvetna vägen ovan beror på körmiljöns stöd och fältets schema. Om stödet saknas väljer du en parser som bevarar token. Sätt inte numeriska token inom citattecken med ett brett reguljärt uttryck: det kan också påverka citerat innehåll eller fält som verkligen ska vara numeriska.
För aritmetik skapar du BigInt från den ursprungliga decimalsträngen, inte från ett redan avrundat Number. Planera serialiseringen uttryckligen: vanlig JSON.stringify serialiserar inte BigInt direkt. Ett visningsformat eller tillagda nollor kan inte återställa den ursprungliga identiteten.