JSON 解析後,為什麼識別碼的數字變了?
很長的 JSON 識別碼,可能在格式化工具顯示之前就已經改變。JavaScript Number 無法精確表示所有大於 9007199254740991 的整數。一旦識別碼被轉成這種型別,即使輸出看起來整齊,裡面的數字也可能早已不是原值。
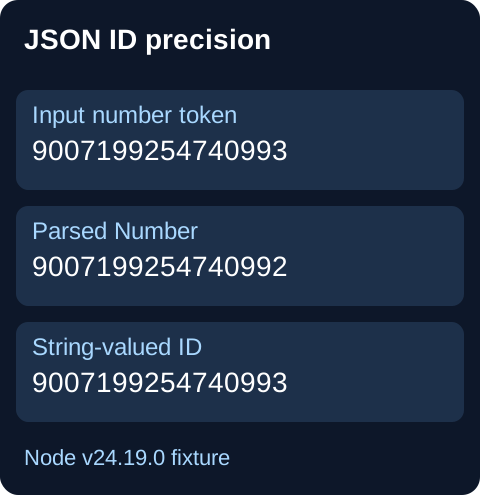
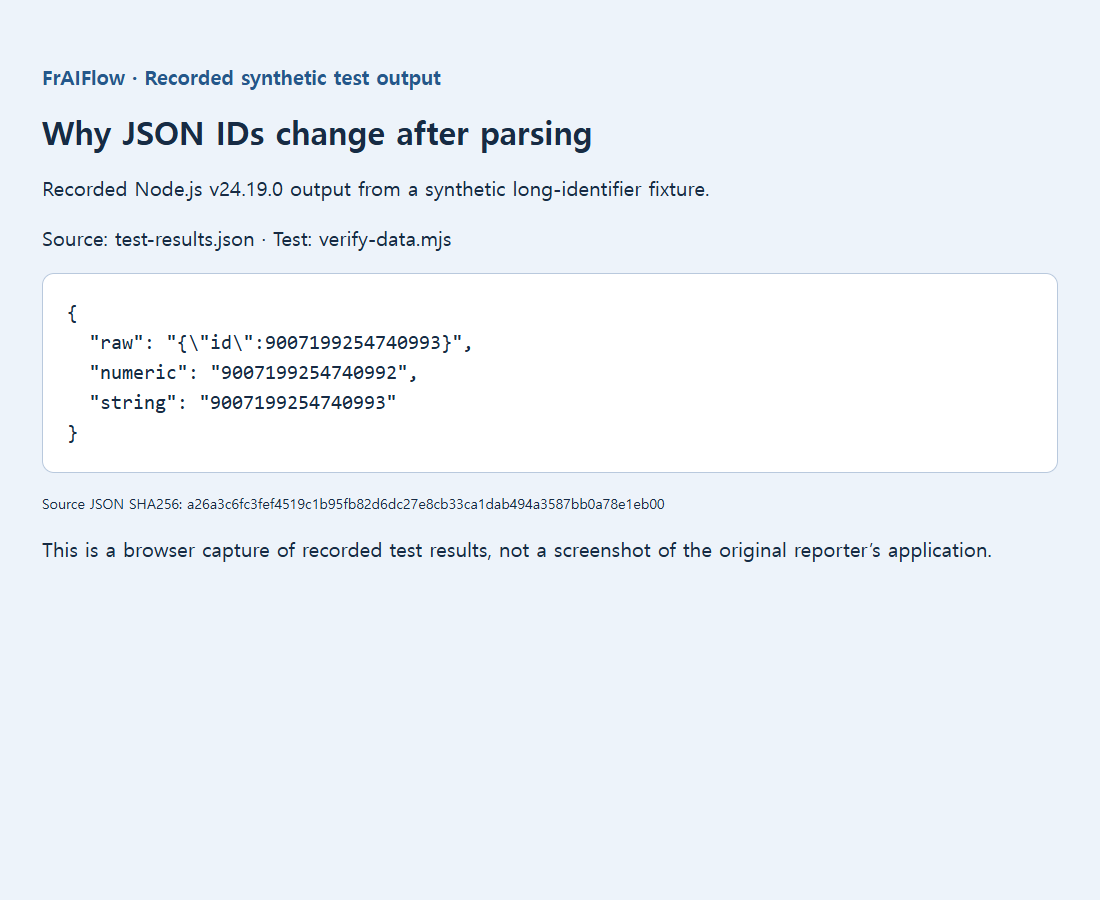
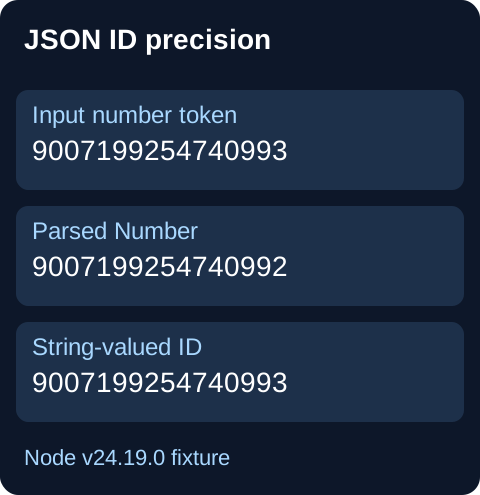
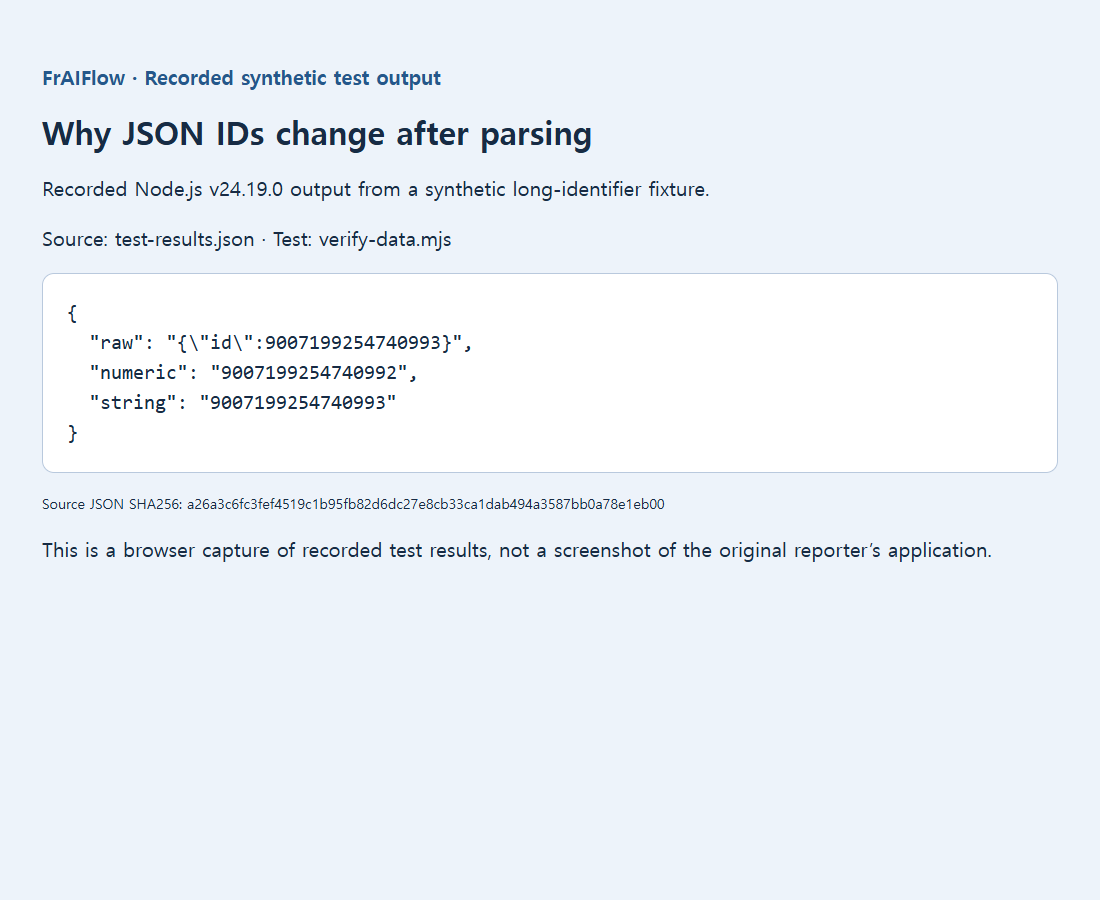
公開討論中有 JSON.parse 改變大數值,以及 Google Apps Script 遺失精度的案例。保存的 Node.js 測試把數值 9007199254740993 解析成 9007199254740992;加上引號的字串則保留了所有數字。這是受控測試,不是即時 API 或目前 FrAIFlow 格式化工具的測試。
先修正資料型別邊界,再處理輸出格式
假設回應中的訂單編號最後是 993,匯入後卻變成 992,請先比對未經處理的原始回應與解析後的物件。美化排版工具無法修好已因精度限制而改變的值。請保留原始回應檔,調查時也不要再透過其他會轉換數值的匯入工具開啟並另存。
const numeric = JSON.parse('{"id":9007199254740993}');
const exact = JSON.parse('{"id":"9007199254740993"}');
console.log(numeric.id); // 9007199254740992
console.log(exact.id);   // 9007199254740993
console.log(typeof exact.id); // string
如果這個欄位是識別碼,第二種表示方式通常更合適。請 API 產生端把 ID 加上引號,並檢查所有接收程式:後續的 Number(id) 或試算表匯入都可能讓修正失效。客戶代碼即使全部由數字組成,也不代表它是需要計算的數量。
若無法修改產生端,不要先解析,再試著修復。支援來源文字的 reviver 可在相容執行環境中讀取原始數值詞元。下例刻意只處理名為 id 的欄位;請依資料結構調整,不要把每個數值都一律轉換。
let supportsSource = false;
JSON.parse("1", (key, value, context) => {
  supportsSource = context?.source === "1";
  return value;
});
if (!supportsSource) throw new Error("Use a lossless JSON parser");
const record = JSON.parse('{"id":9007199254740993}',
  (key, value, context) => {
    if (key === "id" && typeof value === "number") {
      if (!context || !/^-?\d+$/.test(context.source)) {
        throw new Error("Expected a decimal integer ID");
      }
      return context.source; // Keep the exact token as a string.
    }
    return value;
  });
console.log(record.id === "9007199254740993"); // true
請測試略低於與略高於安全整數界線的值,再將範例匯出並重新匯入。每一位數字都必須和來源一致。如果需要的是運算,而非識別用途,就要明確選擇 BigInt 或十進位數值策略,並決定輸出的序列化方式。不要把已失去精度的 Number 轉成 BigInt,就以為失去的精度回來了。
數值轉換會遺失哪些資訊?
一般 reviver 在解析後才收到 Number,已經來不及復原被捨棄的數字。上方保留來源的做法取決於執行環境支援與欄位結構;若不支援,請選擇能保留原始詞元的解析器。不要用過於寬泛的正規表示式為數值加引號,因為這也可能影響原本已在引號內的內容,或真正應保持數值的欄位。
需要運算時,應由原始十進位字串建立 BigInt,不要從已失去精度的 Number 建立。序列化方式也要事先安排:一般 JSON.stringify 無法直接序列化 BigInt。調整顯示格式或補上尾端的零,都無法復原原始識別碼。