Compter les emojis sans couper un caractère visible en deux
Un utilisateur saisit un emoji, mais le compteur en annonce deux. Un autre emoji est tronqué et devient un symbole cassé. Le problème vient souvent de l’unité comptée, pas d’une saisie corrompue : length en JavaScript mesure des unités de code UTF-16, tandis que le lecteur perçoit des groupes de graphèmes.
Définissez ce que votre compteur promet
Un champ de légende qui annonce « un caractère restant » ne devrait pas refuser un simple pouce levé parce que son code compte deux unités UTF-16. En revanche, un service de stockage peut réellement imposer une limite en octets. Ce sont deux contraintes différentes. Avant de changer le code, déterminez si la limite concerne un libellé lu par une personne, une colonne de base de données ou une API tierce. Modifier seulement le compteur peut laisser l’enregistrement échouer ensuite.
Pour le texte visible, le graphème est généralement un bon point de départ : une lettre et son accent combinant, ou un emoji et son modificateur, restent ensemble. Il ne mesure pas la largeur à l’écran. Un emoji familial et une lettre étroite peuvent compter chacun pour un graphème tout en occupant des espaces très différents.
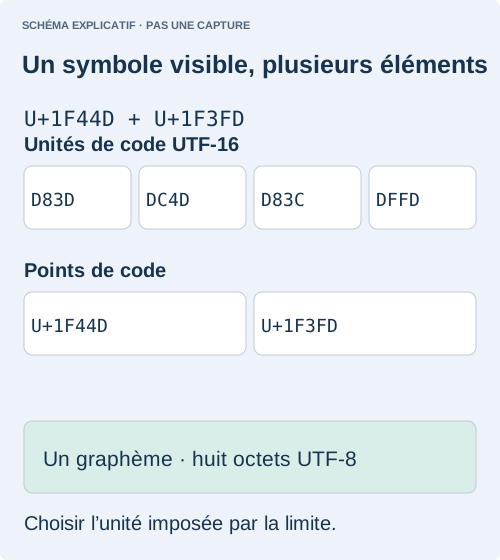
Une question publique de 2016 demandait pourquoi un pouce levé avait une longueur de 2. Ce caractère utilise une paire de surrogates. Décomposer la chaîne avec l’opérateur de décomposition compte les points de code, ce qui corrige cet exemple simple, mais pas les teintes de peau, les drapeaux ou les familles reliées.
const text = "👍🏽";
const s = new Intl.Segmenter("en", { granularity: "grapheme" });
text.length;                      // 4 code units
[...text].length;                 // 2 code points
[...s.segment(text)].length;      // 1 grapheme
new TextEncoder().encode(text).length; // 8 UTF-8 bytes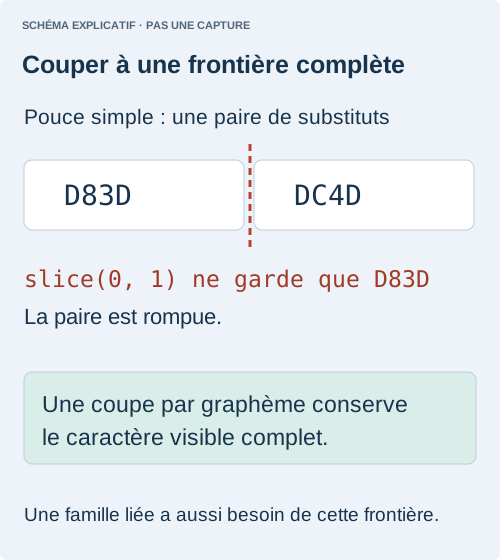
Coupez uniquement entre des caractères visibles complets
function truncate(text, maximum) {
  if (!Number.isInteger(maximum) || maximum < 0)
    throw new RangeError("Use a nonnegative integer");
  const s = new Intl.Segmenter(undefined, { granularity: "grapheme" });
  let result = "", count = 0;
  for (const item of s.segment(text)) {
    if (count++ >= maximum) break;
    result += item.segment;
  }
  return result;
}
Cette méthode conserve le début de la chaîne sans construire un tableau de tous les segments. Décidez séparément si les points de suspension consomment une partie de la limite. Une découpe en unités de code peut laisser une demi-paire de surrogates ; une découpe en points de code peut encore séparer les éléments d’un emoji composé.
Essayez la fonction de troncature de cette section avec un court exemple mixte comme A👍🏽B. Conserver deux graphèmes doit garder A👍🏽, pas un pouce dont la teinte de peau a disparu. Essayez ensuite un accent combinant et une famille reliée. L’objectif est de vérifier où se produit la coupure. Une fonction peut compter correctement une chaîne entière alors qu’un autre endroit de l’interface la coupe mal.
const sample = "A👍🏽B";
console.log(truncate(sample, 0)); // ""
console.log(truncate(sample, 1)); // "A"
console.log(truncate(sample, 2)); // "A👍🏽"
console.log(truncate(sample, 3)); // "A👍🏽B"
Ce sont des résultats attendus pour un environnement prenant en charge la segmentation en graphèmes, pas de nouvelles preuves de tests navigateur. Vérifiez cette prise en charge avant de promettre ce comportement. Si Intl.Segmenter n’est pas disponible, ne le remplacez pas discrètement par une décomposition suivie d’une découpe en prétendant offrir la même garantie. Conservez la saisie et expliquez la limite, ou utilisez une implémentation de segmentation examinée séparément.
Gardez la saisie et l’enregistrement cohérents
Dans un champ interactif, mettez à jour le compteur sans réécrire la valeur à chaque frappe. Certaines méthodes de saisie composent un caractère à partir de plusieurs frappes ; une troncature agressive pendant cette composition peut gêner la saisie. Il est plus prudent d’afficher le compte, de signaler le dépassement et de laisser l’utilisateur corriger avant d’enregistrer. Si vous créez un libellé raccourci, gardez le texte original complet accessible ailleurs.
Décidez si les points de suspension ajoutés font partie de la limite. Pour un aperçu de cinq graphèmes incluant ce signe, réservez-lui une place au lieu de conserver cinq graphèmes et d’en ajouter un sixième. N’appliquez pas une limite de caractères visibles à une API limitée en octets en supposant que cela suffira : l’emoji avec teinte de peau ci-dessus compte un graphème, mais huit octets UTF-8.
Avant publication, comparez compteur, aperçu raccourci et valeur enregistrée avec les mêmes exemples. Si le serveur applique une autre règle de comptage, documentez-la et validez selon cette règle. Une gestion par graphèmes évite les mauvaises coupures ; elle ne normalise pas l’orthographe, ne garantit pas la disponibilité d’une police et ne définit pas les règles d’un autre service.
Ce que démontrent les exemples enregistrés
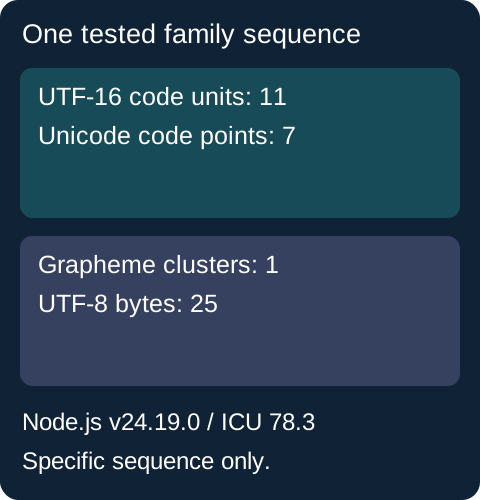
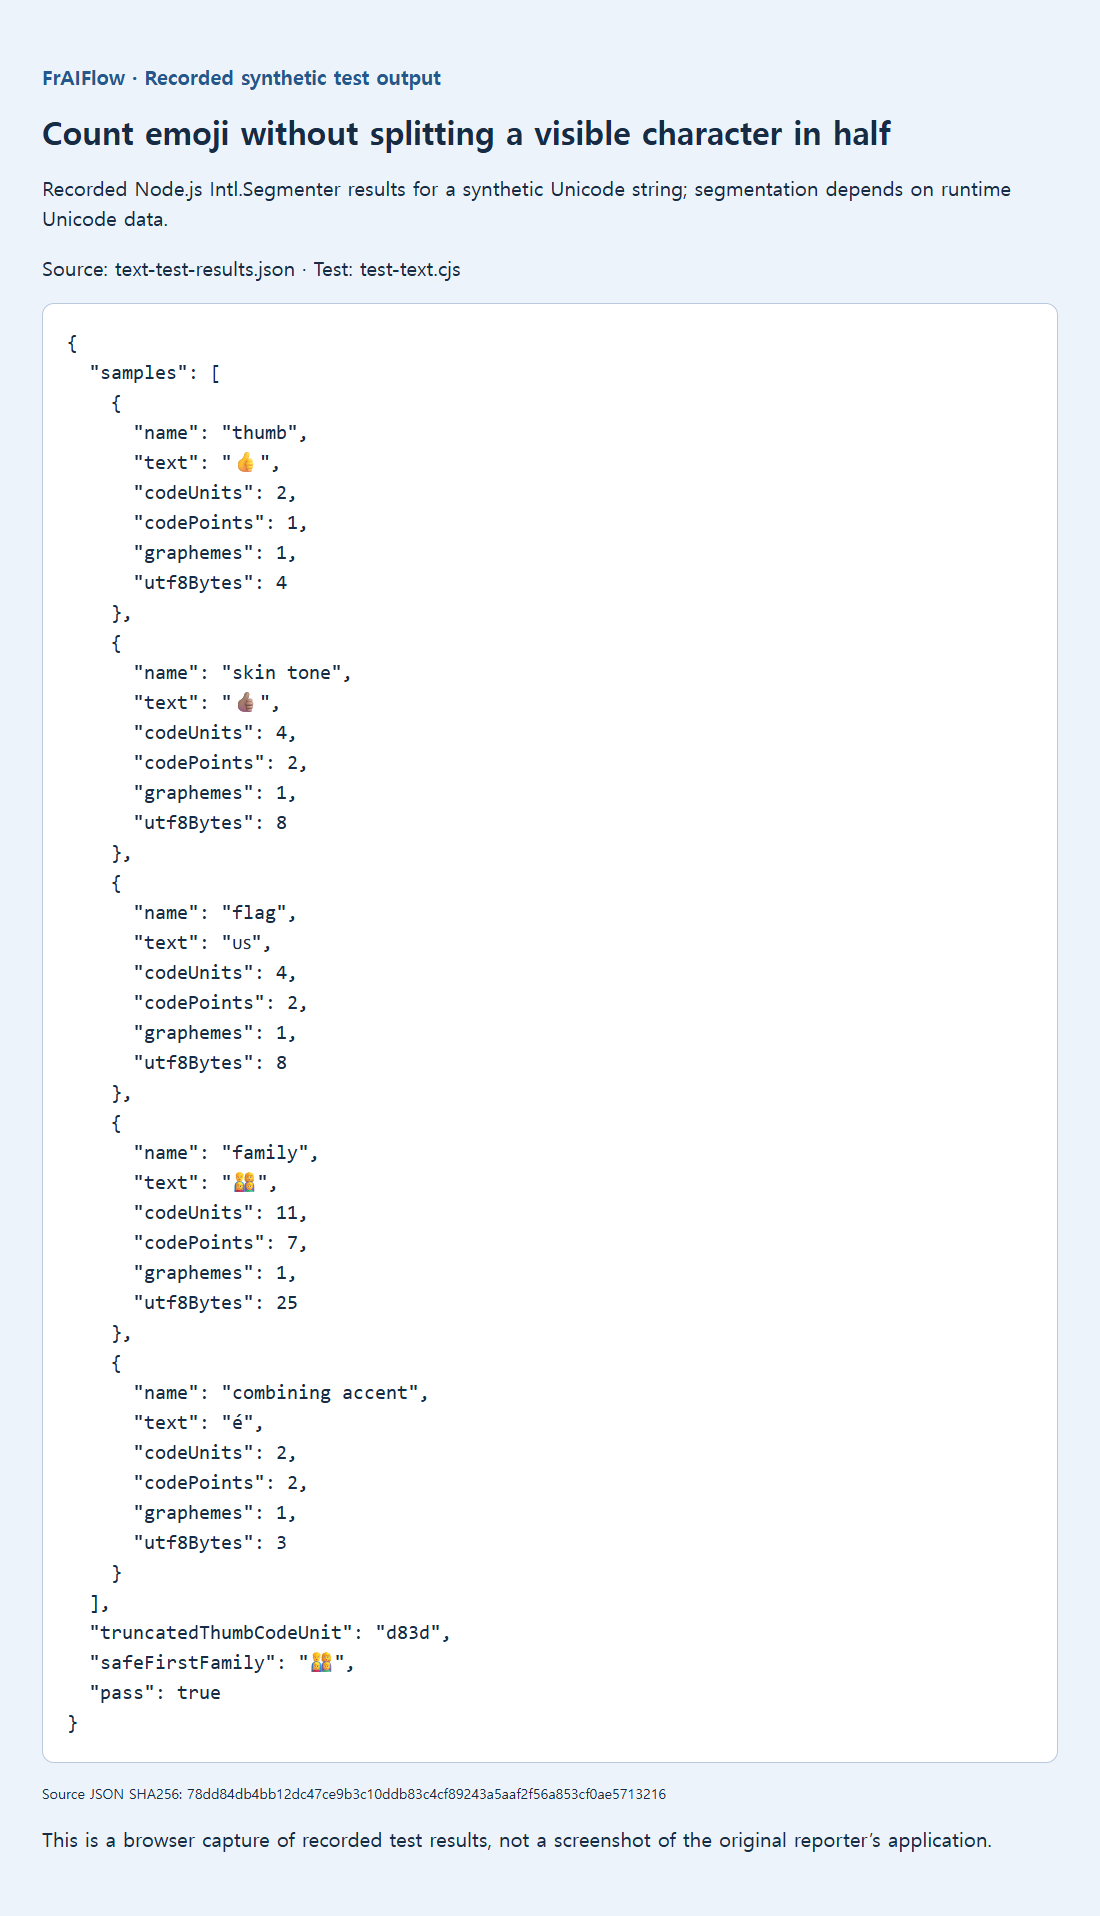
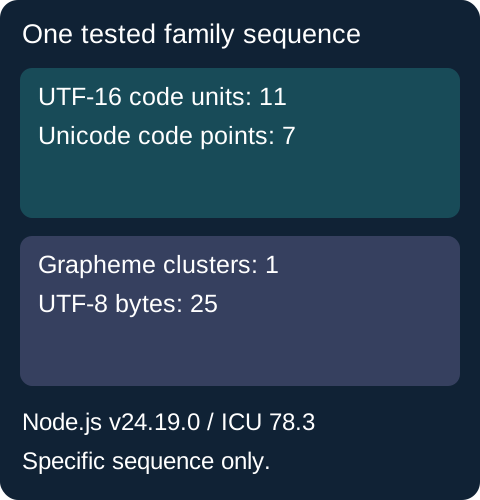
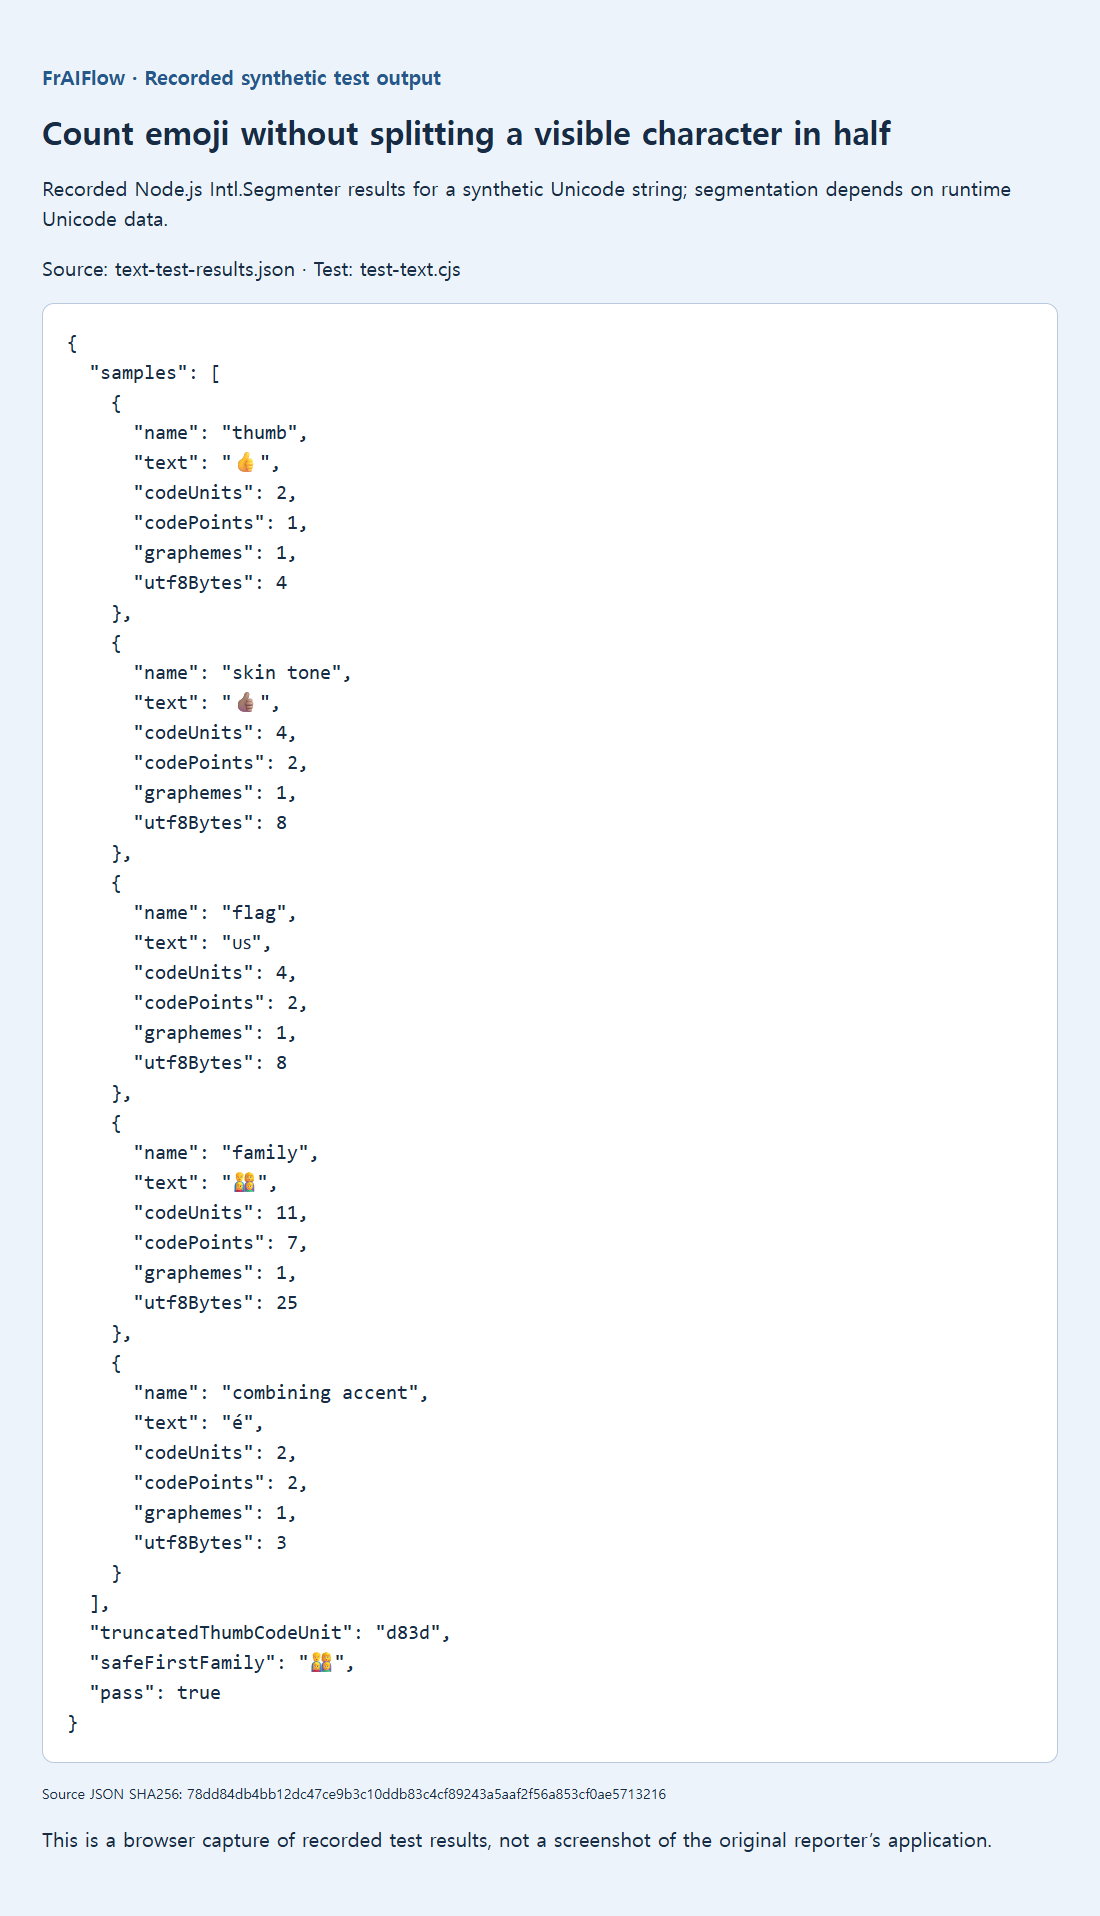
Les tests conservés sous Node v24.19.0 / ICU 78.3 couvraient un pouce levé, une séquence avec teinte de peau, un drapeau, une famille reliée et un accent combinant. Chacun formait un graphème. La famille occupait 11 unités de code et 7 points de code ; couper le pouce simple à une unité laissait D83D, un surrogate haut isolé.