Tell emoji uten å dele et synlig tegn i to
En bruker skriver én emoji, men telleren viser to. En annen emoji kuttes til et ødelagt symbol. Problemet er ofte enheten som telles, ikke skadde inndata: JavaScripts length måler UTF-16-kodeenheter, mens leseren ser grafemklynger.
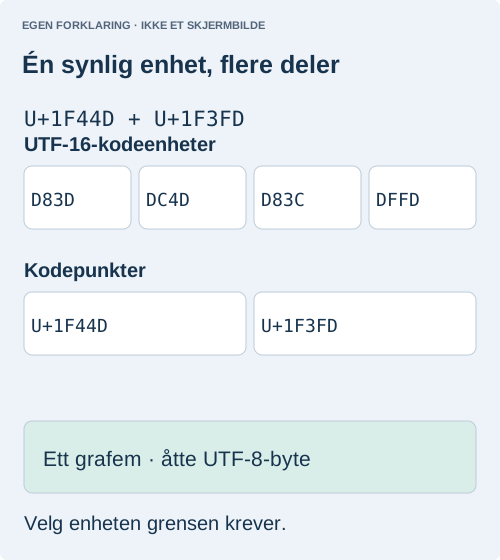
Bestem hva telleren lover
Et bildetekstfelt som sier «ett tegn igjen», bør ikke avvise én tommel opp bare fordi implementasjonen teller to UTF-16-enheter. Men en lagringstjeneste kan faktisk ha en bytegrense. Dette er forskjellige krav. Før du endrer koden, avklarer du om grensen gjelder en brukerrettet etikett, en databasekolonne eller et tredjeparts-API. Endrer du bare telleren, kan lagringen fortsatt feile senere.
For synlig tekst er et grafem vanligvis et nyttig utgangspunkt: En bokstav med kombinerende aksent eller en emoji med modifikator holdes samlet. Det måler ikke skjermbredde. Én familieemoji og én smal bokstav kan hver telle som ett grafem, men oppta svært ulik plass.
Et offentlig spørsmål fra 2016 spurte hvorfor en tommel opp hadde length 2. Tegnet bruker et surrogatpar. Å spre strengen teller kodepunkter og retter dette enkle eksemplet, men ikke hudtoner, flagg eller sammenkoblede familier.
const text = "👍🏽";
const s = new Intl.Segmenter("en", { granularity: "grapheme" });
text.length;                      // 4 code units
[...text].length;                 // 2 code points
[...s.segment(text)].length;      // 1 grapheme
new TextEncoder().encode(text).length; // 8 UTF-8 bytes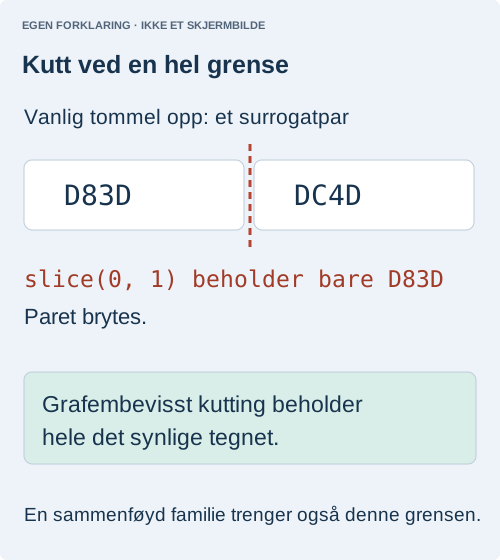
Kutt bare etter et helt synlig tegn
function truncate(text, maximum) {
  if (!Number.isInteger(maximum) || maximum < 0)
    throw new RangeError("Use a nonnegative integer");
  const s = new Intl.Segmenter(undefined, { granularity: "grapheme" });
  let result = "", count = 0;
  for (const item of s.segment(text)) {
    if (count++ >= maximum) break;
    result += item.segment;
  }
  return result;
}
Dette beholder starten av strengen uten å bygge en liste med alle segmentene. Bestem separat om et utelatelsestegn bruker av grensen. Kutting etter kodeenheter kan etterlate et halvt surrogatpar. Kutting etter kodepunkter kan fortsatt dele en sammensatt emoji.
Bruk avkortingsfunksjonen i denne delen med et kort blandet eksempel som A👍🏽B. Når du beholder to grafemer, skal resultatet være A👍🏽, ikke en tommel der hudtonen er borte. Prøv deretter en kombinerende aksent og en sammenkoblet familie. Poenget er å teste hvor kuttet skjer. En funksjon kan telle en full streng riktig, men likevel kutte den feil et annet sted i grensesnittet.
const sample = "A👍🏽B";
console.log(truncate(sample, 0)); // ""
console.log(truncate(sample, 1)); // "A"
console.log(truncate(sample, 2)); // "A👍🏽"
console.log(truncate(sample, 3)); // "A👍🏽B"
Dette er forventede eksempler for et kjøremiljø med støtte for grafemsegmentering, ikke ny dokumentasjon fra nettlesertester. Kontroller støtten før du tilbyr funksjonen. Hvis Intl.Segmenter ikke finnes, må du ikke i stillhet erstatte den med spredning og slice og hevde samme garanti. Behold brukerens inndata og forklar begrensningen, eller bruk en segmenteringsimplementasjon som er gjennomgått separat.
La redigering og lagring følge samme regler
I et aktivt tekstfelt oppdaterer du telleren uten å skrive om verdien for hvert tastetrykk. Noen inndatametoder setter sammen flere tastetrykk til ett tegn. Aggressiv avkorting under denne prosessen kan forstyrre skrivingen. En tryggere løsning er å vise antallet, forklare en overskridelse og la brukeren redigere før lagring. Lager du en forkortet visningsetikett, bør den fullstendige originalteksten være tilgjengelig et annet sted.
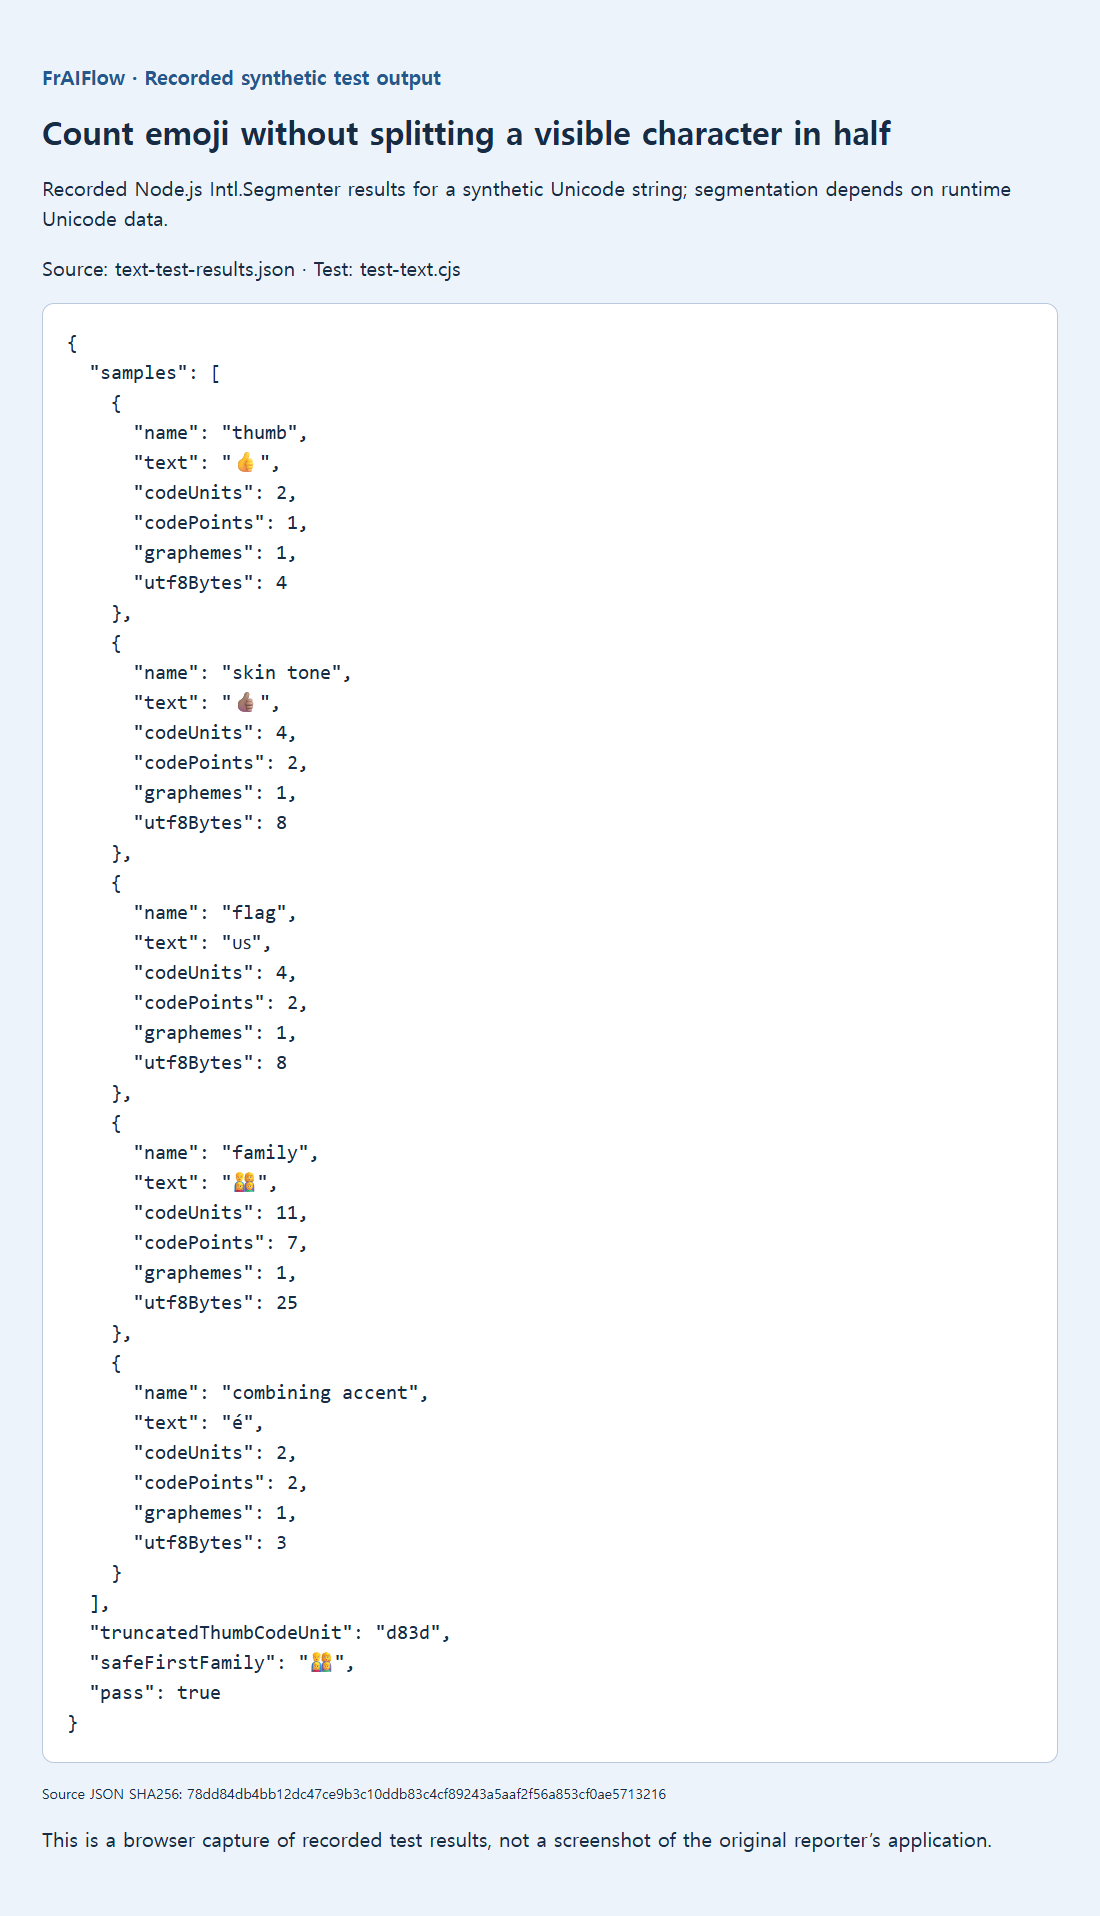
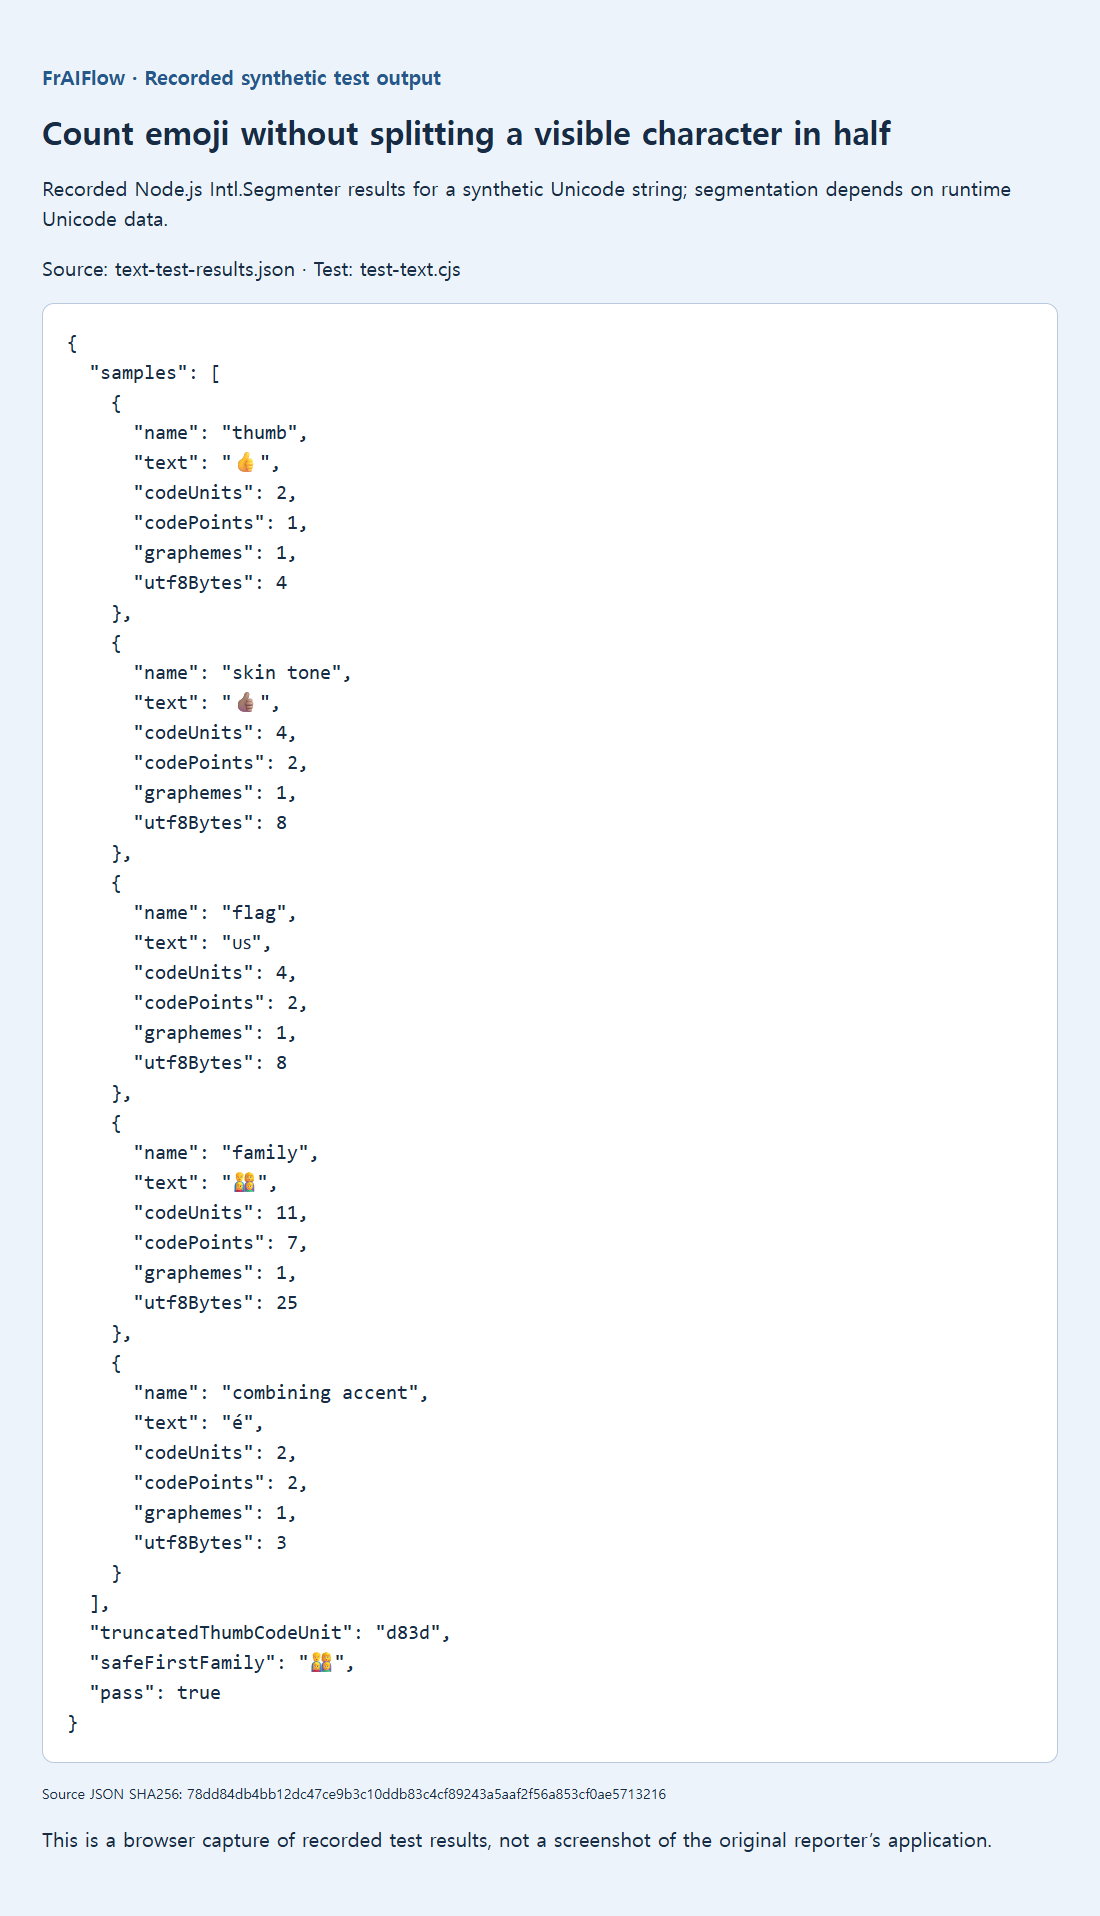
Bestem om et ekstra utelatelsestegn skal være innenfor grensen. For en forhåndsvisning på fem grafemer inkludert utelatelsestegn må du reservere plass til tegnet, ikke beholde fem og legge til et sjette. Ikke bruk en grense for synlige tegn mot et bytebegrenset API og forvent at teksten passer. Hudtoneeksemplet over er ett grafem, men åtte UTF-8-byte.
Før publisering sammenligner du telleren, den forkortede forhåndsvisningen og den lagrede verdien med samme eksempelsett. Har bakenden andre telleregler, dokumenterer du dem og validerer mot dem. Grafembevisst håndtering hindrer ødelagte kutt. Den normaliserer ikke stavemåter, garanterer ikke skriftstøtte og bestemmer ikke reglene til en annen tjeneste.
Hva de registrerte eksemplene viser
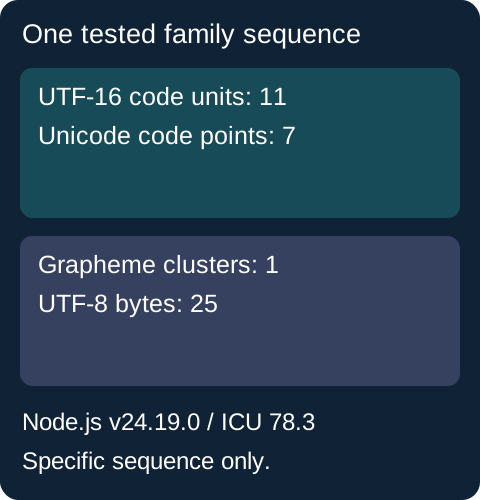
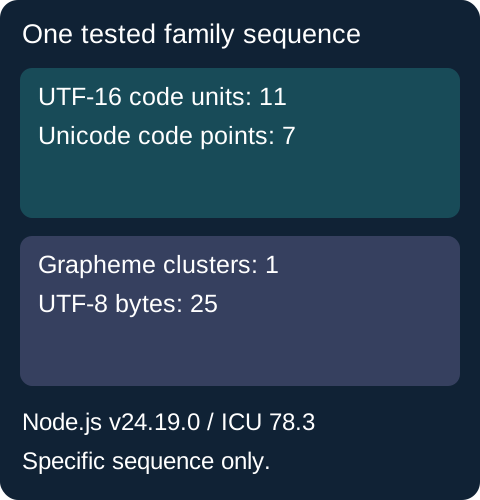
De bevarte testene med Node v24.19.0 / ICU 78.3 omfattet en tommel opp, en hudtonesekvens, et flagg, en sammenkoblet familie og en kombinerende aksent. Hver var ett grafem. Familien brukte 11 kodeenheter og 7 kodepunkter. Da vanlig tommel opp ble kuttet til én enhet, sto D83D igjen, et uparet høyt surrogat.