計算 emoji 長度,別把可見字元切成兩半
使用者只輸入一個 emoji,計數器卻顯示兩個;另一個 emoji 還被截成破碎符號。問題通常不是輸入壞掉,而是計數單位不同:JavaScript length 計算 UTF-16 碼元,讀者看到的則是字素叢集。
先決定計數器承諾的是什麼
標示「還能輸入一個字元」的說明欄,不應只因實作把拇指 emoji 算成兩個 UTF-16 單位,就拒絕這個符號。但儲存服務也可能確實有位元組上限。兩者是不同需求。改程式前,先確認限制是針對讀者看到的標籤、資料庫欄位,還是第三方 API。只改畫面計數,可能讓儲存時繼續失敗。
對可見文字,字素通常是合理起點:字母與組合重音,或 emoji 與修飾符會留在一起。但它不是畫面寬度的單位。一個家庭 emoji 和一個窄字母,都可能是一個字素,實際占用寬度卻差很多。
2016 年一則公開問題詢問,為什麼拇指符號長度是 2。這個字元使用代理對。將字串展開可以計算碼位,解決這個簡單範例,但不能完整處理膚色、旗幟或連接的家庭 emoji。
const text = "👍🏽";
const s = new Intl.Segmenter("en", { granularity: "grapheme" });
text.length;                      // 4 code units
[...text].length;                 // 2 code points
[...s.segment(text)].length;      // 1 grapheme
new TextEncoder().encode(text).length; // 8 UTF-8 bytes
只在完整的可見字元之間截斷
function truncate(text, maximum) {
  if (!Number.isInteger(maximum) || maximum < 0)
    throw new RangeError("Use a nonnegative integer");
  const s = new Intl.Segmenter(undefined, { granularity: "grapheme" });
  let result = "", count = 0;
  for (const item of s.segment(text)) {
    if (count++ >= maximum) break;
    result += item.segment;
  }
  return result;
}
這個方法保留字串開頭,不必先建立所有分段的陣列。省略號是否占用限制,要另外決定。依碼元切割可能留下半個代理對;依碼位切割仍可能切開連接的 emoji。
使用本節截斷函式,測試像 A👍🏽B 這樣的簡短混合範例。保留兩個字素時應留下 A👍🏽,而不是遺失膚色的普通拇指。接著測試組合重音與連接的家庭 emoji,重點是確認切割發生在哪裡。函式可能正確計算完整字串,介面其他地方卻仍切錯。
const sample = "A👍🏽B";
console.log(truncate(sample, 0)); // ""
console.log(truncate(sample, 1)); // "A"
console.log(truncate(sample, 2)); // "A👍🏽"
console.log(truncate(sample, 3)); // "A👍🏽B"
這些是支援字素分段之執行環境的預期範例,不是新的瀏覽器測試證據。提供功能前請檢查支援程度。如果 Intl.Segmenter 不可用,不要偷偷換成展開再切割的備用方法,卻宣稱提供相同保證。應保留使用者輸入並說明限制,或使用另外經過檢閱的分段實作。
讓編輯與儲存遵循同一套規則
即時文字欄位應更新計數,不要每次按鍵都重寫輸入值。有些輸入法會將多次按鍵組成一個字元,組字期間過度截斷可能干擾輸入。較安全的互動是顯示計數、說明超限,讓使用者在儲存前修改。如果產生縮短的顯示標籤,請在其他地方保留完整原文。
也要決定省略號是否包含在上限內。如果預覽上限五個字素且包含省略號,就應預留該位置,而不是保留五個再加上第六個。對位元組限制的 API,不能只靠可見字元限制就期待一定放得下:上方膚色範例只有一個字素,卻有八個 UTF-8 位元組。
發佈前,以相同範例比較計數器、縮短預覽與儲存值。後端若採用不同計數政策,應記錄並依該政策驗證。字素處理可避免切壞字元,但不會正規化拼字、保證字型支援,或替其他服務定義規則。
保存的範例證明了什麼?
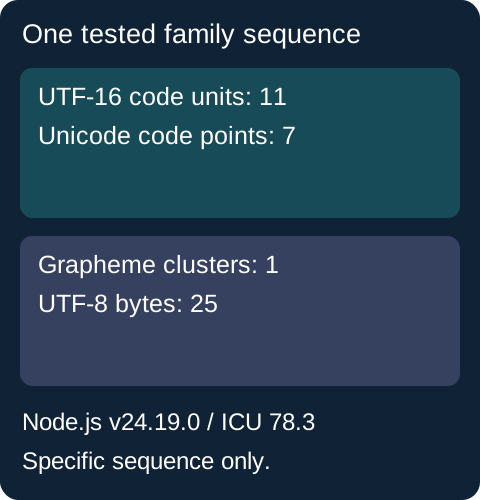
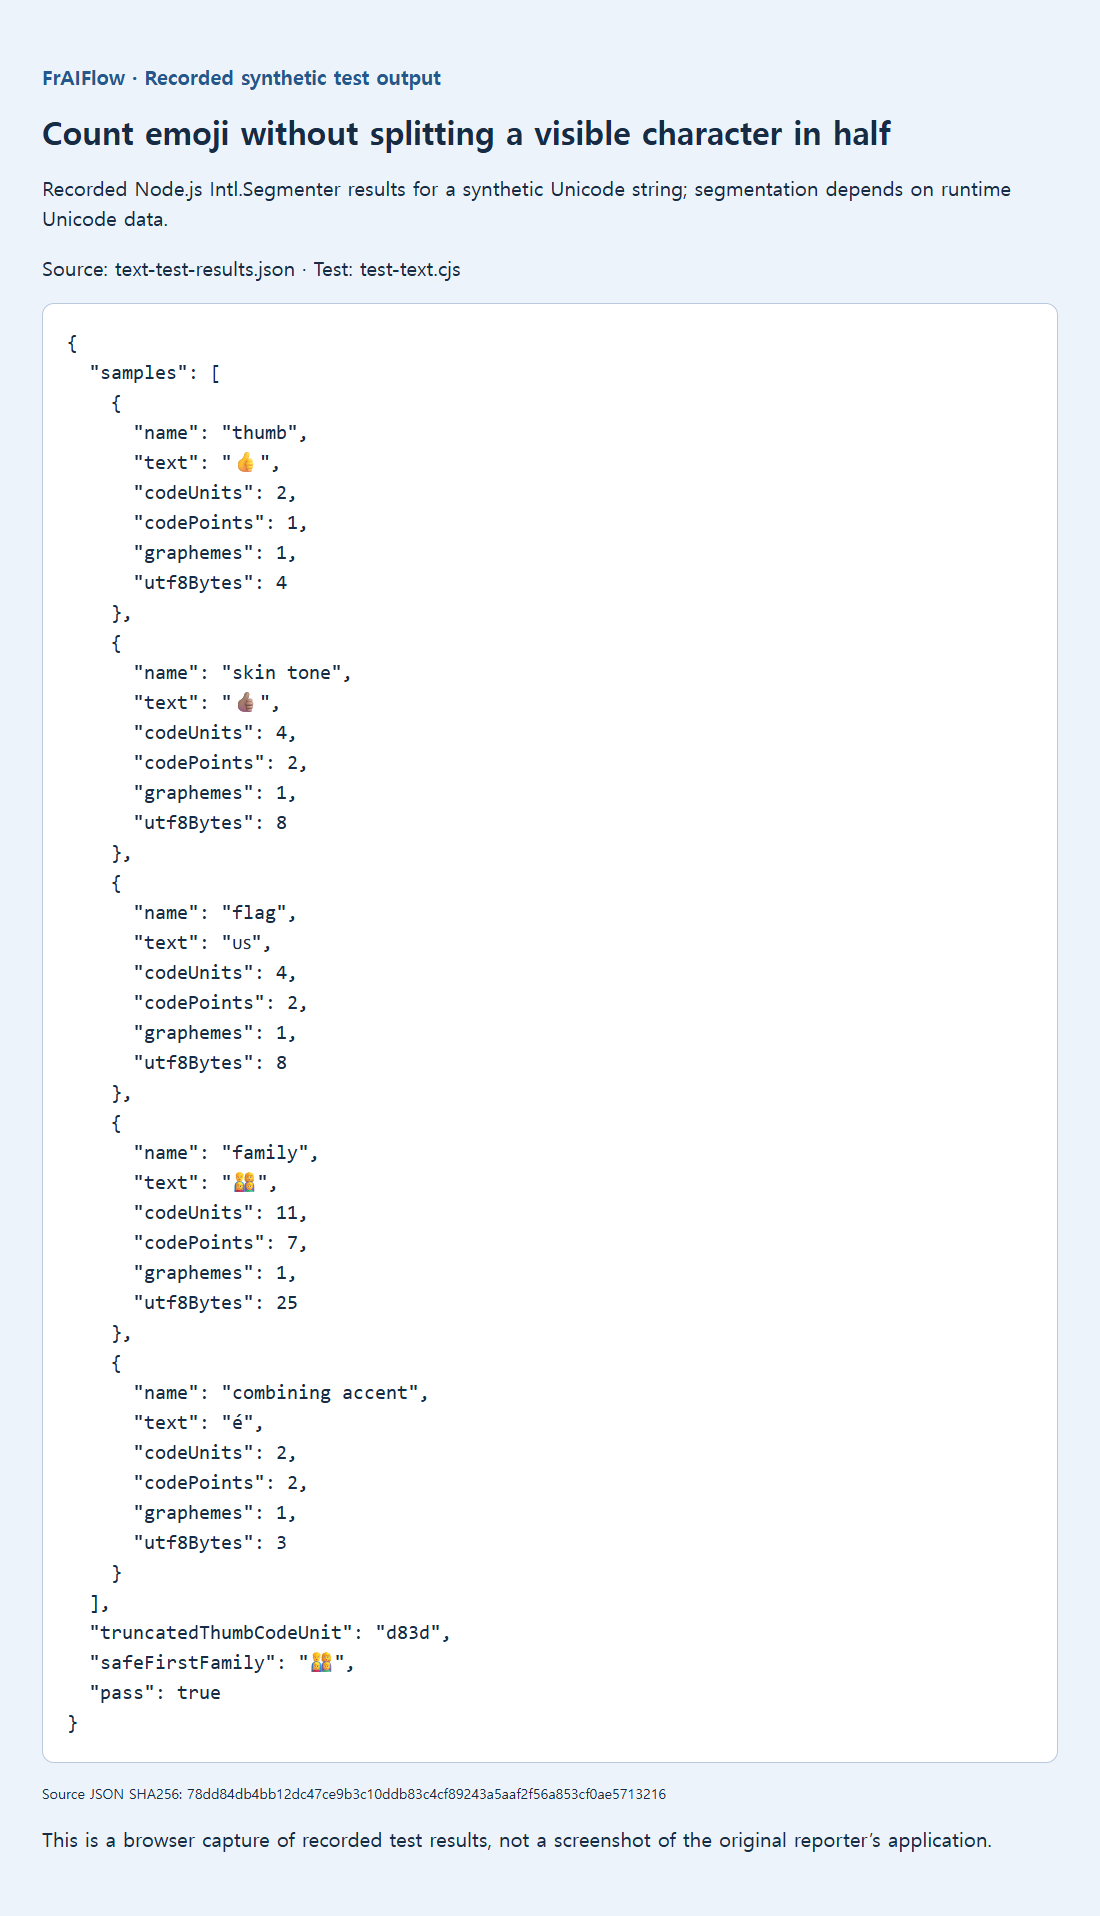
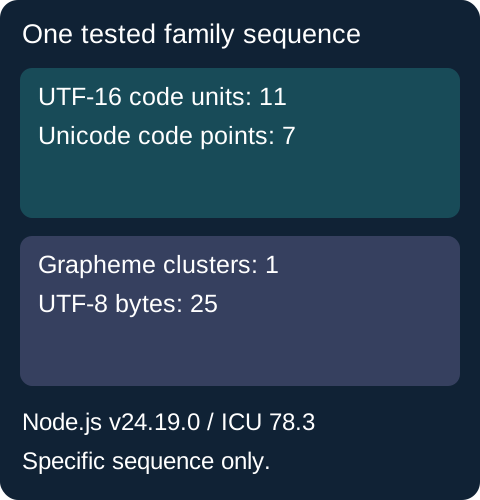
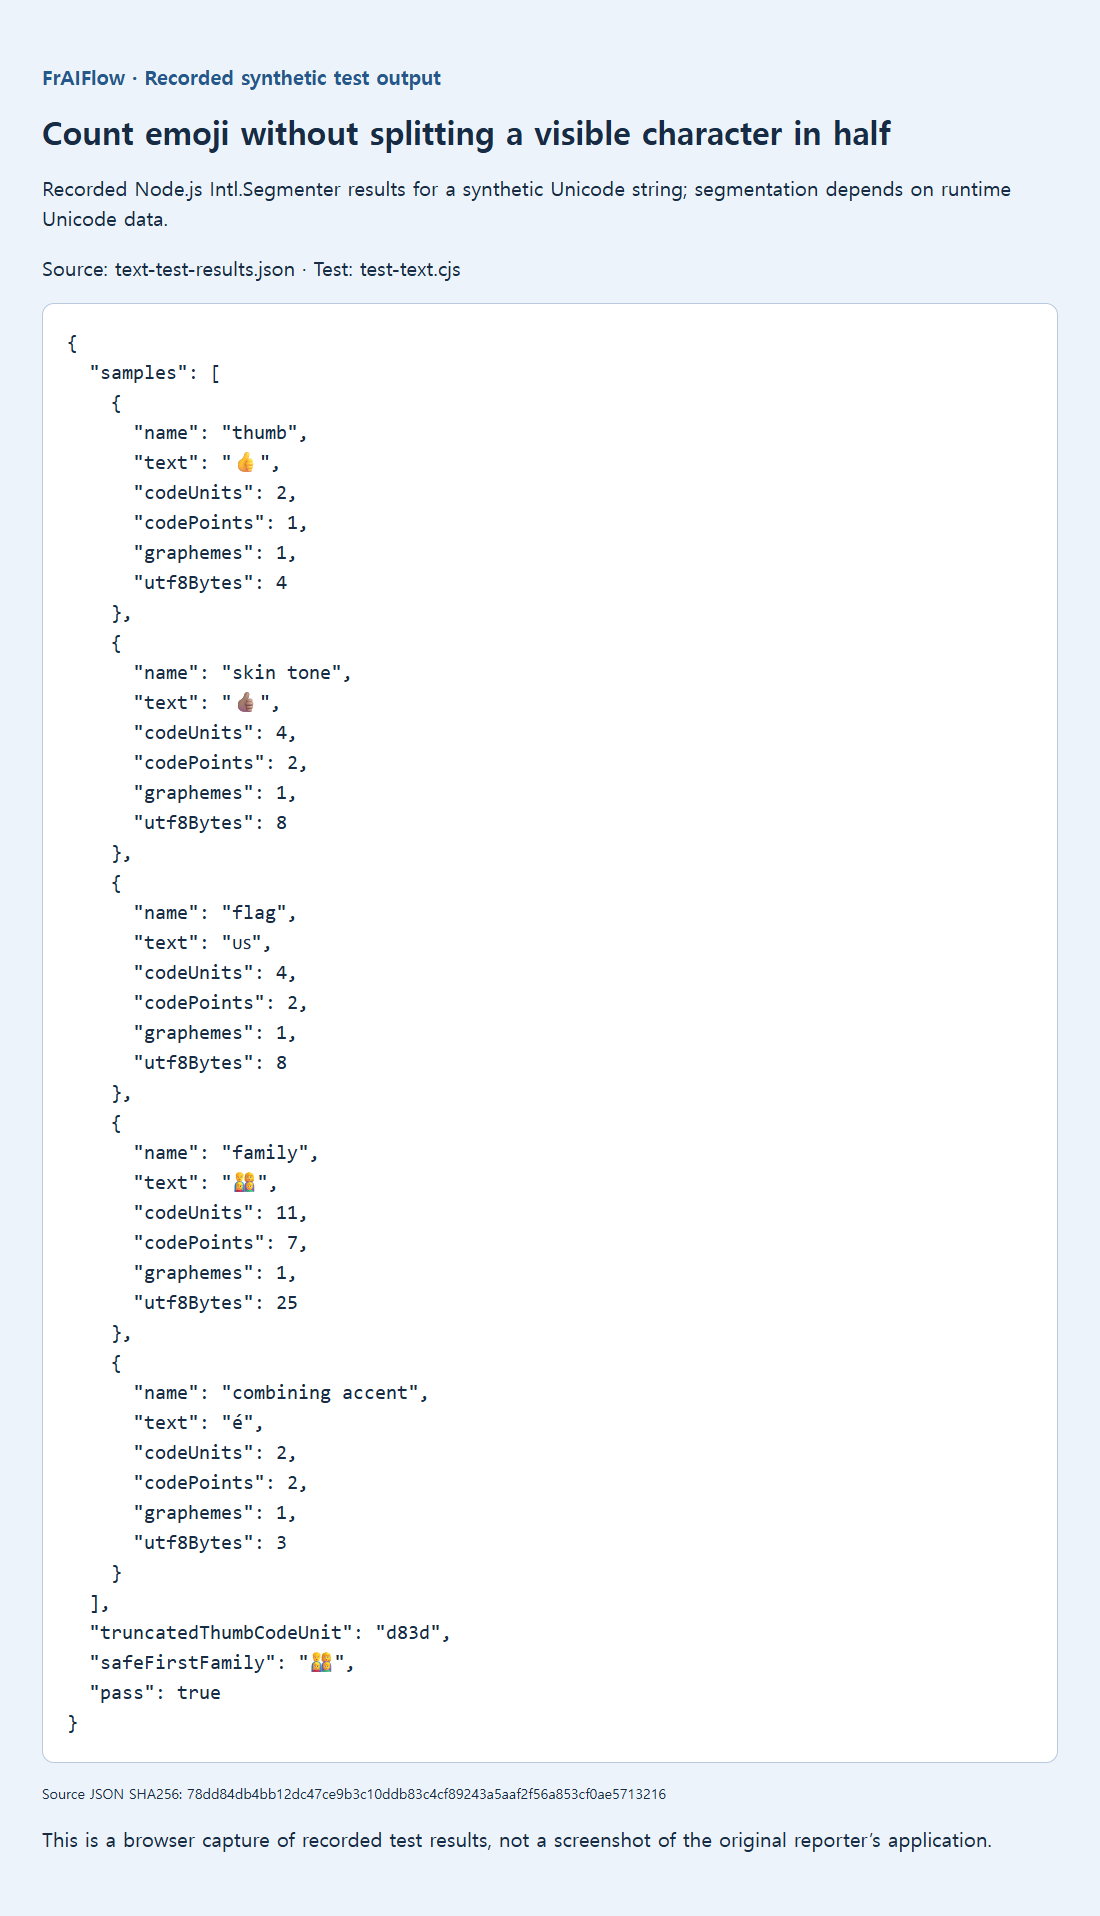
保留的 Node v24.19.0 / ICU 78.3 測試涵蓋拇指、膚色序列、旗幟、連接的家庭與組合重音,每個都是一個字素。家庭 emoji 使用 11 個碼元與 7 個碼位;普通拇指只保留一個碼元時,會留下 D83D,也就是未配對的高代理碼。