Contare le emoji senza tagliare a metà un carattere visibile
L’utente inserisce un’emoji ma il contatore segna due. Un’altra viene tagliata in un simbolo spezzato. Spesso il problema è l’unità contata, non l’input corrotto: length di JavaScript misura unità di codice UTF-16, mentre il lettore vede gruppi di grafemi.
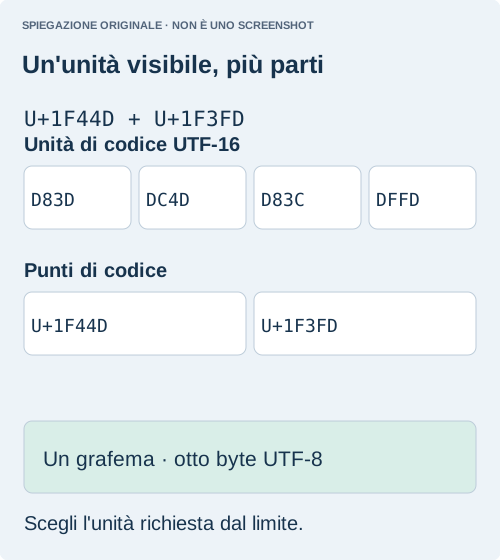
Decidi che cosa promette il contatore
Un campo didascalia che dice “un carattere rimasto” non dovrebbe respingere un pollice in su perché l’implementazione conta due unità UTF-16. Un servizio di archiviazione può invece avere davvero un limite in byte. Sono requisiti diversi. Prima di cambiare codice, verifica se il limite riguarda un’etichetta leggibile, una colonna database o un’API terza. Cambiare solo il contatore può lasciare un errore al salvataggio.
Per il testo visibile, di solito conviene partire dal grafema: lettera con accento combinante o emoji con modificatore restano insieme. Non misura la larghezza sullo schermo. Un’emoji famiglia e una lettera stretta possono contare entrambe come un grafema occupando spazi diversi.
Una domanda pubblica del 2016 chiedeva perché un pollice in su avesse lunghezza 2. Quel carattere usa una coppia surrogata. Espandere la stringa conta i punti di codice e risolve quel caso semplice, ma non tonalità della pelle, bandiere o famiglie unite.
const text = "👍🏽";
const s = new Intl.Segmenter("en", { granularity: "grapheme" });
text.length;                      // 4 code units
[...text].length;                 // 2 code points
[...s.segment(text)].length;      // 1 grapheme
new TextEncoder().encode(text).length; // 8 UTF-8 bytes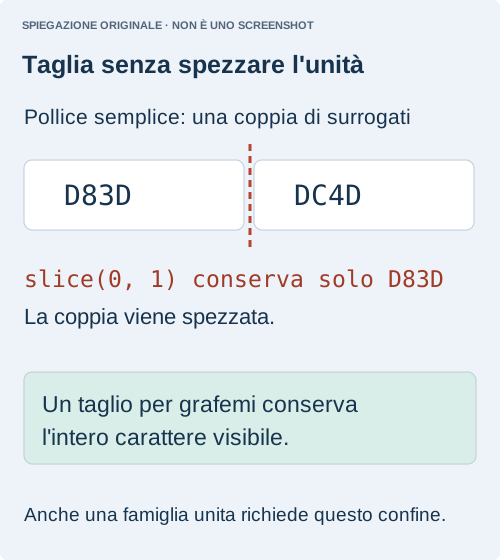
Taglia solo dopo un carattere visibile completo
function truncate(text, maximum) {
  if (!Number.isInteger(maximum) || maximum < 0)
    throw new RangeError("Use a nonnegative integer");
  const s = new Intl.Segmenter(undefined, { granularity: "grapheme" });
  let result = "", count = 0;
  for (const item of s.segment(text)) {
    if (count++ >= maximum) break;
    result += item.segment;
  }
  return result;
}
Il metodo conserva l’inizio senza creare un array di tutti i segmenti. Decidi separatamente se i puntini di sospensione consumino parte del limite. Un taglio per unità di codice può lasciare mezza coppia surrogata; uno per punti di codice può ancora spezzare un’emoji unita.
Usa la funzione di troncamento di questa sezione con un breve esempio misto, come A👍🏽B. Conservare due grafemi deve mantenere A👍🏽, non un pollice senza tonalità della pelle. Prova poi un accento combinante e una famiglia unita. Conta dove avviene il taglio: una funzione può contare bene una stringa completa ma tagliarla male altrove nell’interfaccia.
const sample = "A👍🏽B";
console.log(truncate(sample, 0)); // ""
console.log(truncate(sample, 1)); // "A"
console.log(truncate(sample, 2)); // "A👍🏽"
console.log(truncate(sample, 3)); // "A👍🏽B"
Sono risultati attesi per un runtime con segmentazione in grafemi, non nuove prove browser. Verifica il supporto prima di offrire questo comportamento. Se Intl.Segmenter non è disponibile, non sostituirlo silenziosamente con spread e slice promettendo la stessa garanzia. Conserva l’input e spiega il limite oppure usa una segmentazione verificata separatamente.
Mantieni coerenti modifica e salvataggio
In un campo attivo aggiorna il conteggio senza riscrivere il valore a ogni tasto. Alcuni metodi di input compongono un carattere con più pressioni; tagliare durante la composizione può interferire. È più prudente mostrare il conteggio, spiegare il superamento e lasciare correggere prima di salvare. Se generi un’etichetta abbreviata, conserva altrove il testo completo.
Decidi se i puntini aggiunti siano inclusi nel limite. Per un’anteprima di cinque grafemi con ellissi, riserva spazio al segno invece di mantenere cinque grafemi e aggiungerne un sesto. Non aspettarti che un limite di caratteri visibili rispetti un’API con limite in byte: l’emoji con tonalità sopra è un grafema ma otto byte UTF-8.
Prima del rilascio confronta contatore, anteprima abbreviata e valore salvato usando gli stessi campioni. Se il backend conta diversamente, documenta e verifica quella regola. Gestire i grafemi evita tagli spezzati; non normalizza l’ortografia, non garantisce il supporto dei font né definisce le regole di altri servizi.
Che cosa dimostrano gli esempi registrati
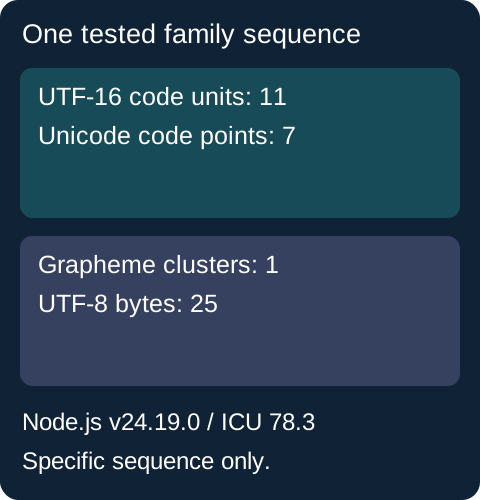
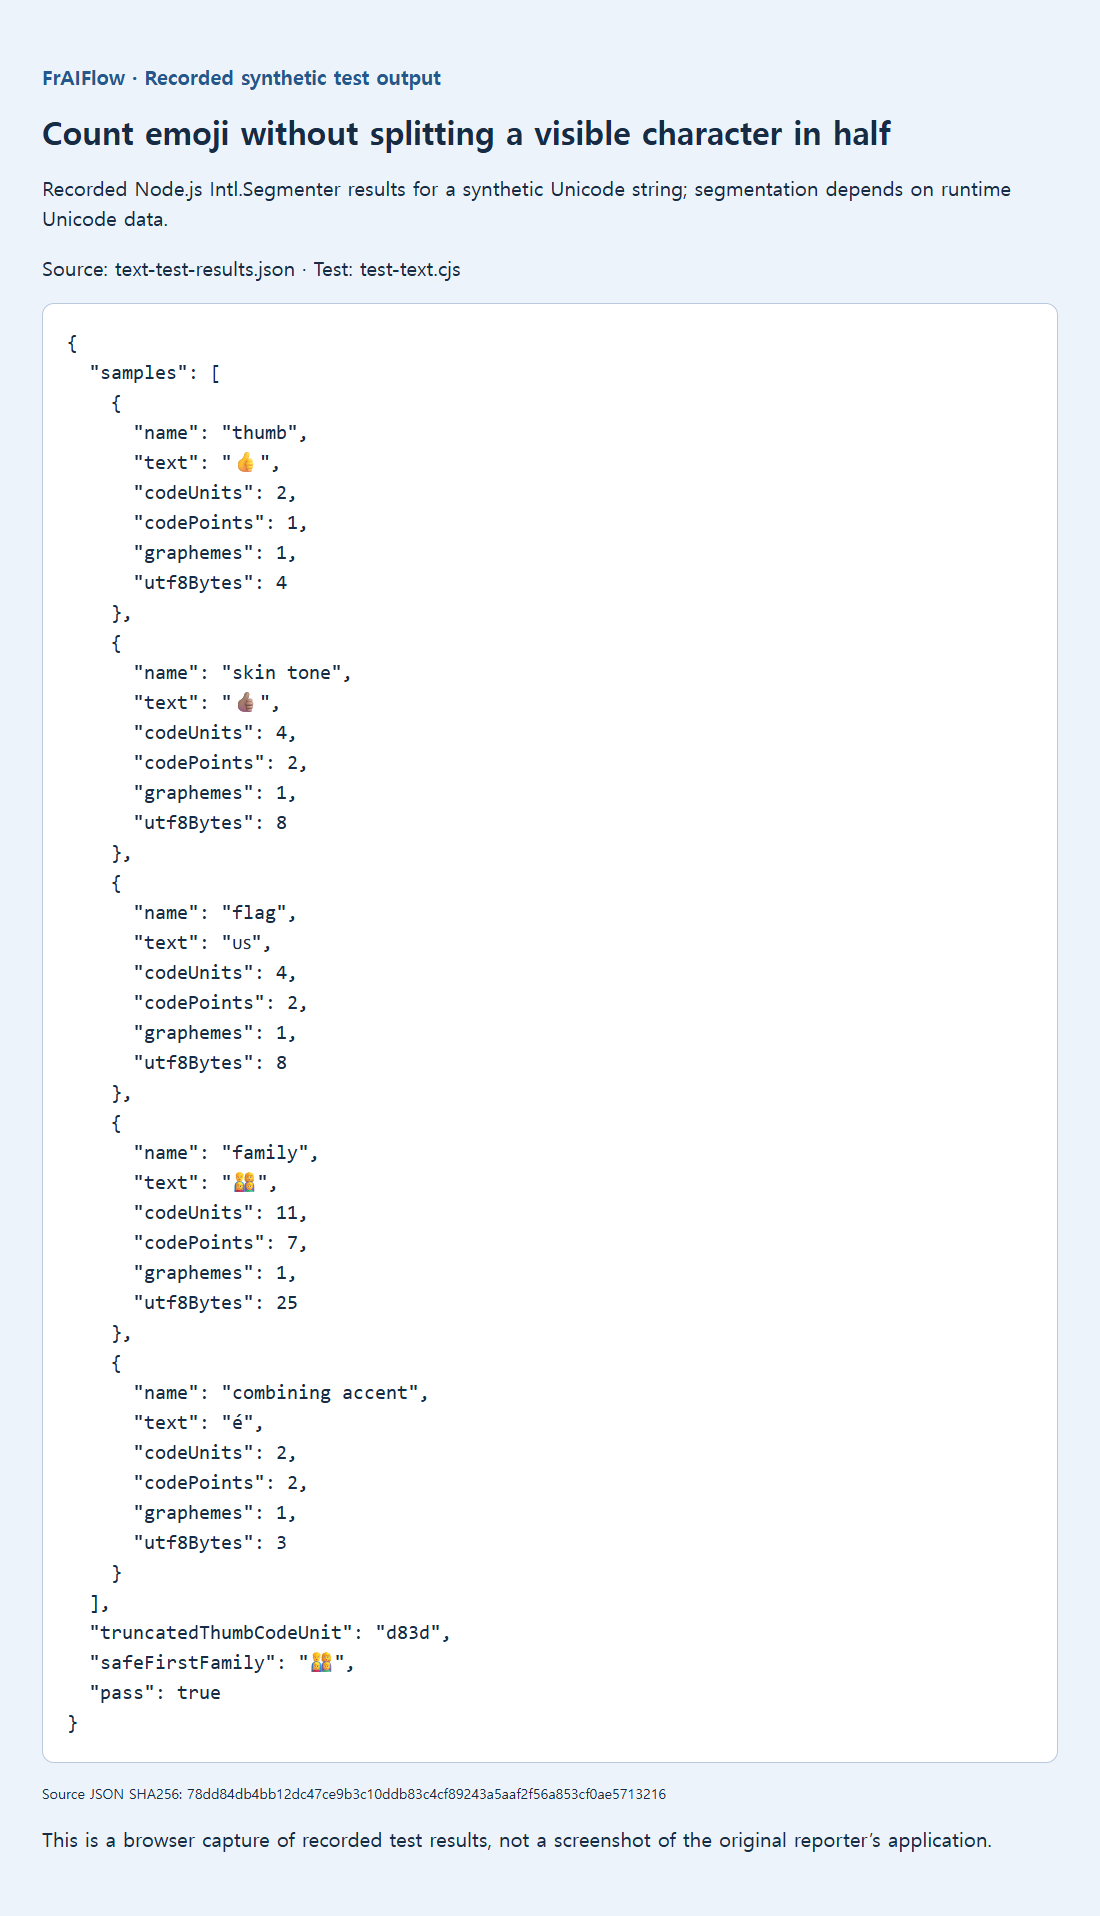
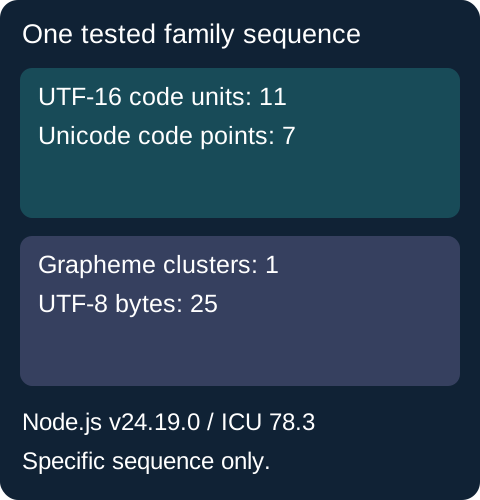
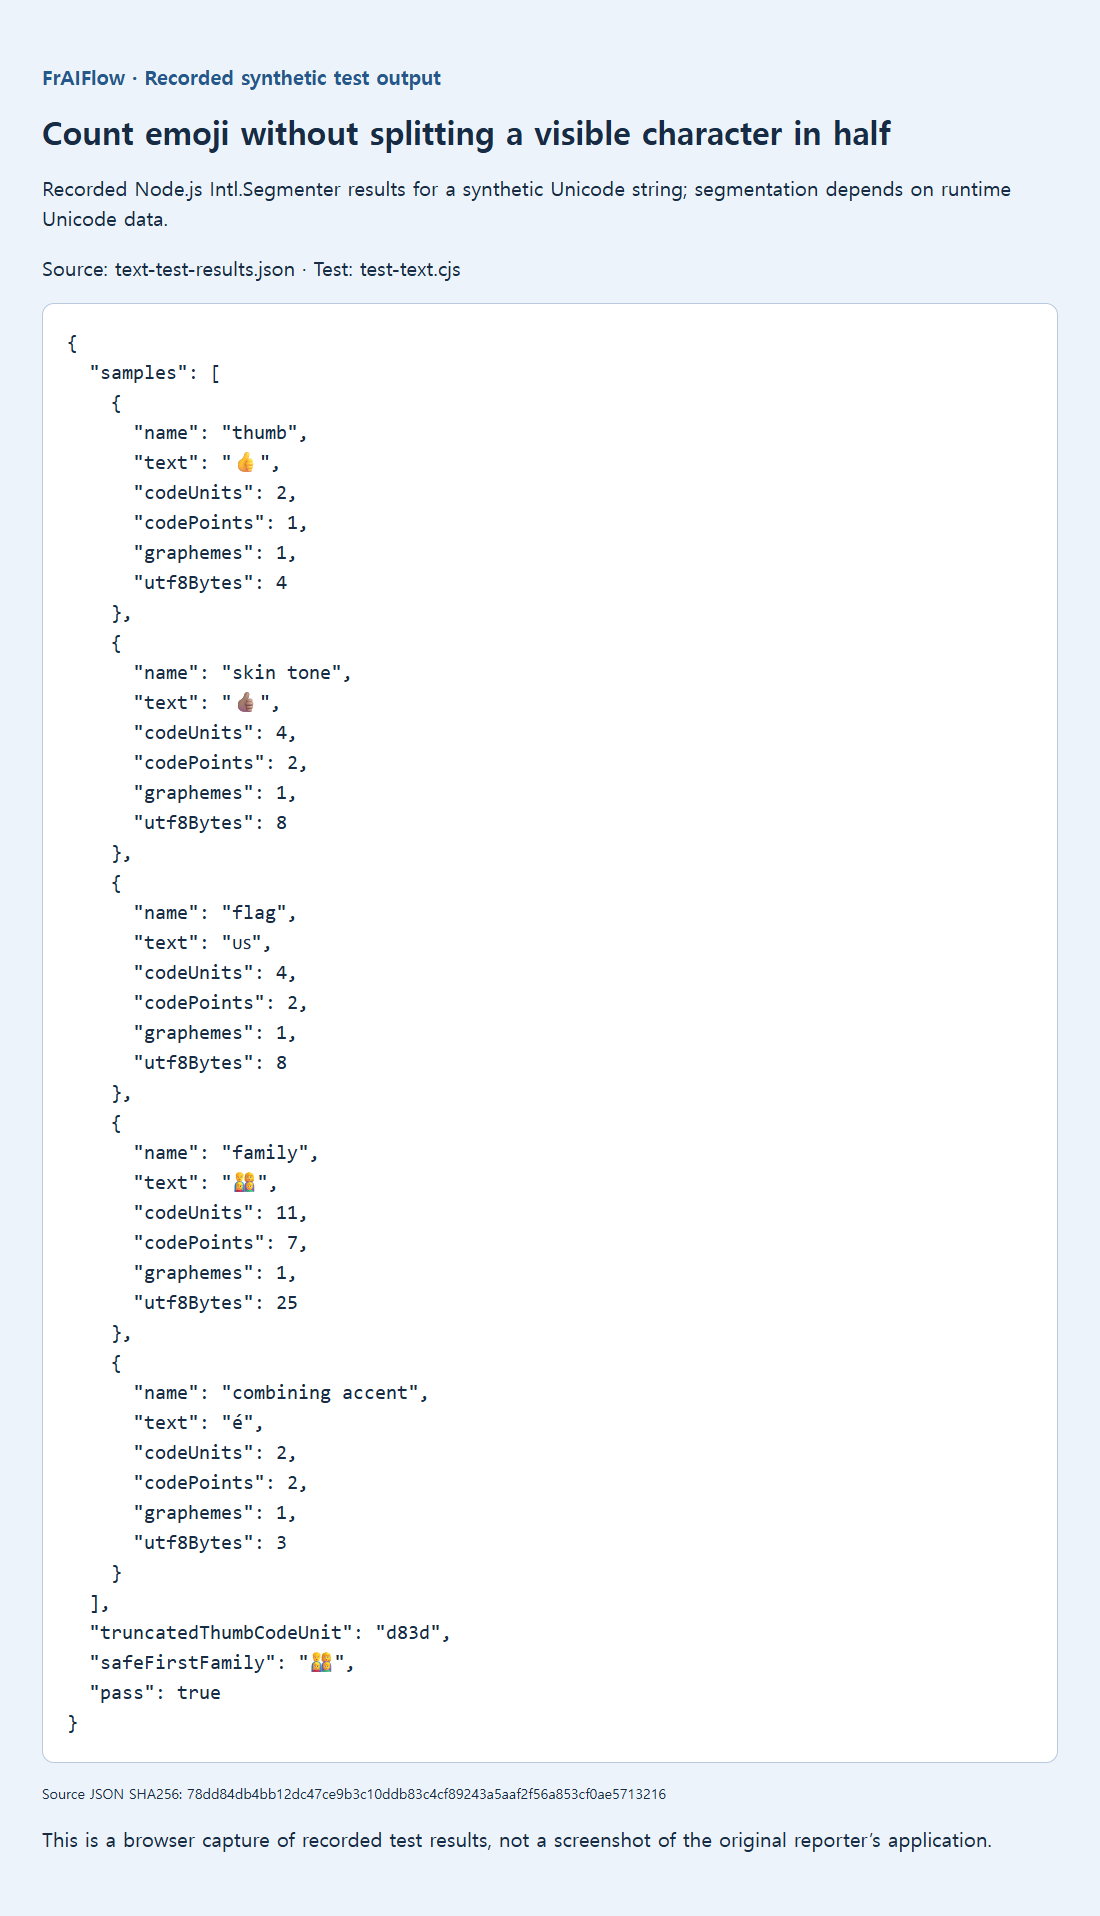
I campioni Node v24.19.0 / ICU 78.3 conservati comprendevano pollice in su, tonalità della pelle, bandiera, famiglia unita e accento combinante. Ciascuno era un grafema. La famiglia usava 11 unità di codice e 7 punti di codice; tagliare il pollice semplice a una sola unità lasciava D83D, un surrogato alto senza compagno.