이모지를 반으로 자르지 않고 글자 수를 세는 방법
사용자는 이모지 하나를 넣었는데 카운터는 두 글자라고 합니다. 다른 이모지는 잘려 깨진 기호가 됩니다. 입력이 손상된 것이 아니라 세는 단위가 다른 경우가 많습니다. JavaScript length는 UTF-16 코드 단위를 세지만 독자는 문자소 묶음을 봅니다.
카운터가 무엇을 약속하는지 정하세요
설명 입력란에 “한 글자 남음”이라고 표시했다면 내부적으로 UTF-16 두 단위를 쓴다는 이유만으로 엄지 이모지 하나를 거부해서는 안 됩니다. 반면 저장 서비스는 실제로 바이트 제한을 둘 수 있습니다. 서로 다른 요구입니다. 코드를 바꾸기 전에 독자용 표시 제한인지 데이터베이스 열 제한인지 외부 API 제한인지 확인하세요. 카운터만 바꾸면 나중에 저장이 실패할 수 있습니다.
눈에 보이는 텍스트에는 문자소(grapheme)가 보통 유용한 출발점입니다. 글자와 결합 악센트, 이모지와 수식자를 함께 유지합니다. 화면 너비를 측정하는 단위는 아닙니다. 가족 이모지 하나와 가는 글자 하나는 각각 한 문자소여도 차지하는 폭은 매우 다를 수 있습니다.
2016년 공개 질문에서는 엄지 이모지의 length가 2인 이유를 물었습니다. 그 문자는 서로게이트 쌍을 사용합니다. 전개 문법으로 문자열을 펼치면 코드 포인트를 세므로 단순 예시는 해결되지만 피부색·국기·연결된 가족 이모지는 해결하지 못합니다.
const text = "👍🏽";
const s = new Intl.Segmenter("en", { granularity: "grapheme" });
text.length;                      // 4 code units
[...text].length;                 // 2 code points
[...s.segment(text)].length;      // 1 grapheme
new TextEncoder().encode(text).length; // 8 UTF-8 bytes
눈에 보이는 글자가 끝나는 지점에서만 자르세요
function truncate(text, maximum) {
  if (!Number.isInteger(maximum) || maximum < 0)
    throw new RangeError("Use a nonnegative integer");
  const s = new Intl.Segmenter(undefined, { granularity: "grapheme" });
  let result = "", count = 0;
  for (const item of s.segment(text)) {
    if (count++ >= maximum) break;
    result += item.segment;
  }
  return result;
}
이 방법은 전체 세그먼트 배열을 만들지 않고 문자열 앞부분을 유지합니다. 말줄임표도 제한에 포함할지는 별도로 정하세요. 코드 단위로 자르면 서로게이트 쌍의 절반이 남을 수 있고, 코드 포인트로 잘라도 연결 이모지가 끊어질 수 있습니다.
이 절의 자르기 함수에 A👍🏽B처럼 짧은 혼합 예시를 넣어 보세요. 두 문자소를 남기면 피부색이 빠진 엄지가 아니라 A👍🏽가 유지돼야 합니다. 결합 악센트와 연결된 가족도 시험하세요. 핵심은 잘리는 위치입니다. 전체 수를 정확히 세는 함수가 있어도 다른 UI에서 잘못 자를 수 있습니다.
const sample = "A👍🏽B";
console.log(truncate(sample, 0)); // ""
console.log(truncate(sample, 1)); // "A"
console.log(truncate(sample, 2)); // "A👍🏽"
console.log(truncate(sample, 3)); // "A👍🏽B"
문자소 분할을 지원하는 런타임에서 기대하는 예시이지 새로운 브라우저 시험 증거는 아닙니다. 제공 전 지원 여부를 확인하세요. Intl.Segmenter가 없다면 몰래 전개 후 slice 방식으로 대체하고 같은 보장을 주장하지 마세요. 사용자 입력을 보존하며 한계를 설명하거나 별도로 검토한 분할 구현을 사용하세요.
입력·편집·저장에 같은 기준을 적용하세요
실시간 입력란에서는 키 입력마다 값을 다시 쓰지 말고 수만 갱신하세요. 일부 입력기는 여러 키 입력을 조합해 글자 하나를 만듭니다. 조합 중 강제로 자르면 입력을 방해할 수 있습니다. 수와 초과 이유를 보여주고 저장 전에 사용자가 편집하도록 하는 편이 안전합니다. 짧은 표시용 이름을 만든다면 전체 원문은 다른 곳에서 볼 수 있게 남겨 두세요.
추가하는 말줄임표를 제한에 포함할지 정하세요. 말줄임표를 포함해 다섯 문자소라면 다섯 개를 남기고 여섯 번째를 붙이지 말고 표식 자리를 미리 확보합니다. 눈에 보이는 글자 수 제한으로 바이트 제한 API를 만족시킬 수는 없습니다. 앞의 피부색 예시는 한 문자소지만 UTF-8로 8바이트입니다.
출시 전 같은 예시들로 카운터·축약 미리보기·저장값을 비교하세요. 백엔드가 다른 기준으로 센다면 문서화하고 그 기준으로 검증합니다. 문자소 단위 처리는 잘못된 잘라내기를 방지하지만 철자 정규화·글꼴 지원·다른 서비스의 규칙까지 정하지는 않습니다.
기록된 예시가 보여주는 범위
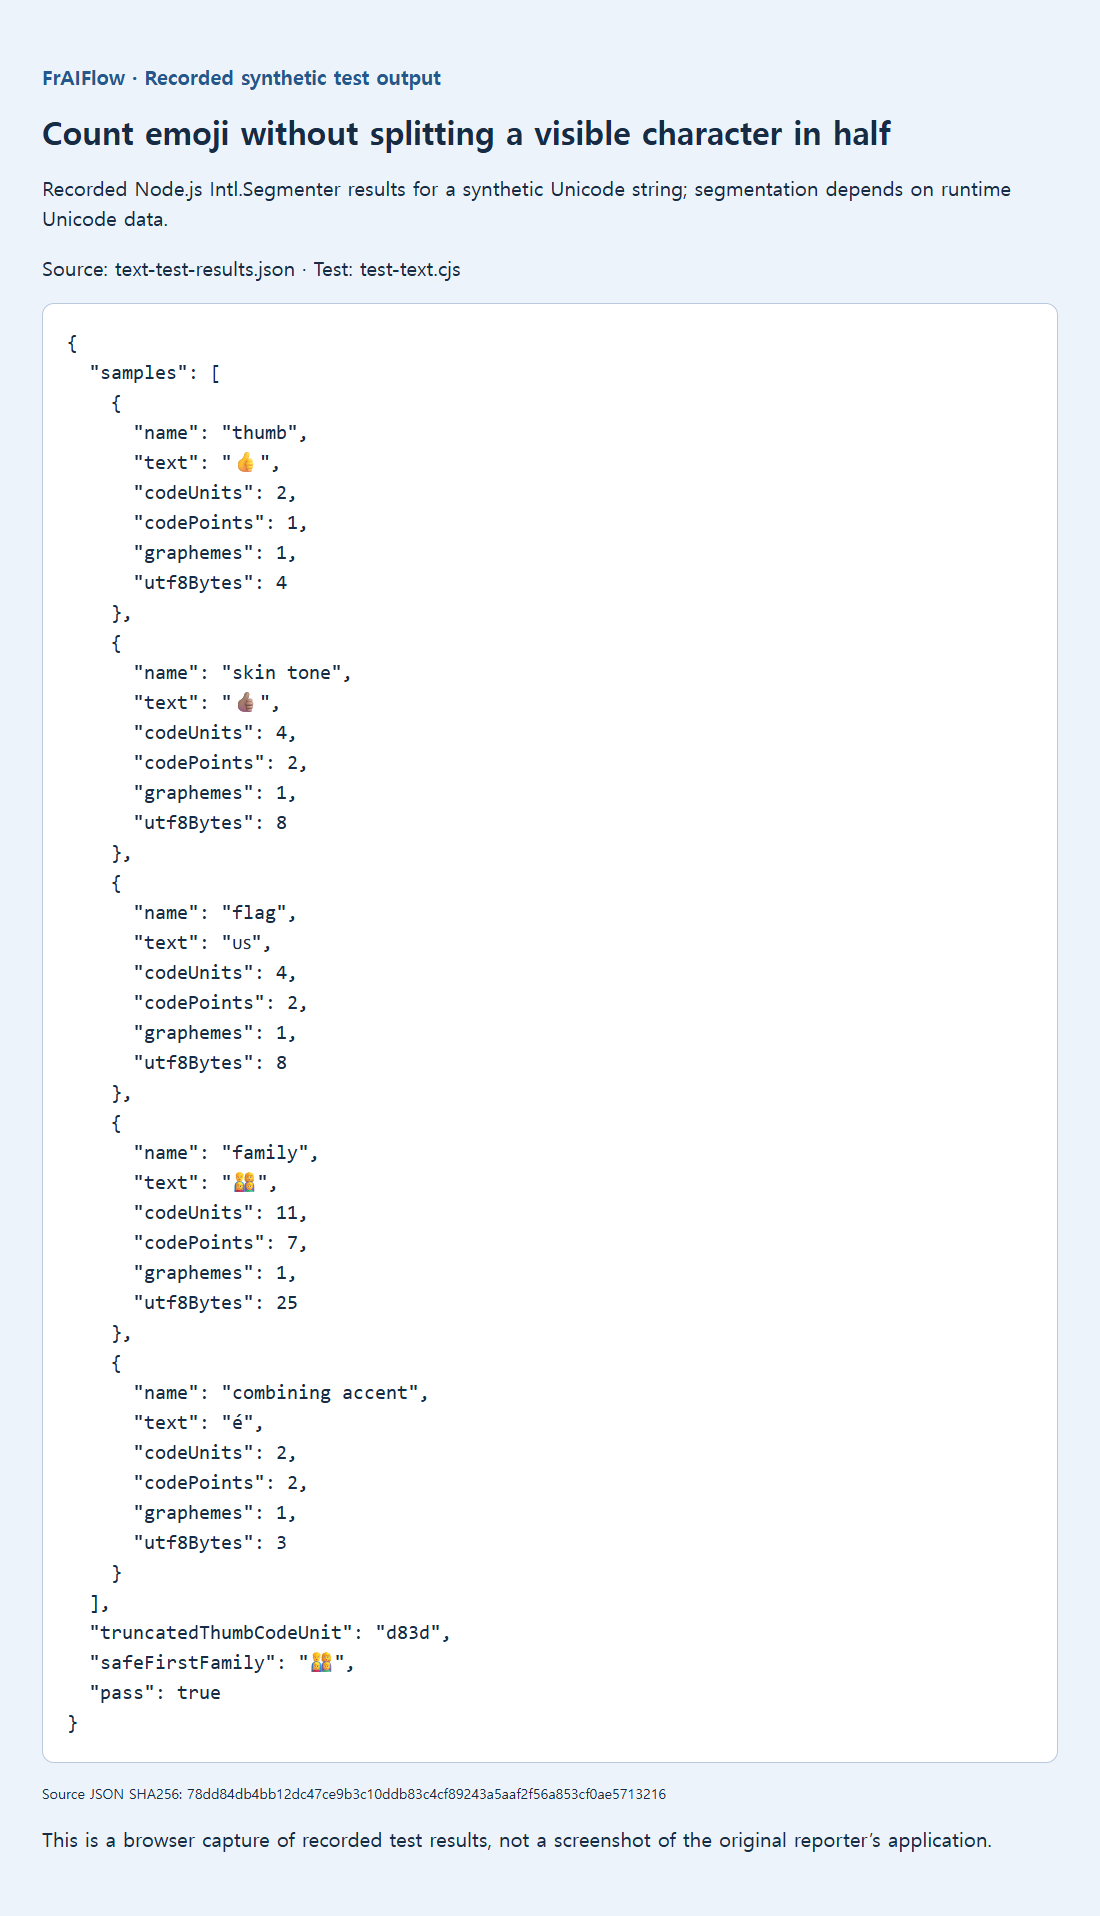
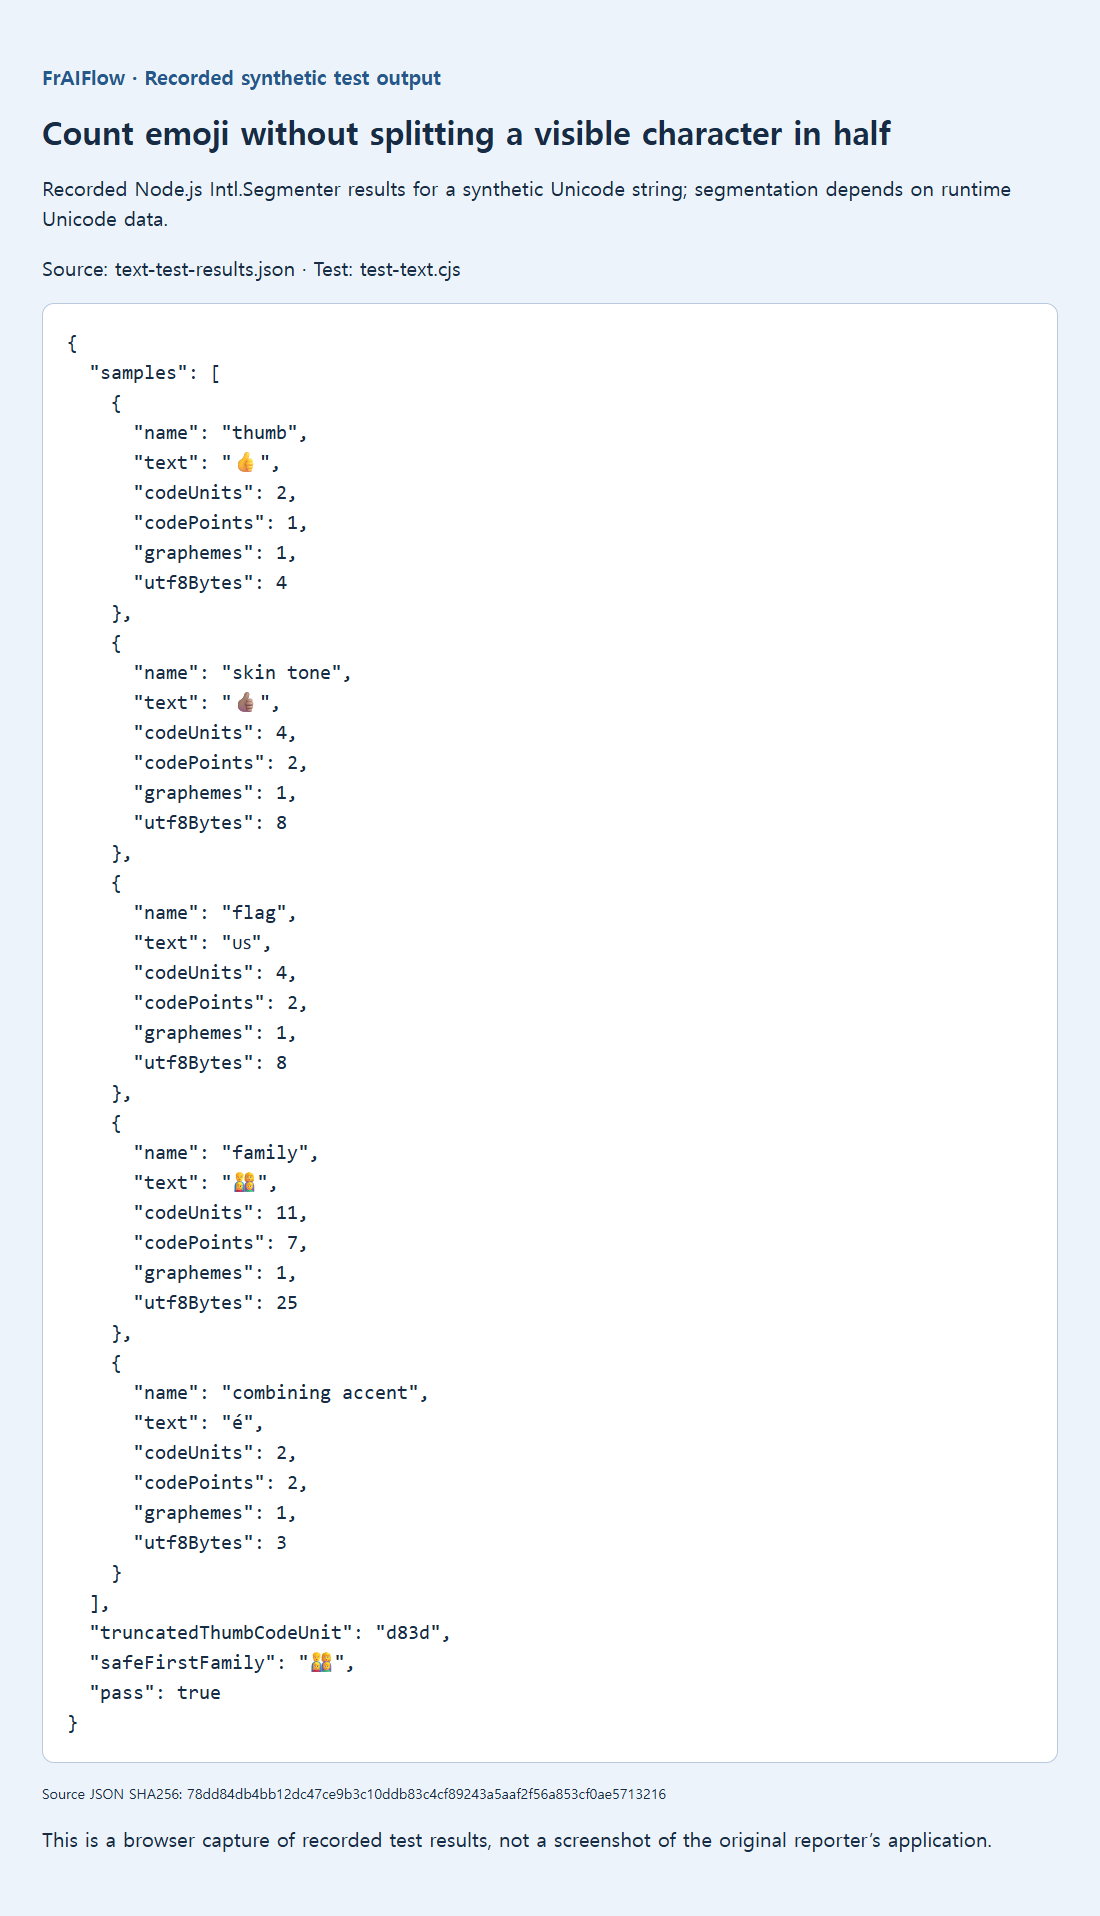
보존된 Node v24.19.0 / ICU 78.3 시험에는 엄지·피부색 조합·국기·연결 가족·결합 악센트가 포함됐습니다. 각각 한 문자소였습니다. 가족은 코드 단위 11개와 코드 포인트 7개였고, 기본 엄지를 한 코드 단위로 자르면 짝이 없는 상위 서로게이트 D83D가 남았습니다.