Ret fejlformet procentkodet UTF-8
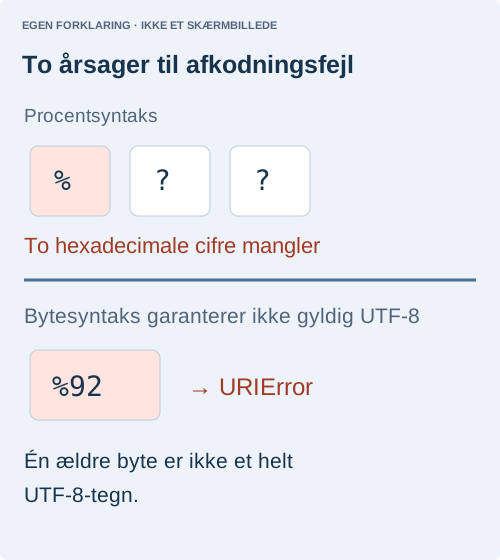
En URL-værdi når frem til dit program, men decodeURIComponent() udløser URIError. Før du udskifter tegnsætning, skal du skelne mellem to fejl: en ufuldstændig procentsekvens og en fuldstændig bytesekvens, som ikke er gyldig UTF-8.
Find den overgang, hvor værdien ændrer sig
Forestil dig, at et søgefelt accepterer 50% off, men at åbning af det resulterende link får siden til at fejle. Procenttegnet er almindelig tekst i søgefeltet. Det bliver først særligt, når kode behandler teksten som en allerede kodet URL-komponent. Notér den forventede værdi ved hver overgang: brugerens tekst, den serialiserede URL og den værdi, modtagersiden læser. Du leder efter en kodningsuoverensstemmelse, ikke tegnsætning, der skal slettes.
Brug et harmløst eksempel i stedet for at kopiere et rigtigt link til nulstilling af adgangskode eller en kundeforespørgsel til en konsol eller et offentligt issue. Prøv først decodeURIComponent("%25"): Det forventede resultat er ét procenttegn. Prøv derefter det fejlende eksempel med den beskyttede hjælpefunktion i “Afvis fejlformet input uden at få siden til at fejle” nedenfor. Hvis det gyldige kontrolinput virker, mens eksemplet fejler, er dekoderen ikke generelt defekt; de leverede data skal undersøges.
Skeln mellem en brudt procentsekvens og ugyldig UTF-8
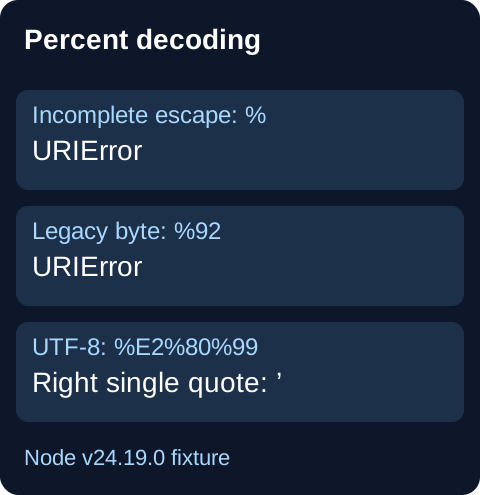
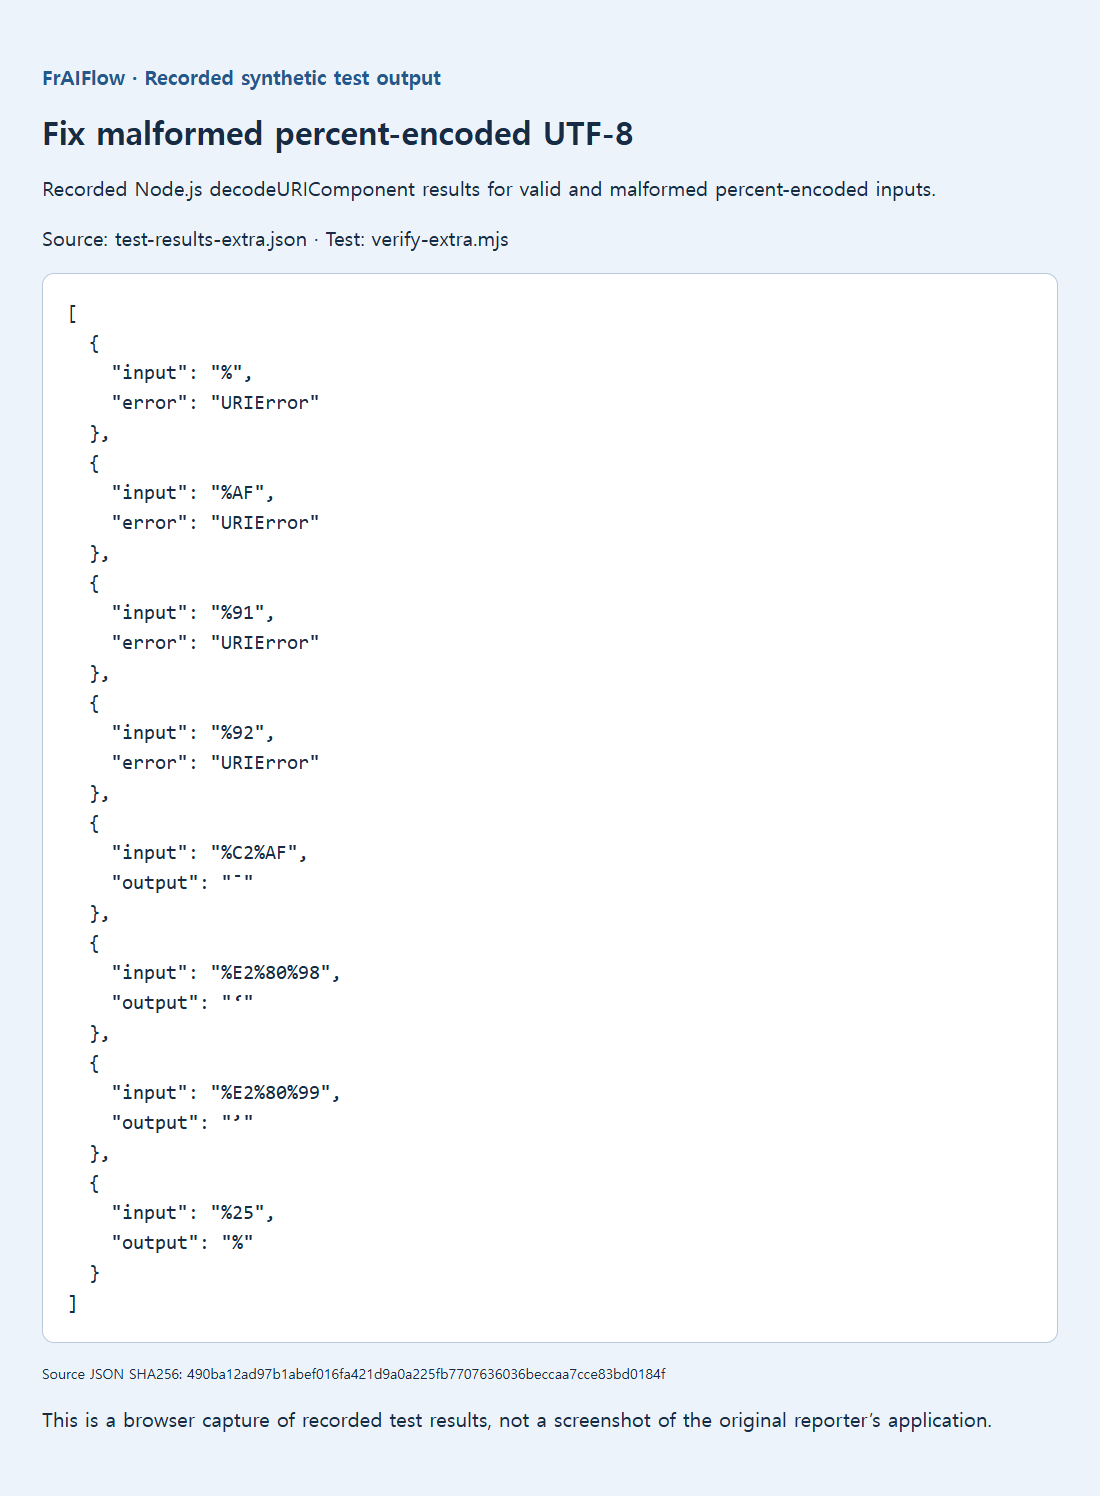
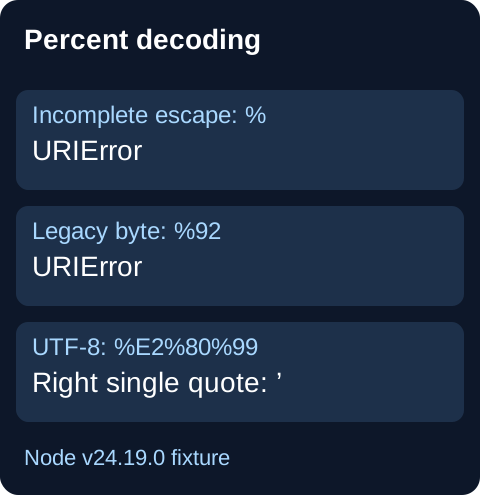
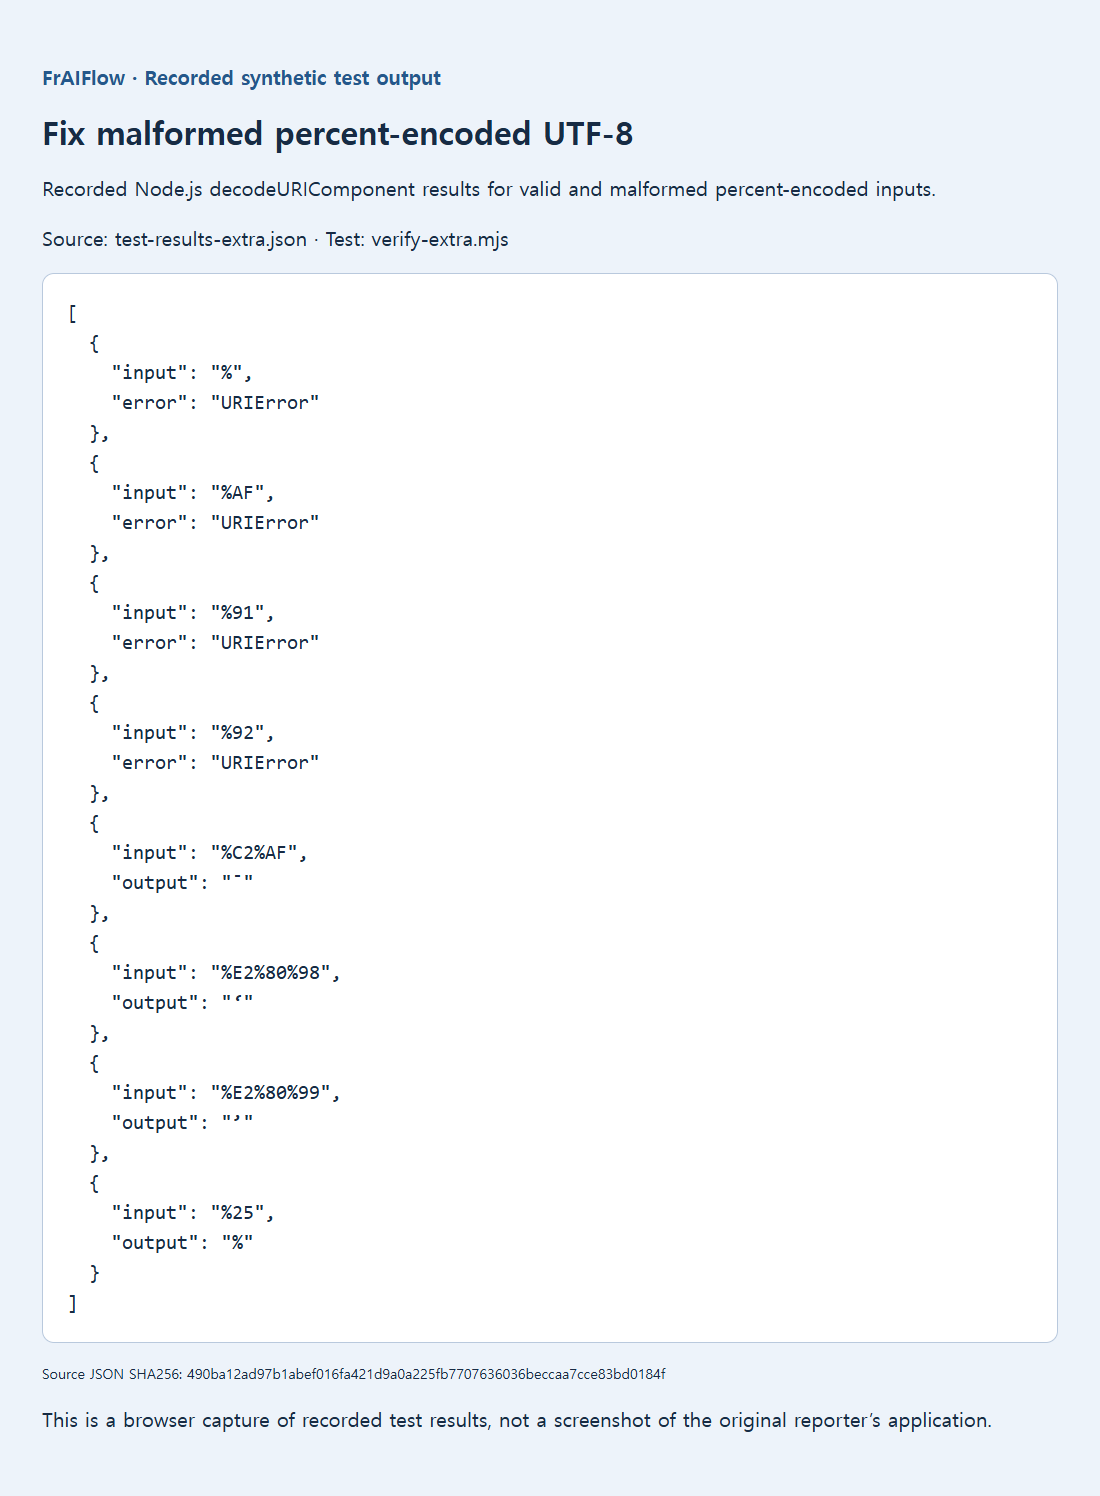
Et enkeltstående % har ingen tocifret byteværdi. Derimod er %92 syntaktisk en procentkodet byte, men den byte kan ikke stå alene i UTF-8. Offentlige rapporter viser begge fejl, herunder ældre bytekoder for anførselstegn og et isoleret %AF.
decodeURIComponent("%");          // URIError
 decodeURIComponent("%92");        // URIError
 decodeURIComponent("%25");        // %
 decodeURIComponent("%C2%AF");     // ¯
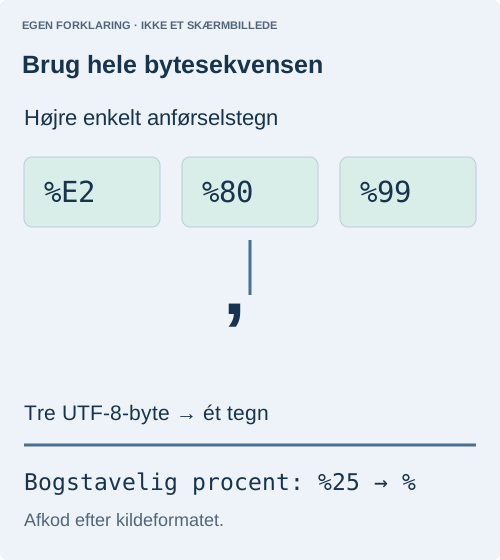
 decodeURIComponent("%E2%80%99"); // ’
Det bevarede Node v24.19.0-testmateriale genskabte resultaterne og testede også %91, %AF og UTF-8-venstreanførselstegnet. Browserens formulering kan variere; succes eller afvisning af det nøjagtige input er den nyttige dokumentation.
Byg query-strenge uden at sammenkæde procentsekvenser manuelt
Til et nyt link skal du give originalteksten til URL-API'et og lade det serialisere parameteren. På modtagersiden skal parameteren læses gennem samme API. Afkod ikke straks den returnerede værdi igen:
const link = new URL("https://example.com/search");
link.searchParams.set("q", "50% off & café");
const received = new URL(link.href).searchParams.get("q");
console.log(received); // 50% off & café
Dette er en eksempel-URL, ikke et FrAIFlow-endpoint. Den vigtige forskel er mellem en kodet komponent og en værdi, der allerede er parset. En anden afkodning kan gøre helt legitim tekst som 50% off til en undtagelse. Husk også, at et plustegn i query-parametre med formularformat håndteres anderledes end et bogstaveligt plus givet direkte til decodeURIComponent(); brug en parser, der passer til formatet.
Ret afsenderen i stedet for at gætte tegn
Behold det præcise fejlende eksempel privat, og spørg afsenderen, hvilken tegnkodning der blev brugt. Et enkeltstående %92 kan pege på en ældre bytekonvention, men byten alene fastslår ikke oprindelsen. Erstat ikke ubemærket med en apostrof i konto-ID'er, signaturer eller filnavne. Returnér en nyttig fejl, bevar originalinputtet til brugeren, og ret kodningen ved kilden, når det er muligt.
Efter ændringen skal du teste et bogstaveligt procenttegn, et ord med accent, et typografisk anførselstegn, et plus og et og-tegn. Hver værdi skal overleve et helt forløb fra opret link → åbn link → læs værdi uændret. Fejlformet input skal give din kontrollerede fejl frem for at stoppe resten af siden. Kontrollerne verificerer formataftalen; de retfærdiggør ikke gentagen afkodning, indtil strengen ser læsbar ud.
Afvis fejlformet input uden at få siden til at fejle
function decodeComponent(value) {
  try { return { ok: true, value: decodeURIComponent(value) }; }
  catch (error) {
    if (!(error instanceof URIError)) throw error;
    return { ok: false, error: "Invalid encoded component" };
  }
}
Denne grænse rapporterer fejl uden ubemærket at ændre et ID. Den kan ikke opdage en ukendt kildekodning. Afkod kun så mange gange, som formataftalen kræver: Et procenttegn, der er tilbage efter en vellykket afkodning, begrunder ikke endnu et gennemløb. Undgå det forældede unescape() som UTF-8-løsning, og hold tokens eller private query-værdier væk fra offentlige diagnoselogge.