Corriger un encodage pour cent UTF-8 mal formé
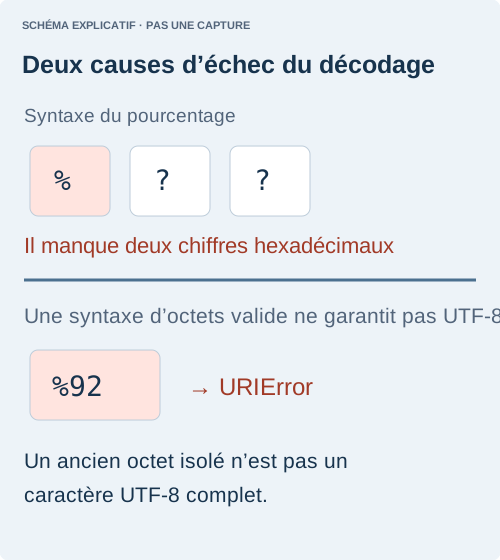
Une valeur d’URL parvient à votre application, mais decodeURIComponent() lève URIError. Avant de remplacer la ponctuation, distinguez deux erreurs : une séquence pour cent incomplète et une séquence d’octet complète qui n’est pas valide en UTF-8.
Repérez l’étape où la valeur change
Supposons qu’un champ de recherche accepte 50% off, mais que l’ouverture du lien créé fasse échouer la page. Le pourcentage est du texte ordinaire dans le champ. Il devient spécial seulement lorsque le code traite ce texte comme une composante d’URL déjà encodée. Notez la valeur attendue à chaque étape : saisie utilisateur, URL sérialisée, puis valeur lue par la page destinataire. Vous cherchez une incohérence d’encodage, pas de la ponctuation à supprimer.
Utilisez un exemple sans données sensibles plutôt qu’un véritable lien de réinitialisation de mot de passe ou une recherche client dans une console ou un signalement public. Essayez d’abord decodeURIComponent("%25") : le résultat attendu est un seul signe pour cent. Essayez ensuite la valeur problématique avec la fonction protégée de la section « Refuser une entrée mal formée sans faire échouer la page » ci-dessous. Si le cas valide fonctionne mais pas l’autre, le décodeur n’est pas globalement défectueux ; il faut examiner les données fournies.
Distinguez un échappement incomplet d’un UTF-8 invalide
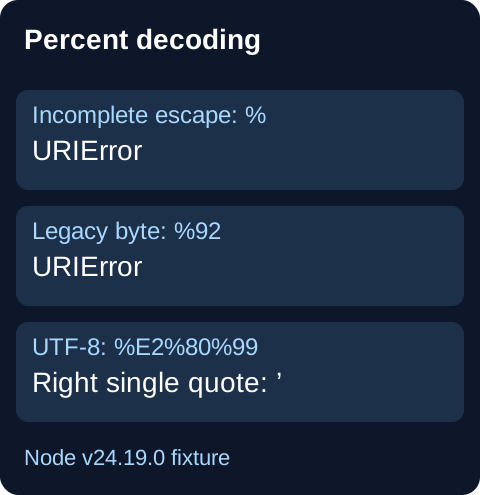
Un simple % ne possède pas les deux chiffres qui représentent un octet. En revanche, %92 est syntaxiquement un échappement d’octet, mais cet octet ne peut pas apparaître seul en UTF-8. Des signalements publics montrent ces deux erreurs, notamment des octets d’apostrophe issus d’anciens encodages et un %AF isolé.
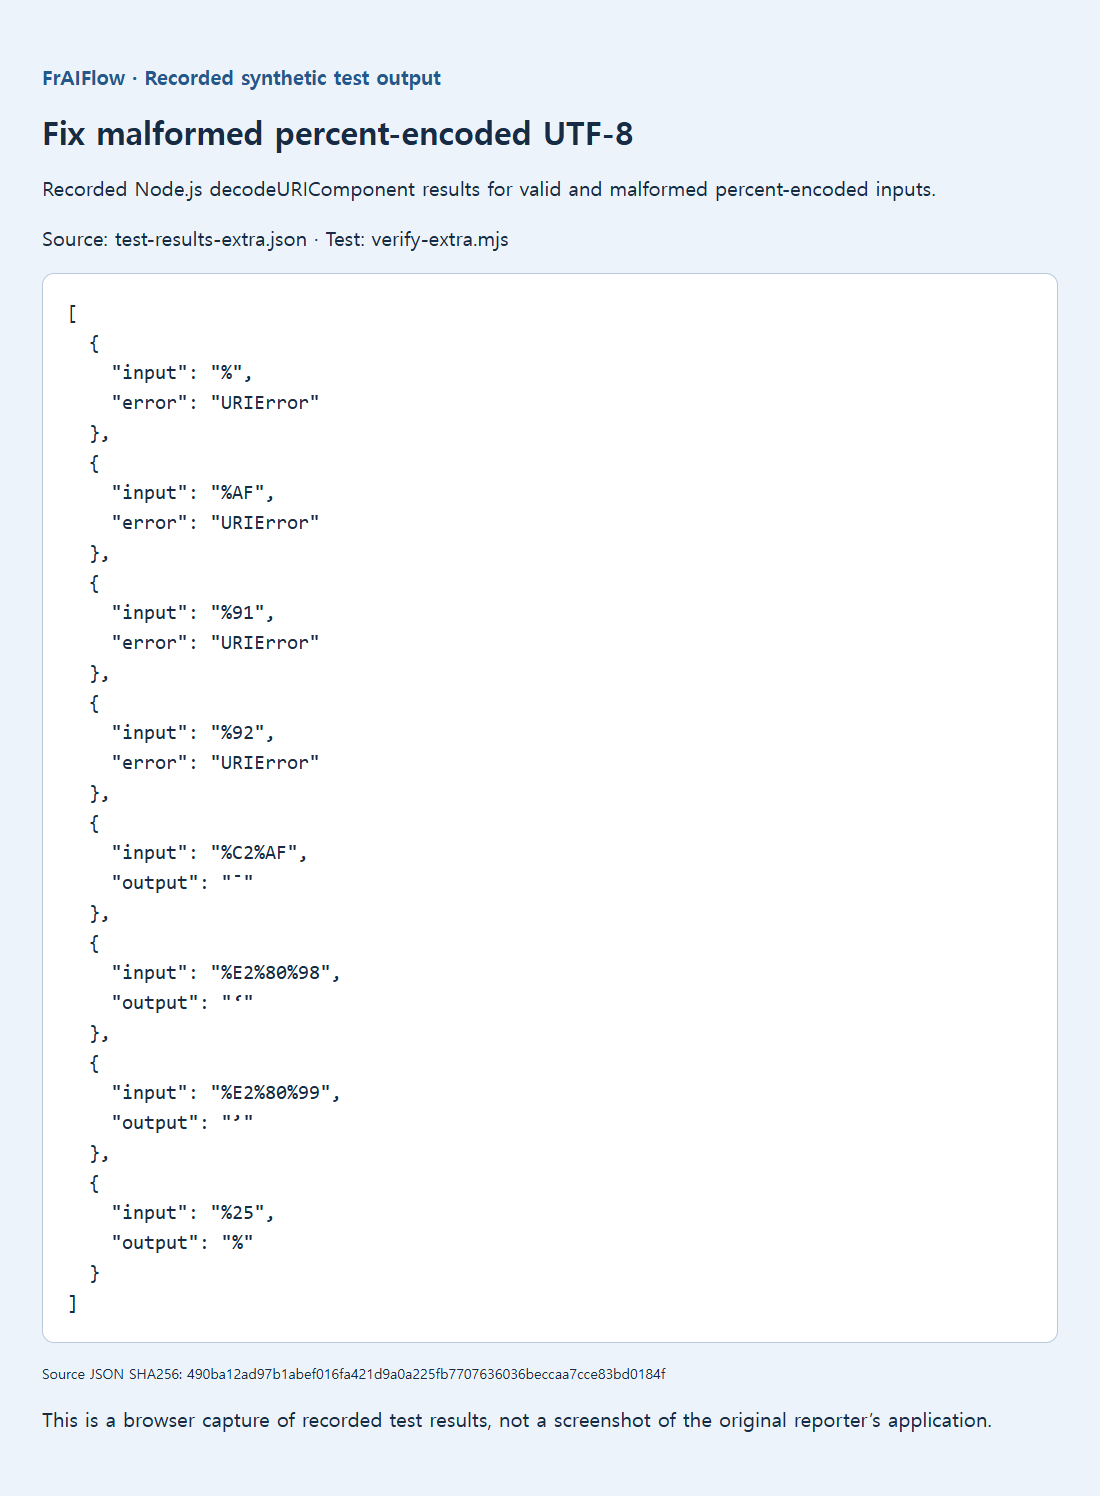
decodeURIComponent("%");          // URIError
 decodeURIComponent("%92");        // URIError
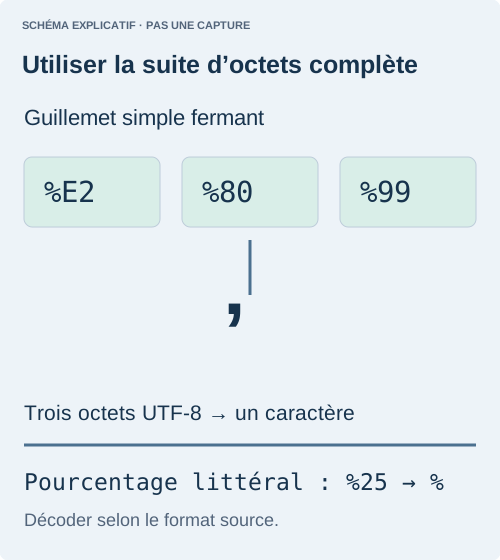
 decodeURIComponent("%25");        // %
 decodeURIComponent("%C2%AF");     // ¯
 decodeURIComponent("%E2%80%99"); // ’
Le jeu de test conservé sous Node v24.19.0 a reproduit ces résultats et a aussi testé %91, %AF et le guillemet simple ouvrant en UTF-8. Le libellé des erreurs peut varier selon le navigateur ; la preuve utile est l’acceptation ou le rejet de la saisie exacte.
Construisez les paramètres d’URL sans assembler les échappements à la main
Pour un nouveau lien, transmettez le texte original à l’API URL et laissez-la sérialiser le paramètre. À la réception, lisez ce paramètre avec la même API. Ne décodez pas immédiatement une seconde fois la valeur obtenue :
const link = new URL("https://example.com/search");
link.searchParams.set("q", "50% off & café");
const received = new URL(link.href).searchParams.get("q");
console.log(received); // 50% off & café
Cette URL sert d’exemple ; ce n’est pas un point d’accès FrAIFlow. L’essentiel est de distinguer une composante encodée d’une valeur déjà analysée. Un second décodage peut transformer un texte parfaitement légitime comme 50% off en exception. Souvenez-vous aussi qu’un signe plus dans des paramètres de formulaire est traité différemment d’un plus littéral transmis directement à decodeURIComponent() ; utilisez l’analyseur correspondant au format.
Corrigez le producteur au lieu de deviner les caractères
Conservez en privé l’exemple exact qui échoue et demandez au producteur quel encodage de caractères il a utilisé. Un %92 isolé peut évoquer une convention d’octets ancienne, mais l’octet seul ne prouve pas son origine. Ne remplacez pas silencieusement ce caractère par une apostrophe dans des identifiants de compte, signatures ou noms de fichier. Renvoyez une erreur utile, conservez la saisie originale pour l’utilisateur et corrigez l’encodage à la source lorsque c’est possible.
Après la correction, testez un pourcentage littéral, un mot accentué, une apostrophe typographique, un plus et une esperluette. Chaque valeur doit traverser l’aller-retour création du lien → ouverture → lecture sans changer. Une entrée mal formée doit déclencher l’erreur contrôlée, pas arrêter le reste de la page. Ces contrôles vérifient votre contrat de format ; ils ne justifient pas de décoder en boucle jusqu’à ce que le texte paraisse lisible.
Refuser une entrée mal formée sans faire échouer la page
function decodeComponent(value) {
  try { return { ok: true, value: decodeURIComponent(value) }; }
  catch (error) {
    if (!(error instanceof URIError)) throw error;
    return { ok: false, error: "Invalid encoded component" };
  }
}
Cette étape signale l’échec sans modifier silencieusement un identifiant. Elle ne peut pas découvrir un encodage source inconnu. Décodez seulement le nombre de fois prévu par le format : la présence d’un pourcentage après un décodage réussi ne justifie pas un nouveau passage. Évitez l’ancienne fonction unescape() comme correction UTF-8 et gardez les jetons et valeurs de requête privées hors des journaux publics de diagnostic.