Fehlerhaft prozentkodiertes UTF-8 richtig behandeln
Ein URL-Wert erreicht Ihre Anwendung, aber decodeURIComponent() löst URIError aus. Bevor Sie Satzzeichen ersetzen, unterscheiden Sie zwei Fehler: eine unvollständige Prozent-Escape-Sequenz und eine vollständige Byte-Escape-Sequenz, die kein gültiges UTF-8 bildet.
Finden Sie den Übergang, an dem sich der Wert verändert
Angenommen, ein Suchfeld akzeptiert 50% off, doch beim Öffnen des daraus erzeugten Links stürzt die Seite ab. Im Suchfeld ist das Prozentzeichen gewöhnlicher Text. Eine besondere Bedeutung bekommt es erst, wenn Code diesen Text als bereits kodierte URL-Komponente behandelt. Notieren Sie an jedem Übergang den erwarteten Wert: die Nutzereingabe, die serialisierte URL und den von der Zielseite gelesenen Wert. Sie suchen nach einer uneinheitlichen Kodierung, nicht nach Satzzeichen, die gelöscht werden müssten.
Verwenden Sie ein harmloses Beispiel, statt einen echten Link zum Zurücksetzen eines Passworts oder eine Kundenanfrage in eine Konsole oder einen öffentlichen Fehlerbericht zu kopieren. Testen Sie zuerst decodeURIComponent("%25"): Erwartet wird ein einzelnes Prozentzeichen. Prüfen Sie dann den fehlschlagenden Wert mit der abgesicherten Hilfsfunktion im Abschnitt „Ungültige Eingaben abfangen, ohne die Seite anzuhalten“. Funktioniert die gültige Kontrollprobe und scheitert nur das Beispiel, ist nicht der Decoder grundsätzlich defekt. Die übergebenen Daten müssen untersucht werden.
Unvollständige Escape-Sequenzen und ungültiges UTF-8 unterscheiden
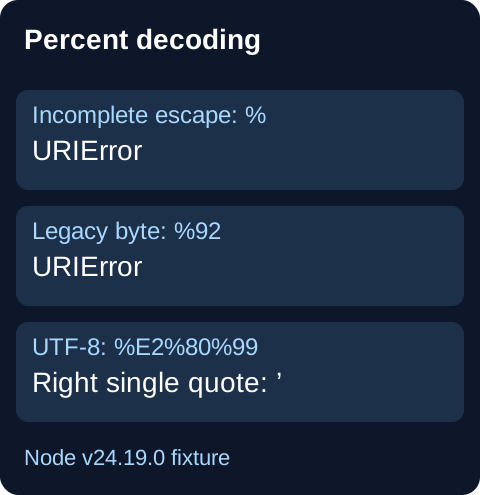
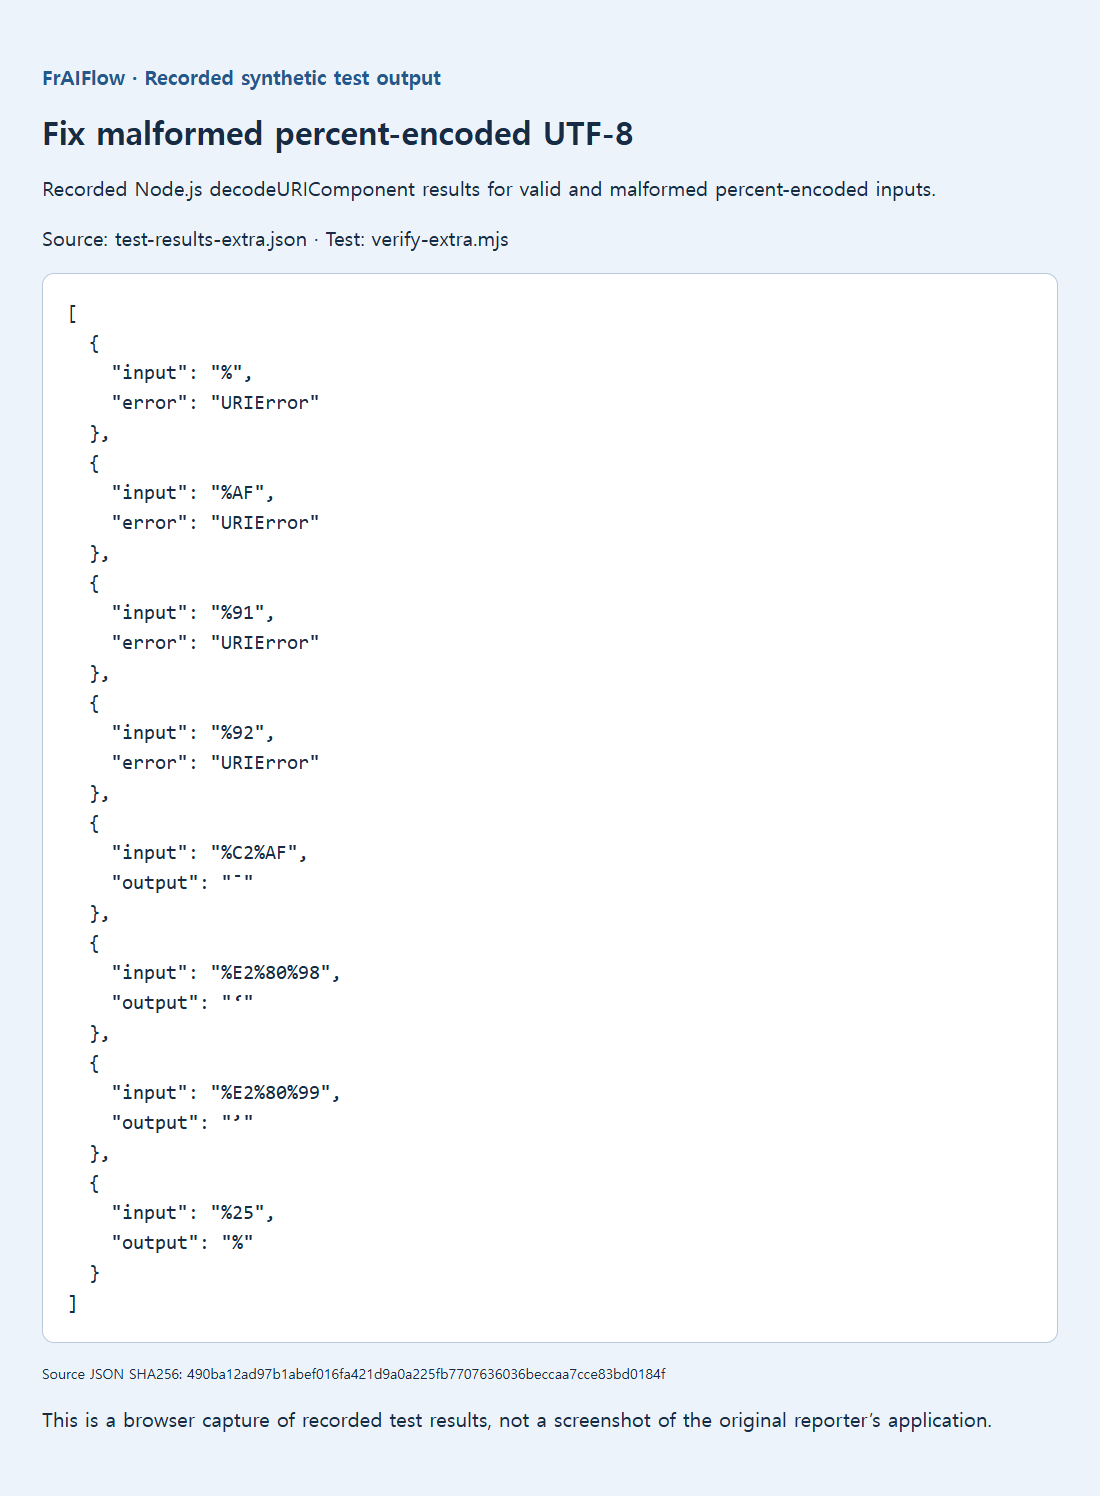
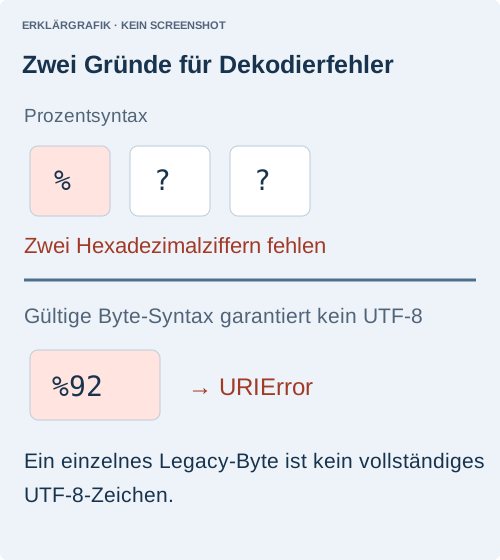
Ein einzelnes % enthält keinen zweistelligen Bytewert. Dagegen ist %92 syntaktisch eine Byte-Escape-Sequenz, doch dieses Byte kann in UTF-8 nicht allein stehen. Öffentliche Berichte zeigen beide Fehler, darunter Bytes für Anführungszeichen aus älteren Kodierungen und ein isoliertes %AF.
decodeURIComponent("%");          // URIError
 decodeURIComponent("%92");        // URIError
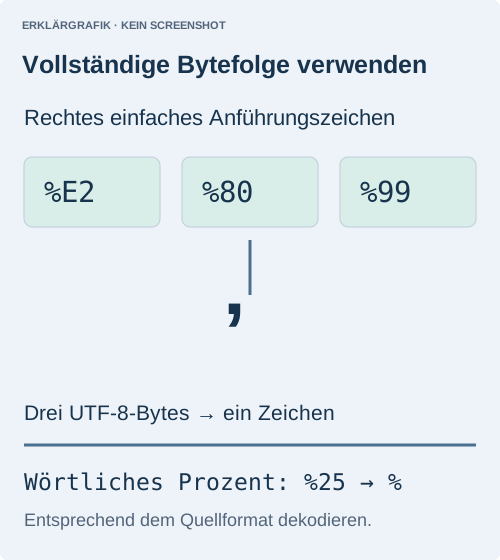
 decodeURIComponent("%25");        // %
 decodeURIComponent("%C2%AF");     // ¯
 decodeURIComponent("%E2%80%99"); // ’
Die erhaltenen Testdaten unter Node v24.19.0 reproduzierten diese Ergebnisse und prüften außerdem %91, %AF und das öffnende typografische Anführungszeichen in UTF-8. Im Browser kann die Fehlermeldung anders lauten. Entscheidend ist, ob genau diese Eingabe akzeptiert oder abgewiesen wird.
Query-Strings erzeugen, ohne Escape-Sequenzen von Hand zusammenzusetzen
Übergeben Sie für einen neuen Link den ursprünglichen Text an die URL-API und lassen Sie diese den Parameter serialisieren. Lesen Sie den Parameter auf der Empfängerseite mit derselben API. Dekodieren Sie den zurückgegebenen Wert nicht unmittelbar ein zweites Mal:
const link = new URL("https://example.com/search");
link.searchParams.set("q", "50% off & café");
const received = new URL(link.href).searchParams.get("q");
console.log(received); // 50% off & café
Dies ist eine Beispiel-URL, kein FrAIFlow-Endpunkt. Entscheidend ist der Unterschied zwischen einer kodierten Komponente und einem bereits eingelesenen Wert. Ein zweiter Dekodierungsschritt kann aus völlig zulässigem Text wie 50% off einen Fehler machen. Beachten Sie außerdem, dass ein Pluszeichen in formularartig kodierten Query-Parametern anders behandelt wird als ein direkt an decodeURIComponent() übergebenes Pluszeichen. Verwenden Sie den zum Format passenden Parser.
Korrigieren Sie den Erzeuger, statt Zeichen zu erraten
Bewahren Sie das genaue fehlschlagende Beispiel privat auf und fragen Sie den Erzeuger nach der verwendeten Zeichenkodierung. Ein einzelnes %92 kann auf eine ältere Bytekodierung hindeuten, belegt seine Herkunft aber nicht. Ersetzen Sie es in Konto-IDs, Signaturen oder Dateinamen nicht stillschweigend durch einen Apostroph. Geben Sie einen verständlichen Fehler zurück, erhalten Sie die ursprüngliche Eingabe für den Nutzer und korrigieren Sie nach Möglichkeit die Kodierung an der Quelle.
Prüfen Sie nach der Änderung ein wörtliches Prozentzeichen, ein Wort mit Akzent, ein typografisches Anführungszeichen, ein Pluszeichen und ein kaufmännisches Und. Jeder Wert muss den vollständigen Weg Link erzeugen → Link öffnen → Wert lesen unverändert überstehen. Fehlerhafte Eingaben sollen Ihren kontrollierten Fehler auslösen, nicht die restliche Seite anhalten. Diese Prüfungen bestätigen die vereinbarten Formatregeln; sie rechtfertigen nicht, so lange weiterzudekodieren, bis ein Text lesbar aussieht.
Ungültige Eingaben abfangen, ohne die Seite anzuhalten
function decodeComponent(value) {
  try { return { ok: true, value: decodeURIComponent(value) }; }
  catch (error) {
    if (!(error instanceof URIError)) throw error;
    return { ok: false, error: "Invalid encoded component" };
  }
}
Diese Hilfsfunktion meldet einen Fehler, ohne eine Kennung stillschweigend zu verändern. Eine unbekannte Quellkodierung kann er nicht ermitteln. Dekodieren Sie nur so oft, wie es die Formatvereinbarung vorsieht. Ein nach erfolgreicher Dekodierung verbleibendes Prozentzeichen rechtfertigt keinen weiteren Durchlauf. Verwenden Sie das veraltete unescape() nicht als UTF-8-Reparatur und halten Sie Tokens sowie private Abfragewerte aus öffentlichen Diagnoseprotokollen heraus.