Sửa UTF-8 mã hóa phần trăm sai định dạng
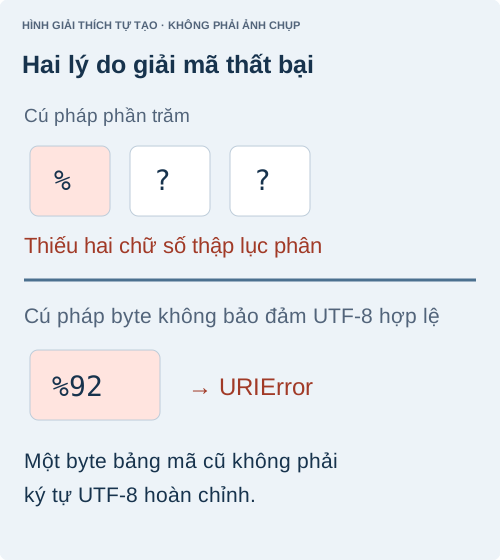
Giá trị URL đến ứng dụng nhưng decodeURIComponent() ném URIError. Trước khi thay dấu câu, tách hai lỗi: escape phần trăm chưa đủ và escape byte đầy đủ nhưng không phải UTF-8 hợp lệ.
Xác định giá trị bị thay đổi ở bước nào
Giả sử ô tìm kiếm nhận 50% off nhưng mở liên kết tạo ra làm trang lỗi. Dấu phần trăm là một ký tự thông thường trong ô tìm kiếm; nó chỉ đặc biệt khi mã coi văn bản đã là thành phần URL mã hóa. Ghi giá trị mong đợi ở từng ranh giới: chữ người dùng, URL tuần tự hóa, giá trị trang nhận đọc. Bạn đang tìm lệch mã hóa, không tìm dấu câu để xóa.
Dùng mẫu vô hại thay vì chép liên kết đặt lại mật khẩu hoặc truy vấn khách thật vào console hay issue công khai. Thử trước decodeURIComponent("%25"): kết quả mong đợi là một dấu phần trăm. Sau đó thử mẫu lỗi bằng hàm có bảo vệ trong phần “Từ chối đầu vào sai mà không làm trang lỗi” dưới. Nếu mẫu chuẩn được còn mẫu lỗi không, bộ giải mã không hỏng toàn bộ; dữ liệu cung cấp cần xem xét.
Phân biệt escape hỏng với UTF-8 không hợp lệ
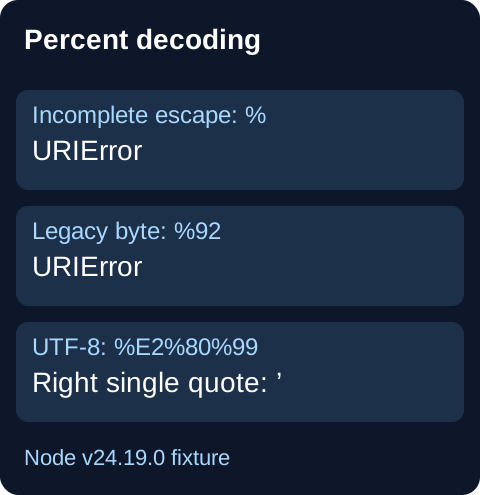
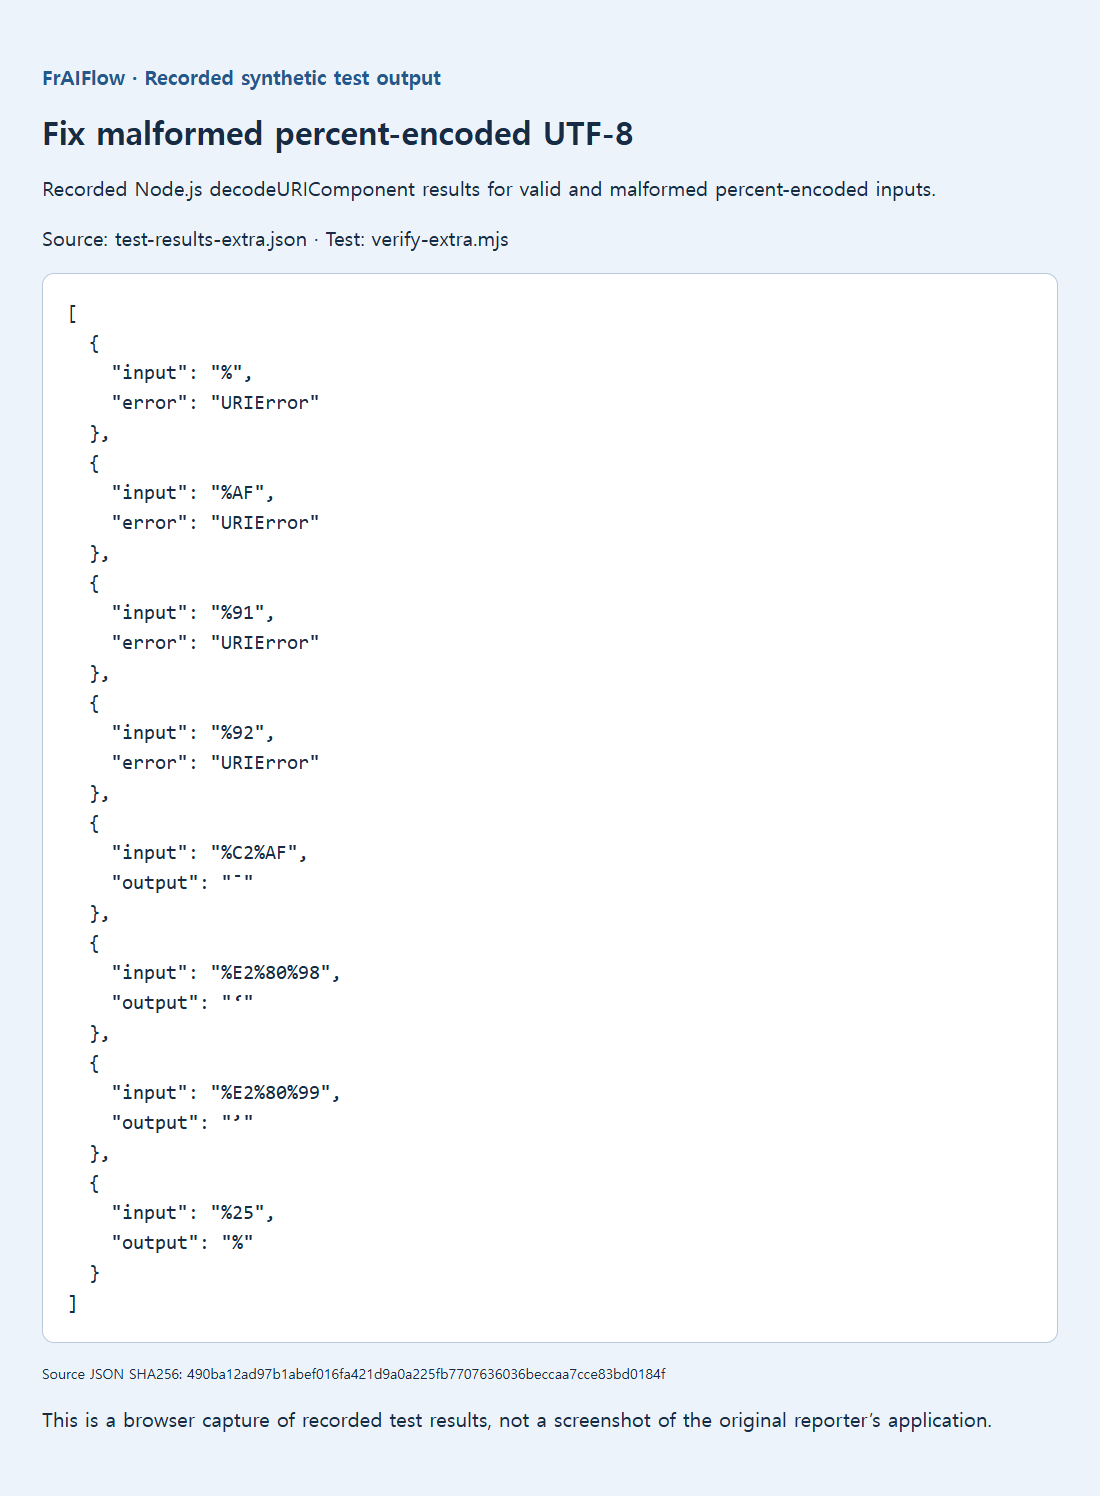
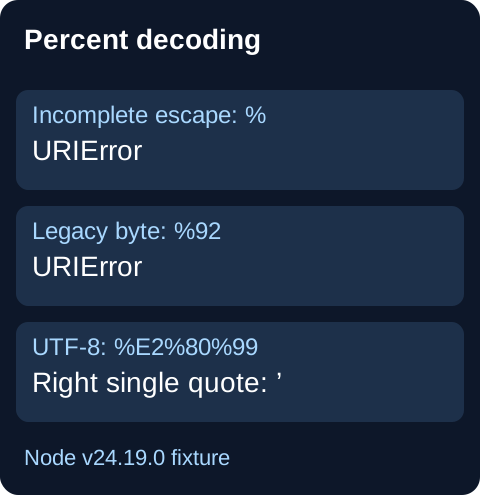
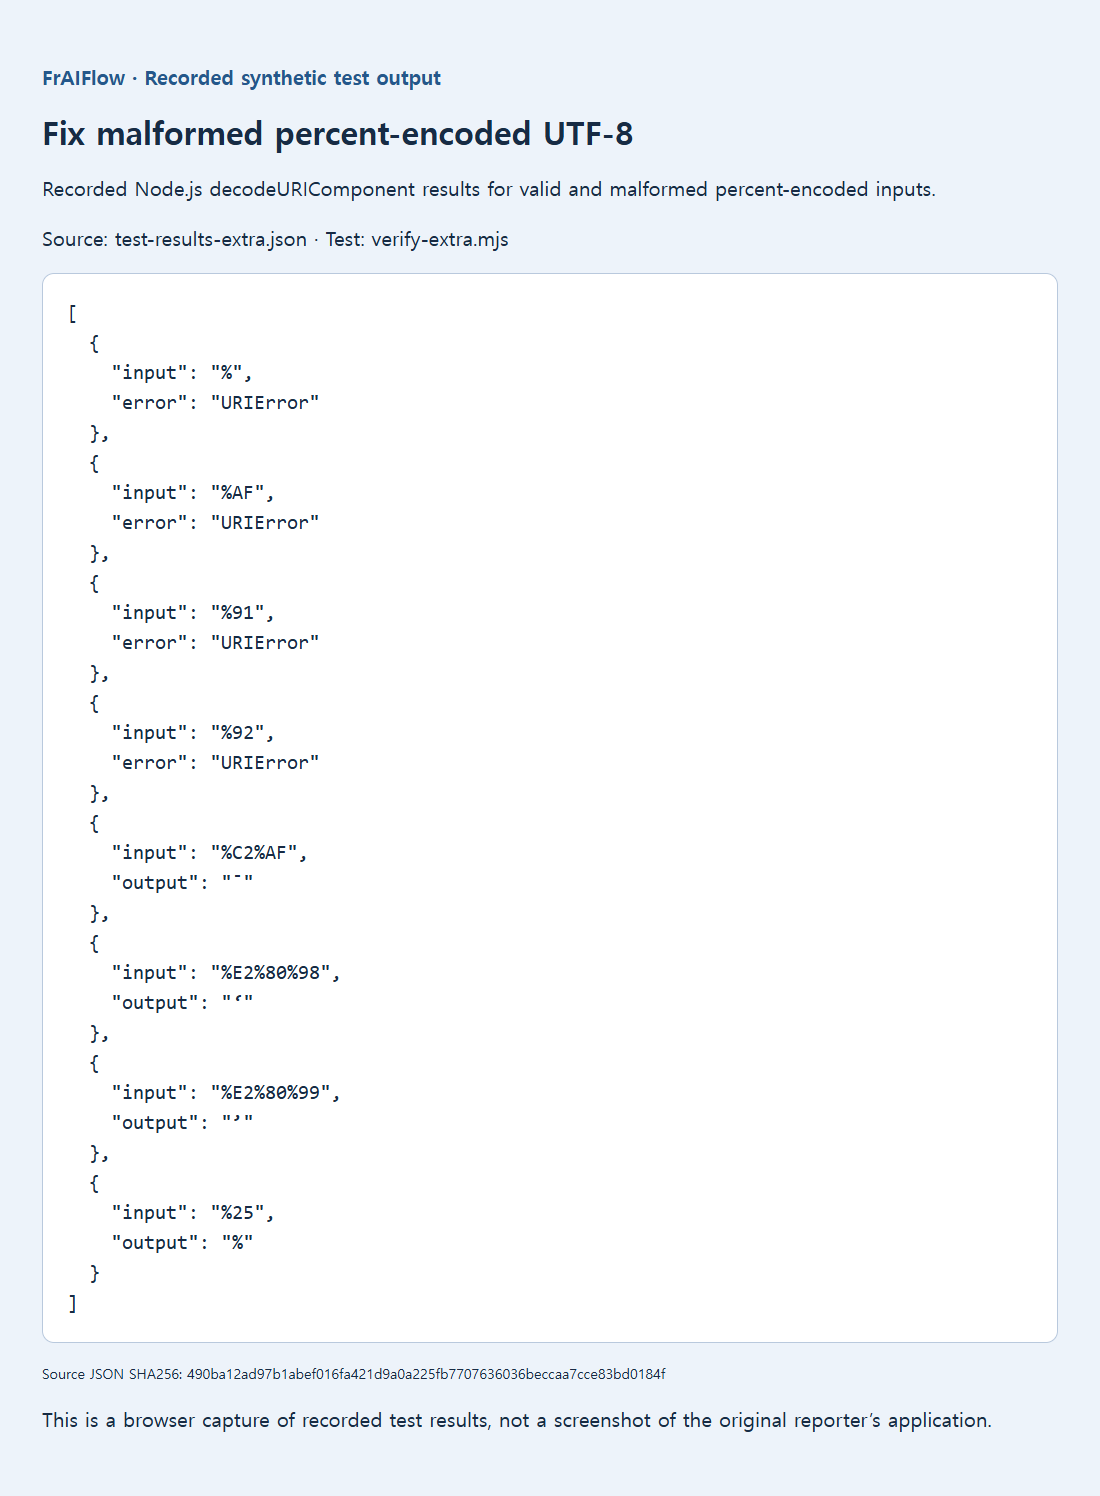
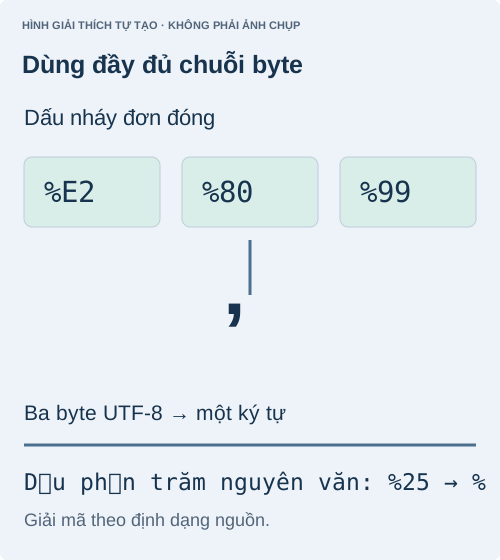
Một % đứng riêng không có giá trị byte hai chữ số. Ngược lại %92 đúng cú pháp escape byte, nhưng byte đó không đứng một mình trong UTF-8. Báo cáo công khai cho thấy cả hai, gồm byte dấu nháy trong bảng mã cũ và %AF riêng lẻ.
decodeURIComponent("%");          // URIError
 decodeURIComponent("%92");        // URIError
 decodeURIComponent("%25");        // %
 decodeURIComponent("%C2%AF");     // ¯
 decodeURIComponent("%E2%80%99"); // ’
Mẫu Node v24.19.0 được lưu tái hiện kết quả này và thử thêm %91, %AF và dấu nháy đơn mở UTF-8. Lời lỗi trình duyệt có thể khác; thành công hay từ chối đúng đầu vào mới là bằng chứng hữu ích.
Tạo chuỗi truy vấn mà không tự nối escape phần trăm
Với liên kết mới, đưa văn bản gốc vào URL API và để nó tuần tự hóa tham số. Phía nhận đọc qua cùng API. Đừng lập tức giải mã giá trị trả về thêm lần nữa:
const link = new URL("https://example.com/search");
link.searchParams.set("q", "50% off & café");
const received = new URL(link.href).searchParams.get("q");
console.log(received); // 50% off & café
Đây là URL ví dụ, không phải endpoint FrAIFlow. Phân biệt thành phần đã mã hóa với giá trị đã được phân tích. Giải mã lần hai có thể biến văn bản hoàn toàn hợp lệ như 50% off thành ngoại lệ. Cũng nhớ dấu cộng trong tham số kiểu form xử lý khác dấu cộng nguyên văn đưa trực tiếp vào decodeURIComponent(); dùng bộ phân tích đúng định dạng.
Sửa nơi tạo dữ liệu, đừng đoán ký tự bị lỗi
Giữ riêng tư mẫu lỗi chính xác và hỏi bên tạo dùng bảng mã nào. Một %92 đơn lẻ có thể gợi quy ước byte cũ nhưng riêng byte không xác lập nguồn. Đừng âm thầm thay bằng nháy đơn trong ID tài khoản, chữ ký hoặc tên tệp. Trả lỗi hữu ích, giữ đầu vào cho người dùng và sửa mã hóa từ nguồn khi được.
Sau thay đổi, thử phần trăm nguyên văn, từ có dấu, dấu nháy cong, dấu cộng và dấu &. Mỗi giá trị phải đi qua tạo liên kết → mở liên kết → đọc giá trị nguyên vẹn. Đầu vào sai phải cho lỗi có kiểm soát thay vì dừng phần còn lại trang. Các kiểm tra xác minh thỏa thuận định dạng, không cho phép giải mã liên tục đến khi chuỗi trông dễ đọc.
Từ chối đầu vào sai mà không làm trang lỗi
function decodeComponent(value) {
  try { return { ok: true, value: decodeURIComponent(value) }; }
  catch (error) {
    if (!(error instanceof URIError)) throw error;
    return { ok: false, error: "Invalid encoded component" };
  }
}
Ranh giới này báo thất bại mà không âm thầm sửa mã định danh. Nó không phát hiện bảng mã nguồn chưa biết. Chỉ giải mã số lần định dạng yêu cầu: còn phần trăm sau giải mã thành công không biện minh cho lượt nữa. Tránh unescape() đã lỗi thời như cách sửa UTF-8, giữ token và giá trị truy vấn riêng tư khỏi log chẩn đoán công khai.