パーセントエンコードされたUTF-8のエラーを直す
URLの値はアプリに届くのに、decodeURIComponent()でURIErrorになる。記号を置き換える前に、不完全なパーセントエスケープと、バイト表記としては完全でもUTF-8として不正な値を分けて考えましょう。
値が変わる境界を見つける
検索欄で50% offを受け付けたのに、その結果のリンクを開くとページが止まる場面を考えます。検索欄でのパーセントは普通の文字です。コードがそれを「すでにエンコードされたURL部品」として扱った時点で特別になります。利用者の文章、生成されたURL、受信ページが読み取った値という各境界で期待する内容を書き出してください。探しているのは削るべき記号ではなく、エンコードの食い違いです。
実際のパスワードリセットURLや顧客の検索内容をコンソールや公開Issueに貼るのではなく、無害なサンプルを使います。まずdecodeURIComponent("%25")を試し、パーセント一文字になるか確認してください。次に、下の「ページを止めずに不正入力を拒否する」の保護付き関数で失敗するサンプルを試します。正常な比較用データは動くのにサンプルが失敗するなら、デコーダー全体が壊れているのではなく、入力の調査が必要です。
壊れたエスケープと不正なUTF-8を区別する
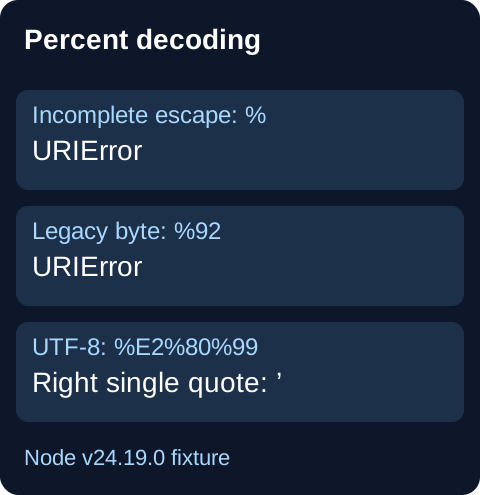
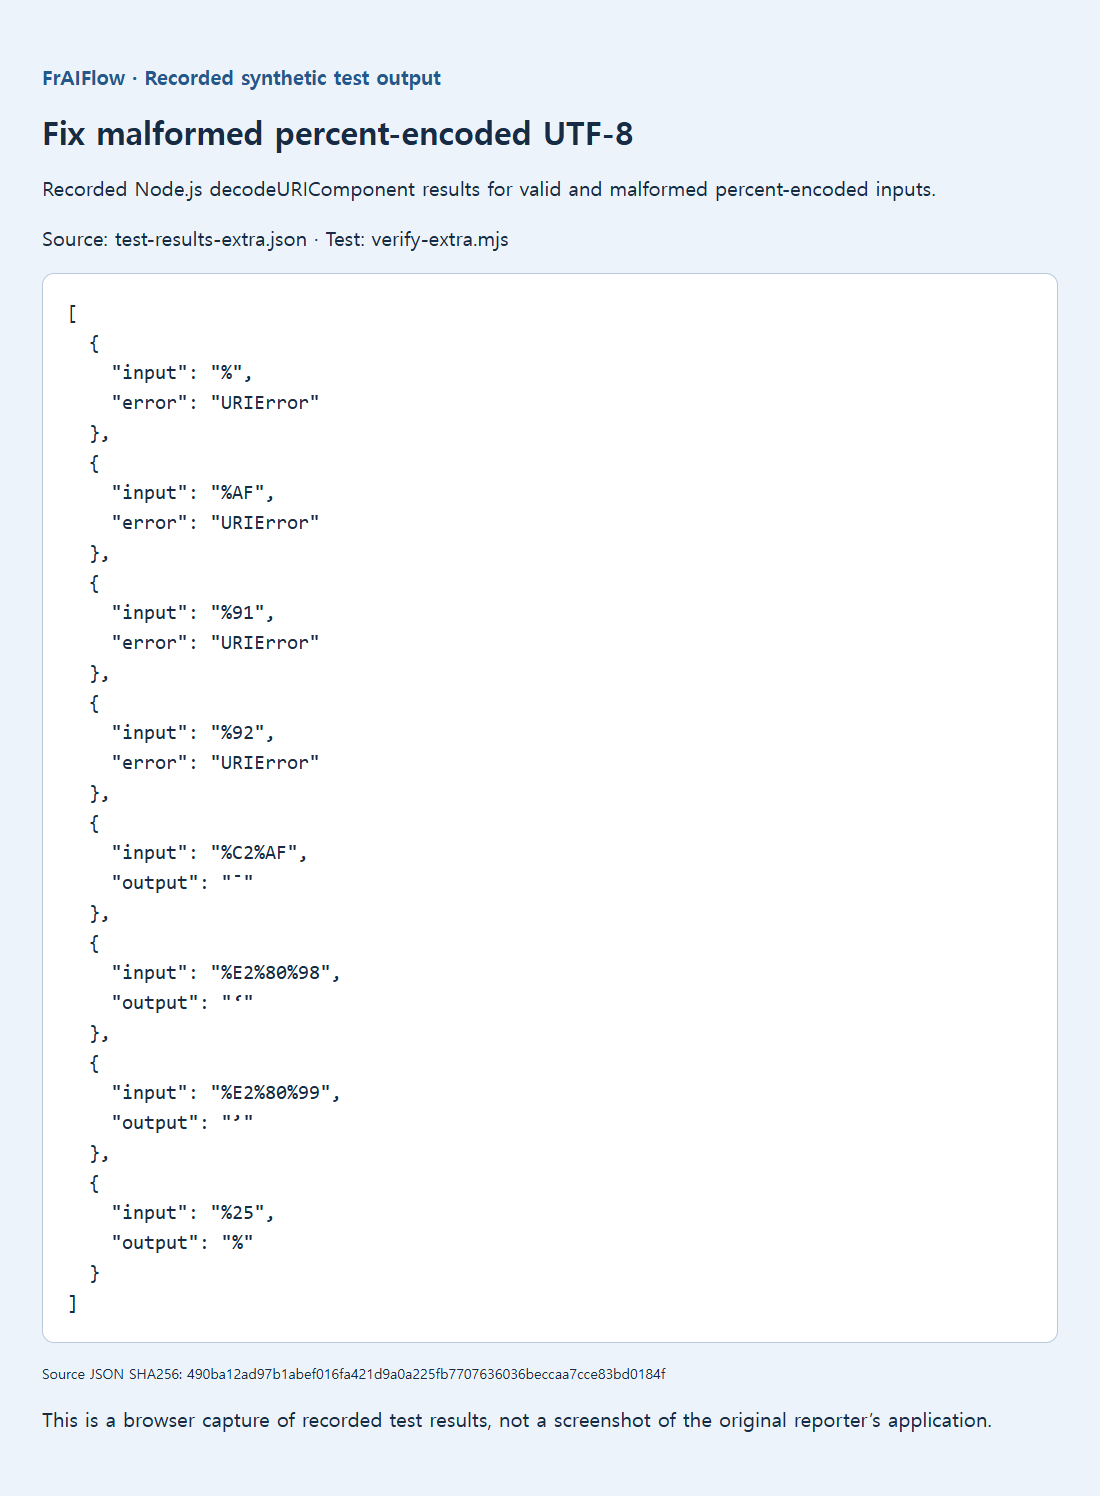
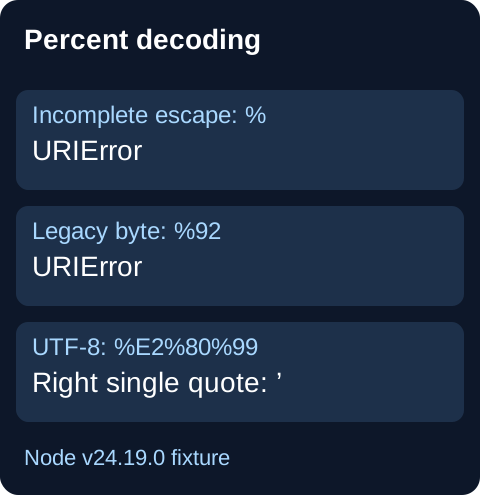
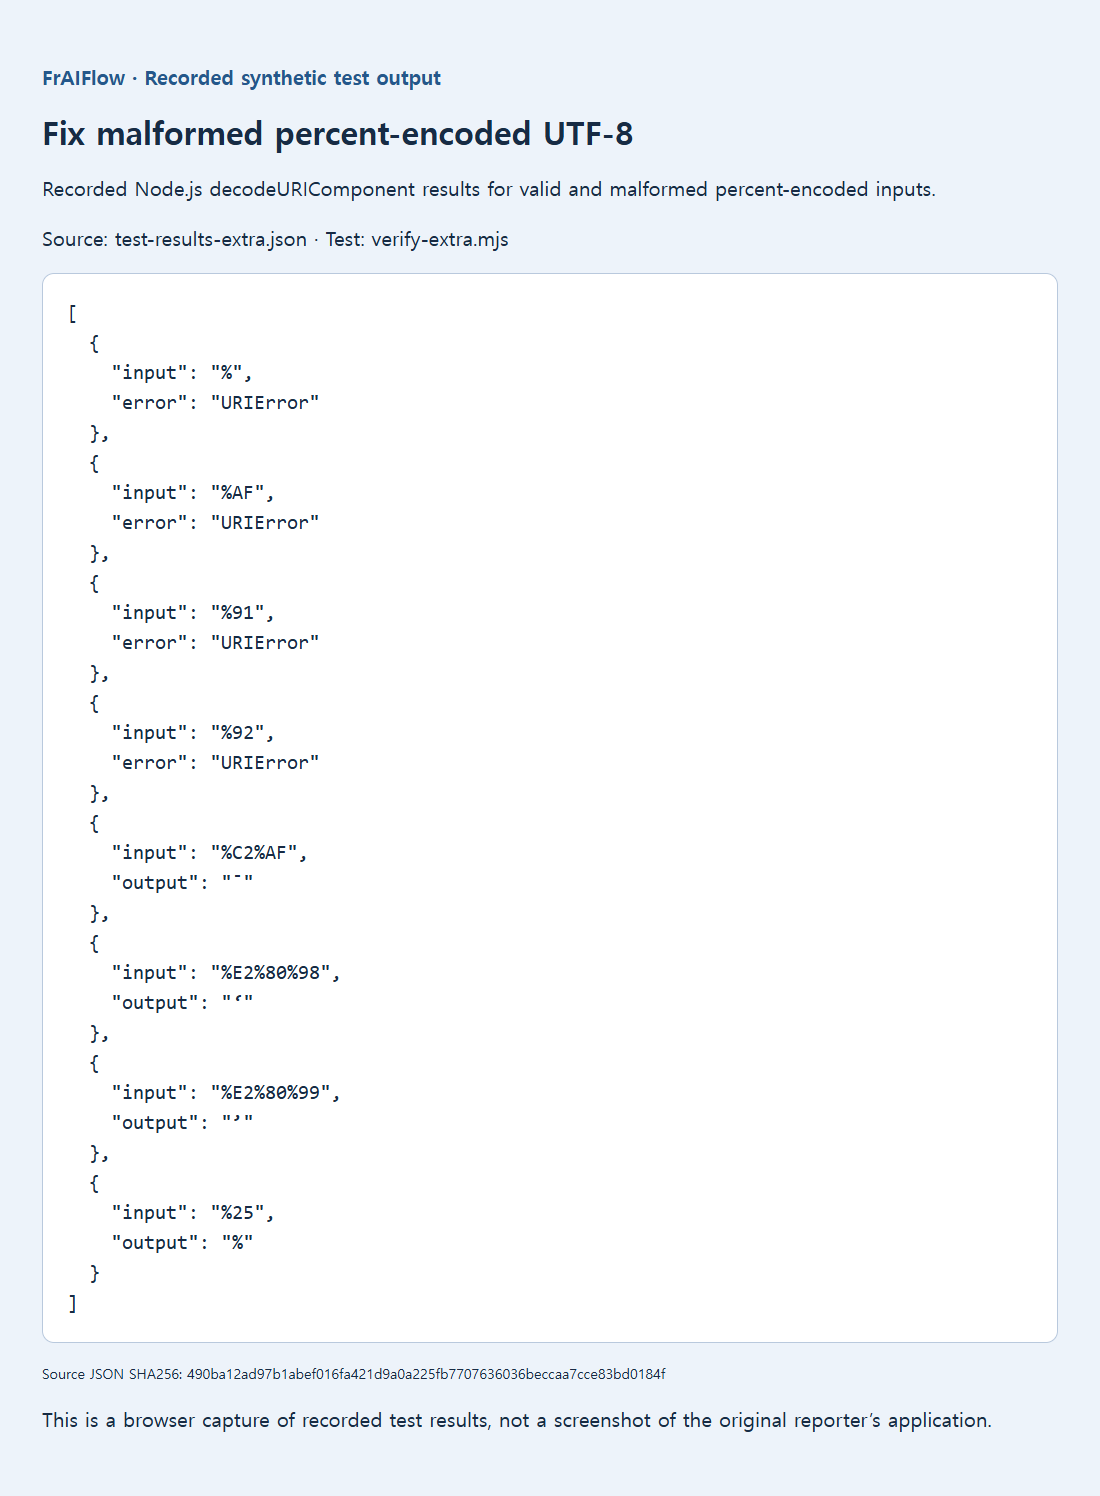
単独の%には、その後の2桁のバイト値がありません。一方、%92はバイトのエスケープ表記としては正しくても、そのバイトだけではUTF-8として成立しません。公開相談には古い文字コードの引用符バイトや、単独の%AFなど、両方の間違いが出てきます。
decodeURIComponent("%");          // URIError
 decodeURIComponent("%92");        // URIError
 decodeURIComponent("%25");        // %
 decodeURIComponent("%C2%AF");     // ¯
 decodeURIComponent("%E2%80%99"); // ’
保存済みのNode v24.19.0テストではこれらを再現し、%91、%AF、UTF-8の左引用符も試しました。ブラウザーによってエラー文は異なり得ます。証拠になるのは、正確な入力が成功したか拒否されたかです。
パーセント表記を手でつながず、URL APIを使う
新しいリンクを作るときは元の文章をURL APIに渡し、パラメーターの直列化を任せます。受信側も同じAPIでパラメーターを読みます。返された値を、すぐにもう一度デコードしないでください。
const link = new URL("https://example.com/search");
link.searchParams.set("q", "50% off & café");
const received = new URL(link.href).searchParams.get("q");
console.log(received); // 50% off & caféこれは説明用URLであり、FrAIFlowのエンドポイントではありません。重要なのは、エンコードされた部品と、すでに解析済みの値を区別することです。二重にデコードすると、50% offのような正当な文字列まで例外になります。また、フォーム形式のクエリーパラメーターのプラス記号と、直接decodeURIComponent()へ渡したプラス記号では扱いが異なります。形式に合うパーサーを使ってください。
文字を推測せず、生成側を直す
正確な失敗サンプルを非公開で保存し、生成側が使った文字コードを確認します。単独の%92は古いバイト表現を示唆することがありますが、そのバイトだけで出所は断定できません。アカウントID、署名、ファイル名の文字を黙ってアポストロフィに置き換えてはいけません。有用なエラーを返して元の入力を残し、可能なら生成側のエンコードを直しましょう。
変更後は、文字としてのパーセント、アクセント付きの単語、曲がった引用符、プラス記号、アンパサンドを試してください。リンク作成→リンクを開く→値を読み取るという往復で、それぞれが変わらず残る必要があります。不正入力ではページ全体を止めず、制御されたエラーにします。これは形式の取り決めを確認する試験であり、読めそうになるまで何度もデコードする理由にはなりません。
ページを止めずに不正入力を拒否する
function decodeComponent(value) {
  try { return { ok: true, value: decodeURIComponent(value) }; }
  catch (error) {
    if (!(error instanceof URIError)) throw error;
    return { ok: false, error: "Invalid encoded component" };
  }
}この境界処理はIDを黙って変えずに失敗を報告しますが、不明な元の文字コードを発見することはできません。形式の取り決めで必要な回数だけデコードしてください。成功後にパーセントが残っていても、もう一度処理すべきとは限りません。UTF-8の修正に非推奨のunescape()を使わず、トークンや非公開のクエリー値を公開の診断ログに残さないようにしましょう。