修正格式錯誤的百分比編碼 UTF-8
URL 參數傳到應用程式時,decodeURIComponent() 卻拋出 URIError。修改標點之前,請先分清楚兩種問題:百分比跳脫不完整,以及跳脫的位元組格式完整、卻不是有效 UTF-8。
找出值在哪個轉換邊界改變
假設搜尋框接受 50% off,開啟產生的連結卻讓頁面失敗。百分比符號在搜尋框中只是一般文字;只有程式把它當成已編碼的 URL 元件時,才有特殊意義。請列出每個邊界應有的值:使用者文字、序列化的 URL,以及接收頁讀出的值。要找的是編碼不一致,不是找標點來刪。
請使用無敏感資訊的範例,不要把真實的密碼重設連結或客戶查詢貼到主控台或公開問題單。先測試 decodeURIComponent("%25"),預期結果是一個百分比符號,再以本文下方「拒絕錯誤輸入,但不要讓整頁當掉」的小函式測試失敗範例。如果控制組有效而範例失敗,表示解碼器不是全面故障,應調查傳入的資料。
分清楚跳脫不完整,還是 UTF-8 無效
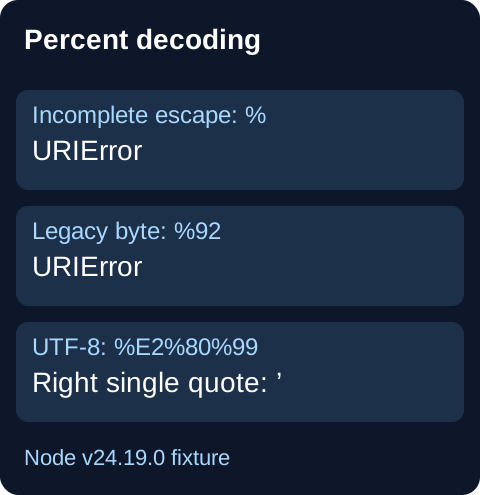
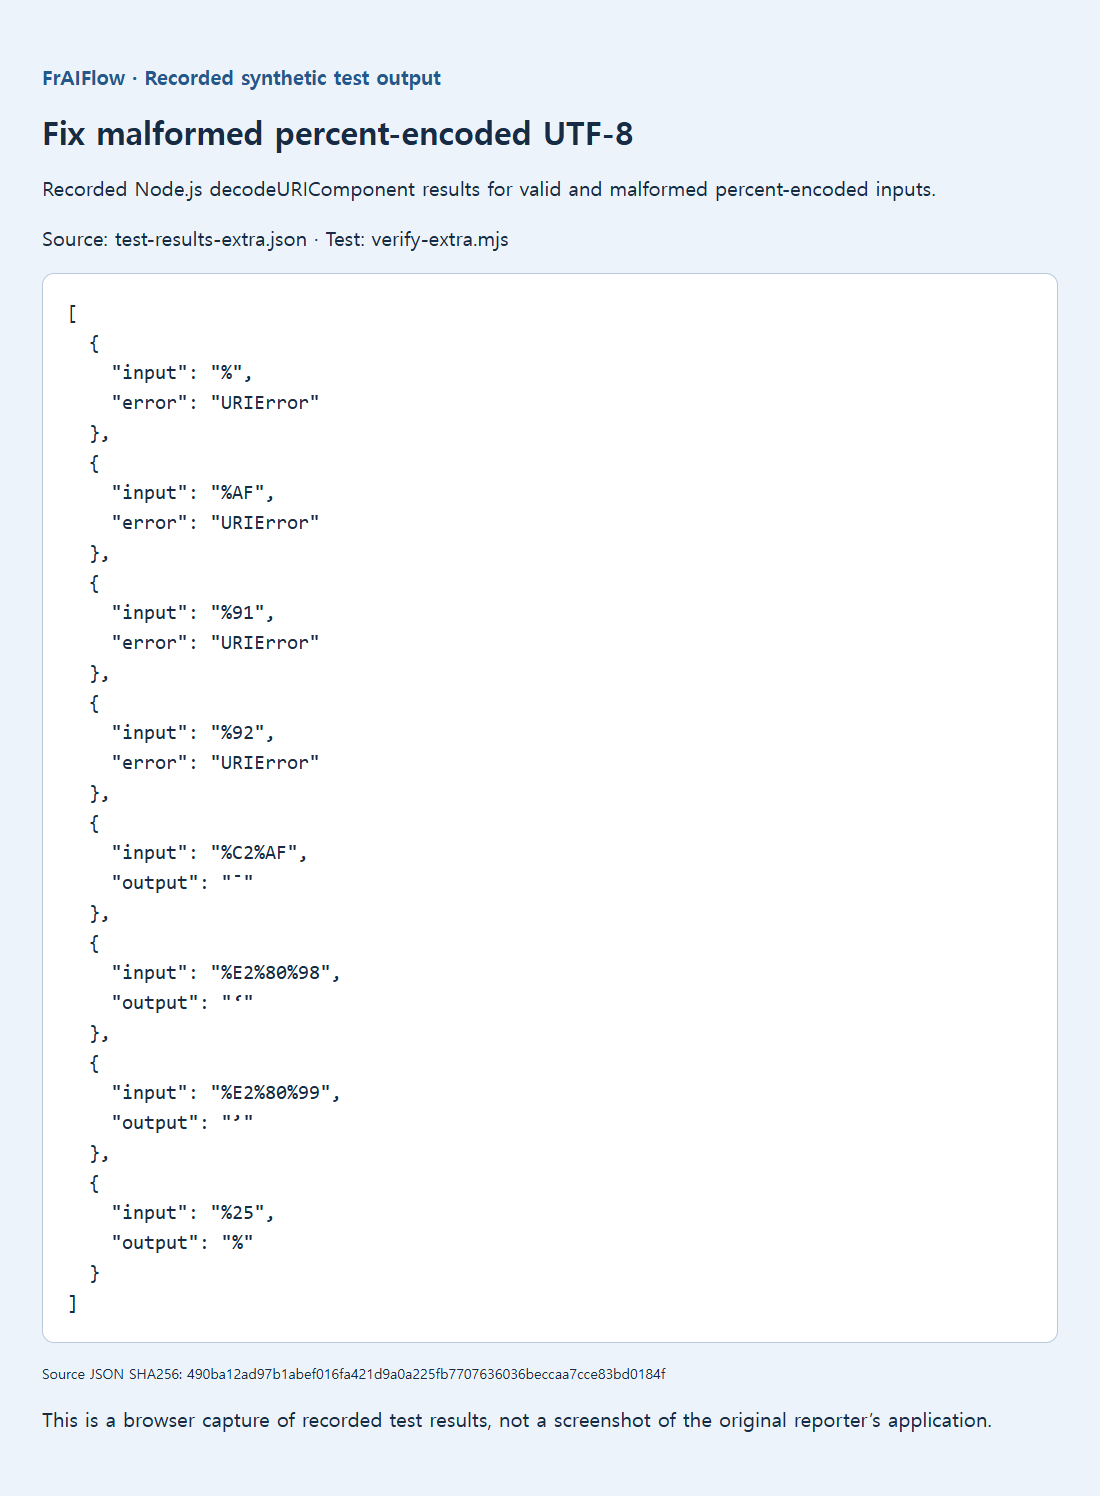
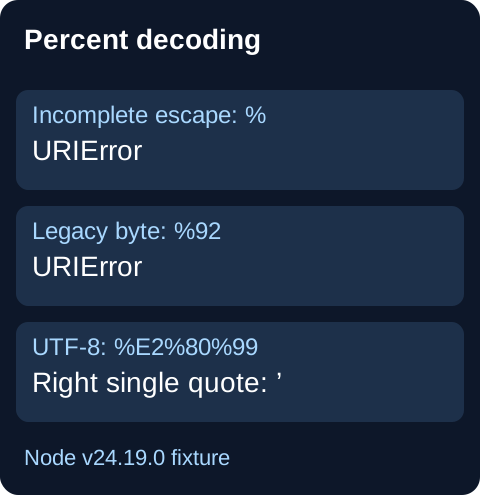
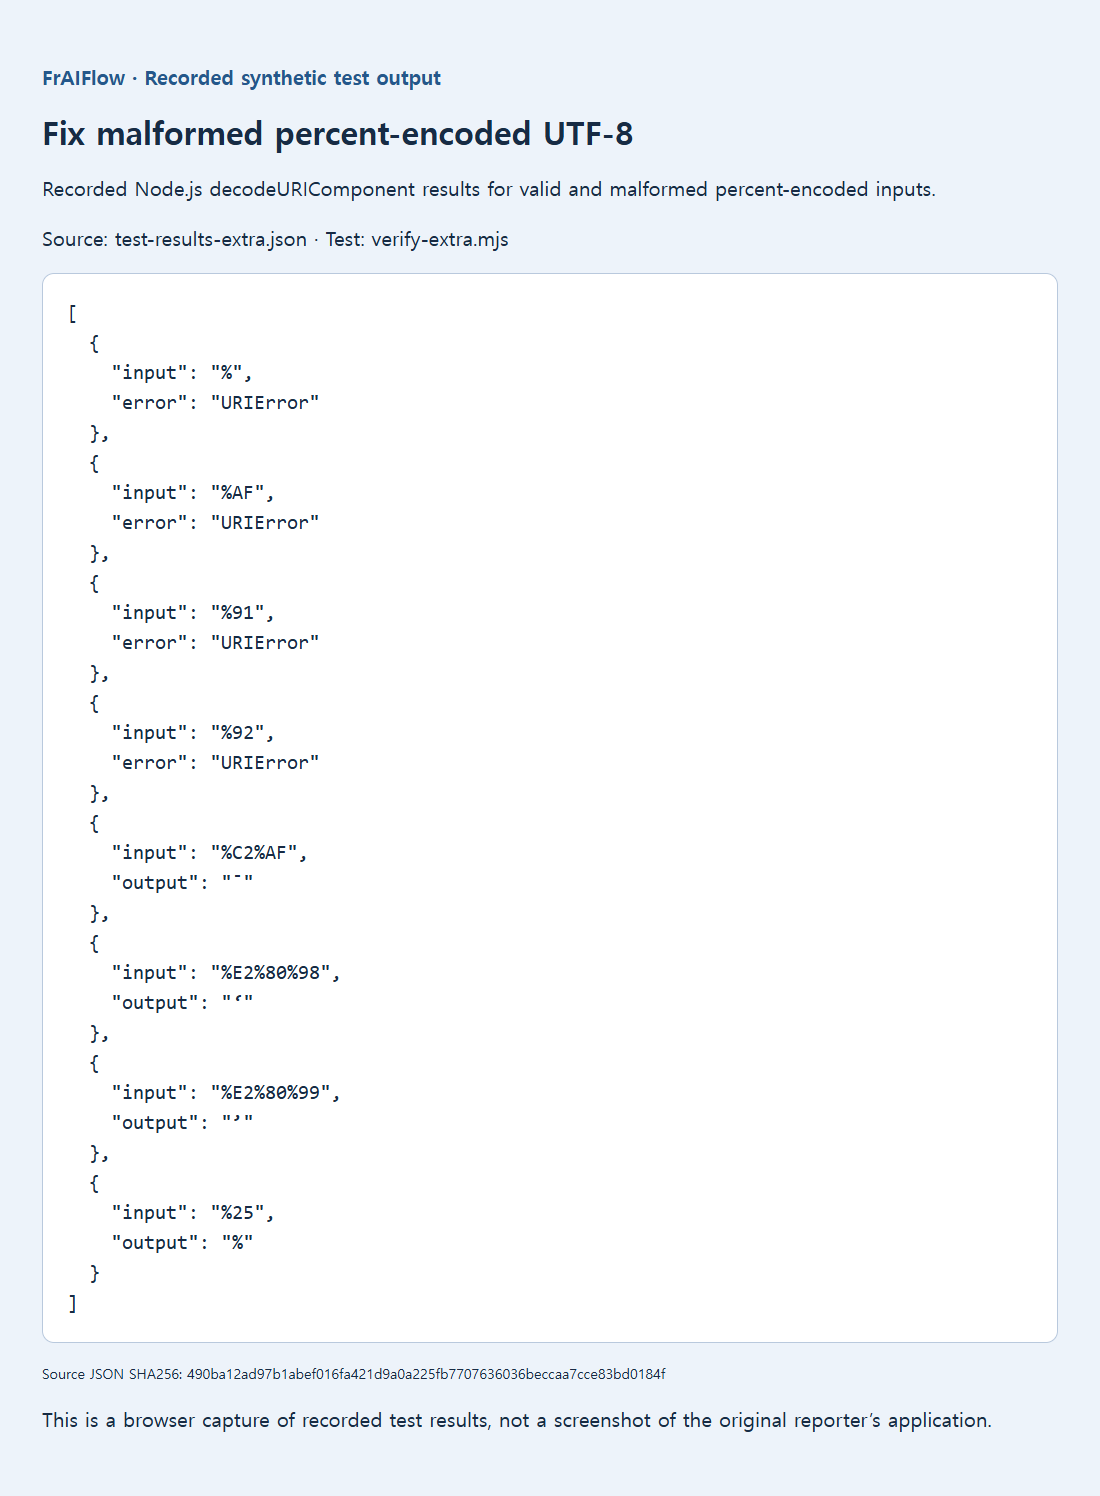
單獨的 % 後面沒有兩位十六進位的位元組值。相較之下,%92 在語法上是有效位元組跳脫,但該位元組不能單獨構成 UTF-8。公開案例包含這兩類錯誤,例如舊編碼的引號位元組,以及單獨出現的 %AF。
decodeURIComponent("%");          // URIError
 decodeURIComponent("%92");        // URIError
 decodeURIComponent("%25");        // %
 decodeURIComponent("%C2%AF");     // ¯
 decodeURIComponent("%E2%80%99"); // ’
保留的 Node v24.19.0 測試重現了這些結果,也測試了 %91、%AF 與 UTF-8 左引號。瀏覽器的錯誤措辭可能不同;真正有用的證據是指定輸入究竟成功還是被拒絕。
建立查詢字串時,不要手動拼接百分比跳脫
產生新連結時,將原始文字交給 URL API,讓它序列化參數。接收端也透過相同 API 讀取參數,不要立刻再對傳回值解碼:
const link = new URL("https://example.com/search");
link.searchParams.set("q", "50% off & café");
const received = new URL(link.href).searchParams.get("q");
console.log(received); // 50% off & café
這是範例 URL,不是 FrAIFlow 端點。關鍵在於區分「已編碼元件」與「已完成解析的值」。第二次解碼可能讓完全合法的文字,例如 50% off,變成例外。也請記得,表單形式查詢參數中的加號,與直接傳入 decodeURIComponent() 的字面加號,處理方式不同;應選擇符合格式的解析器。
修正產生端,不要猜測應替換成哪個字元
私下保留完整的失敗範例,詢問產生端使用哪種字元編碼。單獨的 %92 可能暗示舊式位元組編碼,但光看這個位元組無法確定來源。帳戶 ID、簽章或檔名中的字元,不應默默替換成單引號。應回傳實用的錯誤訊息、保留使用者原始輸入,並盡可能從來源修正編碼。
修改後,請測試字面的百分比符號、帶重音的單字、彎引號、加號與 &。每個值都應在「建立連結 → 開啟連結 → 讀取值」往返後保持不變。格式錯誤的輸入應得到受控錯誤,而不是讓頁面其餘部分停止。這些檢查用來確認格式約定,不代表可以反覆解碼,直到字串看起來可讀。
拒絕錯誤輸入,但不要讓整頁當掉
function decodeComponent(value) {
  try { return { ok: true, value: decodeURIComponent(value) }; }
  catch (error) {
    if (!(error instanceof URIError)) throw error;
    return { ok: false, error: "Invalid encoded component" };
  }
}
這個處理邊界會回報失敗,不會默默改變識別碼,但它無法推斷未知的來源編碼。解碼次數只應符合格式約定;成功解碼後仍有百分比符號,不構成再解碼一次的理由。不要把已淘汰的 unescape() 當成 UTF-8 修復方法,公開診斷紀錄也不要放入權杖或私人查詢值。