Rett feilformet prosentkodet UTF-8
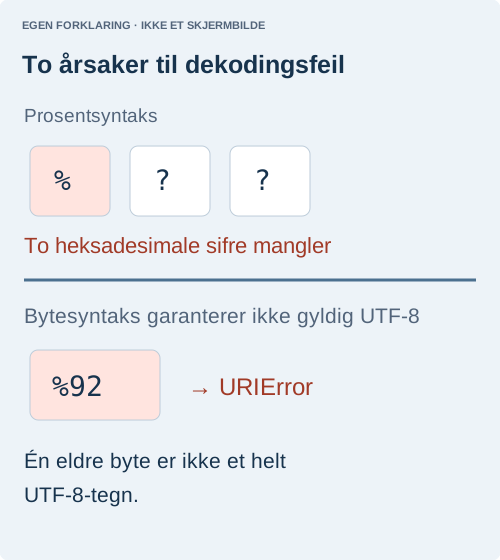
En URL-verdi når programmet ditt, men decodeURIComponent() kaster URIError. Før du erstatter tegnsetting, skill mellom to feil: en ufullstendig prosentsekvens og en fullstendig bytesekvens som ikke er gyldig UTF-8.
Finn grensen der verdien endres
Anta at et søkefelt godtar 50% off, men siden krasjer når den resulterende lenken åpnes. Prosenttegnet er vanlig tekst i søkefeltet. Det får spesiell betydning først når kode behandler teksten som en allerede kodet URL-komponent. Noter forventet verdi ved hver grense: brukerens tekst, den serialiserte URL-en og verdien mottakersiden leser. Du leter etter ulik koding, ikke tegnsetting som skal slettes.
Bruk et ufarlig eksempel i stedet for å kopiere en ekte lenke for passordtilbakestilling eller et kundesøk til konsollen eller en offentlig sak. Prøv først decodeURIComponent("%25"): Forventet resultat er ett prosenttegn. Prøv deretter eksemplet som feiler, med den beskyttede hjelpefunksjonen under «Avvis feilformede inndata uten at siden krasjer». Hvis den gyldige kontrollen virker, men eksemplet feiler, er ikke dekoderen generelt ødelagt. Dataene som gis inn må undersøkes.
Skill en ødelagt sekvens fra ugyldig UTF-8
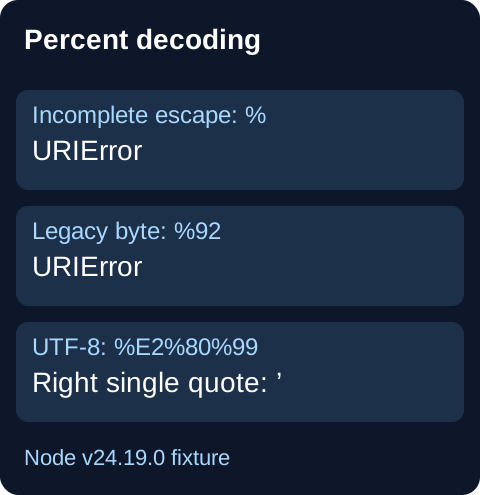
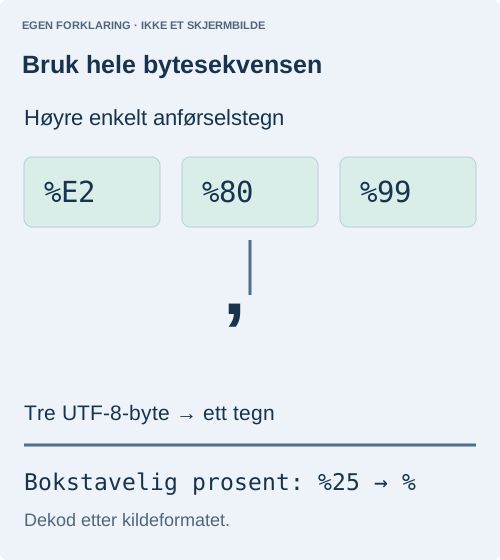
Et enkelt % mangler en tosifret byteverdi. Derimot er %92 syntaktisk en bytesekvens, men byten kan ikke stå alene i UTF-8. Offentlige rapporter viser begge feilene, blant annet eldre anførselstegnbyte og et isolert %AF.
decodeURIComponent("%");          // URIError
 decodeURIComponent("%92");        // URIError
 decodeURIComponent("%25");        // %
 decodeURIComponent("%C2%AF");     // ¯
 decodeURIComponent("%E2%80%99"); // ’
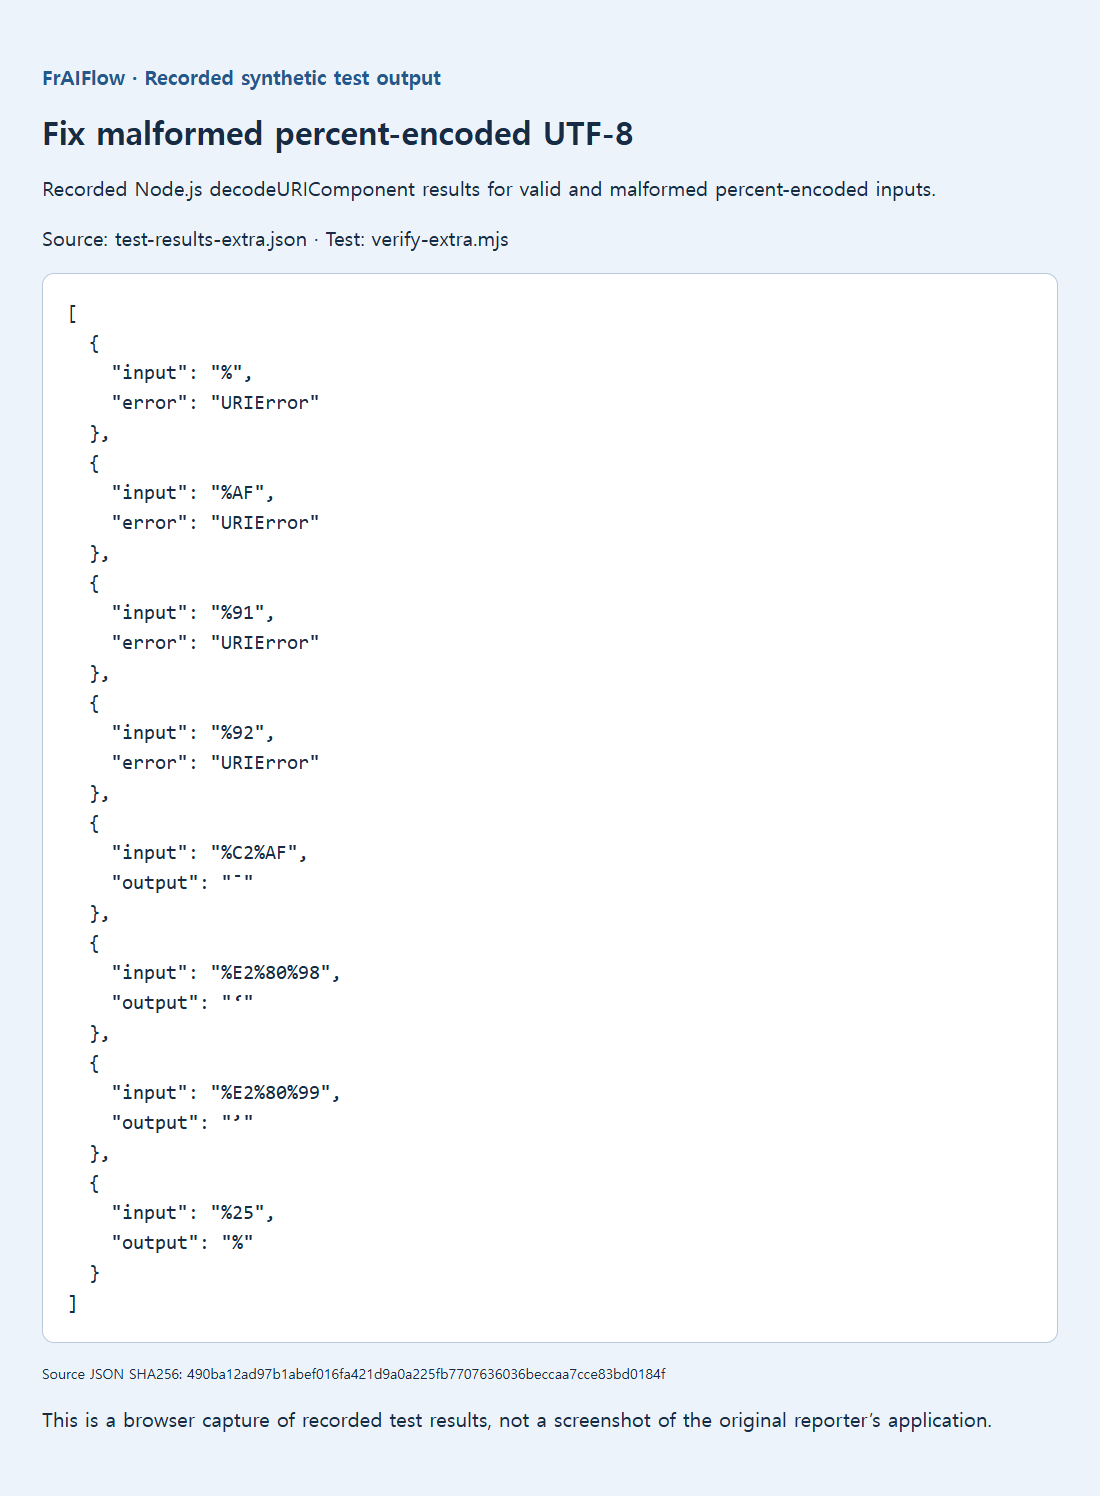
Den bevarte testen i Node v24.19.0 gjenskapte disse resultatene og testet også %91, %AF og venstre anførselstegn i UTF-8. Nettlesere kan formulere feilen annerledes. Det nyttige beviset er om akkurat disse inndataene godtas eller avvises.
Bygg spørringsstrenger uten å sette sammen prosentsekvenser for hånd
For en ny lenke sender du originalteksten til URL-API-et og lar det serialisere parameteren. På mottakersiden leser du parameteren gjennom samme API. Ikke dekod den returnerte verdien en gang til med det samme:
const link = new URL("https://example.com/search");
link.searchParams.set("q", "50% off & café");
const received = new URL(link.href).searchParams.get("q");
console.log(received); // 50% off & café
Dette er en eksempel-URL, ikke et FrAIFlow-endepunkt. Det viktige skillet går mellom en kodet komponent og en verdi som allerede er tolket. En ny dekoding kan gjøre helt legitim tekst som 50% off til et unntak. Husk også at plusstegn i skjemalignende spørringsparametere behandles annerledes enn et bokstavelig plusstegn sendt direkte til decodeURIComponent(). Bruk parseren som passer til formatet.
Rett produsenten i stedet for å gjette tegn
Behold det nøyaktige feileksemplet privat og spør produsenten hvilken tegnkoding som ble brukt. Et enslig %92 kan tyde på en eldre bytekonvensjon, men byten alene fastslår ikke opprinnelsen. Ikke erstatt den lydløst med en apostrof i konto-ID-er, signaturer eller filnavn. Returner en nyttig feil, bevar originalinndataene for brukeren, og rett kodingen ved kilden når det er mulig.
Etter endringen tester du et bokstavelig prosenttegn, et ord med aksent, et buet anførselstegn, et plusstegn og et ampersand. Hver verdi skal være uendret etter hele runden lag lenke → åpne lenke → les verdi. Feilformede inndata skal gi den kontrollerte feilen din, ikke stoppe resten av siden. Kontrollene bekrefter formatavtalen. De rettferdiggjør ikke gjentatt dekoding til en streng ser lesbar ut.
Avvis feilformede inndata uten at siden krasjer
function decodeComponent(value) {
  try { return { ok: true, value: decodeURIComponent(value) }; }
  catch (error) {
    if (!(error instanceof URIError)) throw error;
    return { ok: false, error: "Invalid encoded component" };
  }
}
Denne grensen rapporterer feil uten å endre en identifikator i stillhet. Den kan ikke oppdage en ukjent kildekoding. Dekod bare så mange ganger som formatavtalen krever. Et prosenttegn som står igjen etter vellykket dekoding, rettferdiggjør ikke en ny runde. Unngå den utgåtte unescape() som UTF-8-løsning, og hold tokener og private spørringsverdier unna offentlige diagnoselogger.