Åtgärda felaktig procentkodad UTF-8
Ett URL-värde når appen, men decodeURIComponent() kastar URIError. Skilj två fel åt innan du ersätter skiljetecken: en ofullständig procentsekvens och en fullständig bytekod som inte är giltig UTF-8.
Hitta gränsen där värdet ändras
Anta att en sökruta accepterar 50% off men sidan kraschar när den skapade länken öppnas. Procenttecknet är vanlig text i sökrutan. Det blir speciellt först när kod behandlar texten som en redan kodad URL-komponent. Anteckna förväntat värde vid varje gräns: användarens text, serialiserad URL och värdet mottagarsidan läser. Du letar efter kodningsavvikelse, inte skiljetecken att radera.
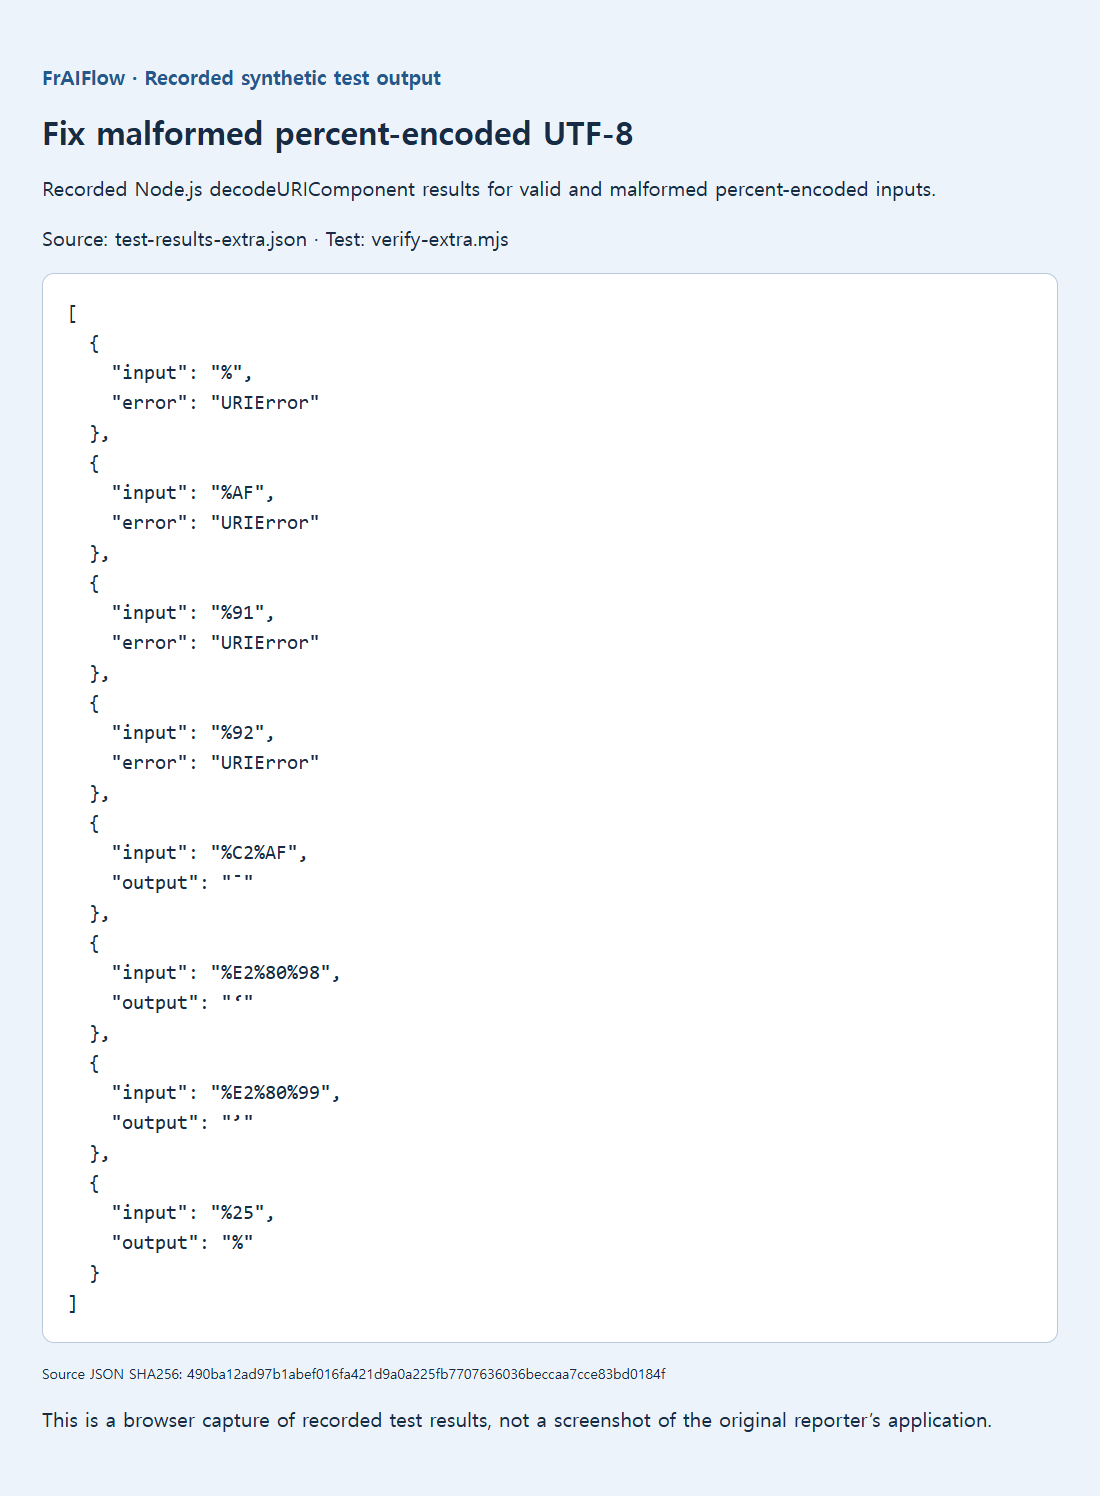
Använd ett ofarligt exempel i stället för att kopiera en riktig lösenordsåterställningslänk eller kundfråga till konsol eller offentligt ärende. Prova först decodeURIComponent("%25"): förväntat resultat är ett enda procenttecken. Prova sedan problemexemplet med den skyddade hjälpfunktionen i ”Avvisa felaktig indata utan att krascha sidan” nedan. Om det giltiga kontrollexemplet fungerar men det andra misslyckas är avkodaren inte generellt trasig; datan behöver undersökas.
Skilj en trasig procentsekvens från ogiltig UTF-8
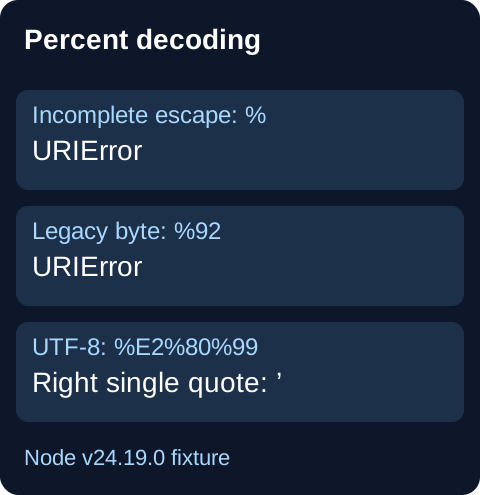
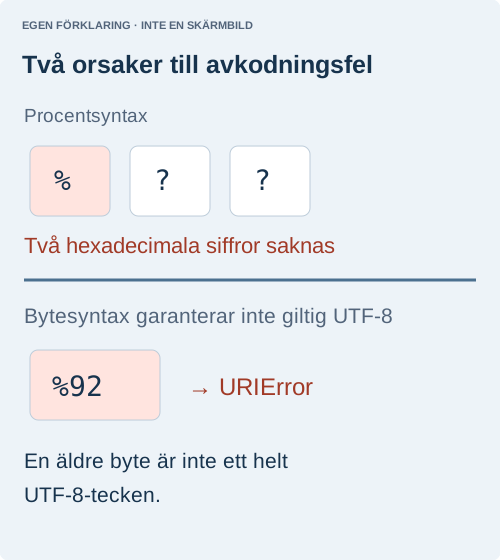
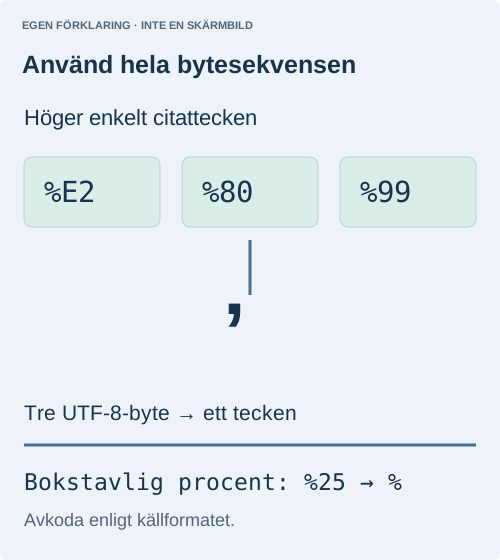
Ett ensamt % saknar ett tvåsiffrigt bytevärde. Däremot är %92 syntaktiskt en bytekod, men den byten kan inte stå ensam i UTF-8. Offentliga rapporter visar båda misstagen, bland annat äldre citatteckenbyte och ett isolerat %AF.
decodeURIComponent("%");          // URIError
 decodeURIComponent("%92");        // URIError
 decodeURIComponent("%25");        // %
 decodeURIComponent("%C2%AF");     // ¯
 decodeURIComponent("%E2%80%99"); // ’
Det bevarade Node v24.19.0-testet återskapade utfallen och testade även %91, %AF och vänster citattecken i UTF-8. Webbläsarnas feltext kan skilja sig; om exakt indata lyckas eller avvisas är det användbara underlaget.
Bygg frågesträngar utan att foga ihop procentsekvenser för hand
För en ny länk skickar du originaltexten till URL-API:et och låter det serialisera parametern. På mottagarsidan läser du parametern genom samma API. Avkoda inte det returnerade värdet direkt en gång till:
const link = new URL("https://example.com/search");
link.searchParams.set("q", "50% off & café");
const received = new URL(link.href).searchParams.get("q");
console.log(received); // 50% off & café
Detta är en exempel-URL, inte en FrAIFlow-ändpunkt. Skillnaden är mellan en kodad komponent och ett värde som redan har tolkats. En andra avkodning kan göra helt legitim text som 50% off till ett undantag. Kom också ihåg att plus i formulärliknande frågeparametrar hanteras annorlunda än ett bokstavligt plus skickat direkt till decodeURIComponent(). Använd parsern som passar formatet.
Rätta producenten i stället för att gissa tecken
Behåll exakt problemexempel privat och fråga producenten vilken teckenkodning som användes. Ett ensamt %92 kan antyda en äldre bytekonvention, men byten ensam fastställer inte ursprunget. Ersätt inte tyst med en apostrof i konto-ID:n, signaturer eller filnamn. Returnera ett användbart fel, behåll användarens originalindata och rätta om möjligt kodningen vid källan.
Testa efter ändringen ett bokstavligt procenttecken, ett accentord, ett typografiskt citattecken, ett plus och ett et-tecken. Varje värde ska överleva skapa länk → öppna länk → läs värde oförändrat. Felaktig indata ska ge ditt kontrollerade fel i stället för att stoppa resten av sidan. Kontrollerna verifierar formatkontraktet; de motiverar inte upprepad avkodning tills strängen ser läsbar ut.
Avvisa felaktig indata utan att krascha sidan
function decodeComponent(value) {
  try { return { ok: true, value: decodeURIComponent(value) }; }
  catch (error) {
    if (!(error instanceof URIError)) throw error;
    return { ok: false, error: "Invalid encoded component" };
  }
}
Den här gränsen rapporterar fel utan att tyst ändra en identifierare. Den kan inte identifiera en okänd källkodning. Avkoda bara så många gånger formatkontraktet kräver: ett procenttecken som finns kvar efter lyckad avkodning motiverar inte ett extra varv. Undvik föråldrade unescape() som UTF-8-lösning och håll token och privata frågevärden borta från offentliga diagnostikloggar.