Tolka kommatecken, citattecken och radbrytningar i CSV säkert
Ett kundmeddelande innehåller ett kommatecken och en radbrytning. Exporten ser läsbar ut, men nästa verktyg lägger till en rad eller förskjuter en kolumn. Filen kan vara giltig CSV: ett citerat fält får innehålla båda tecknen. Om du delar vid varje komma eller radbrytning förstörs den strukturen.
Börja med en liten kopia av den problematiska exporten
Om ett meddelande har hamnat på nästa rad bör du inte börja med att ta bort radbrytningen. Då kan en del av en kundadress eller supportförfrågan försvinna. Behåll originalexporten och kopiera rubriken samt två eller tre fullständiga poster till en separat testfil. Ta med en post med kommatecken, en med citattecken och en med radbrytning. Använd påhittade värden om filen ska delas.
Öppna kopian i en ren textredigerare, inte bara ett kalkylprogram. Leta upp öppningscitattecknet före problemfältet och följ det till avslutningscitattecknet. En radbrytning inom paret tillhör fältet. Två intilliggande citattecken inne i fältet representerar ett bokstavligt citattecken och avslutar inte nödvändigtvis fältet. Därför kan en fil se ut som fyra rader på skärmen utan att innehålla fyra poster.
Varför ett meddelande blir flera rader
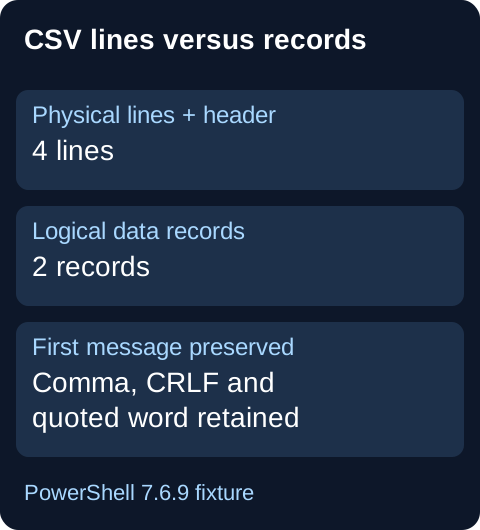
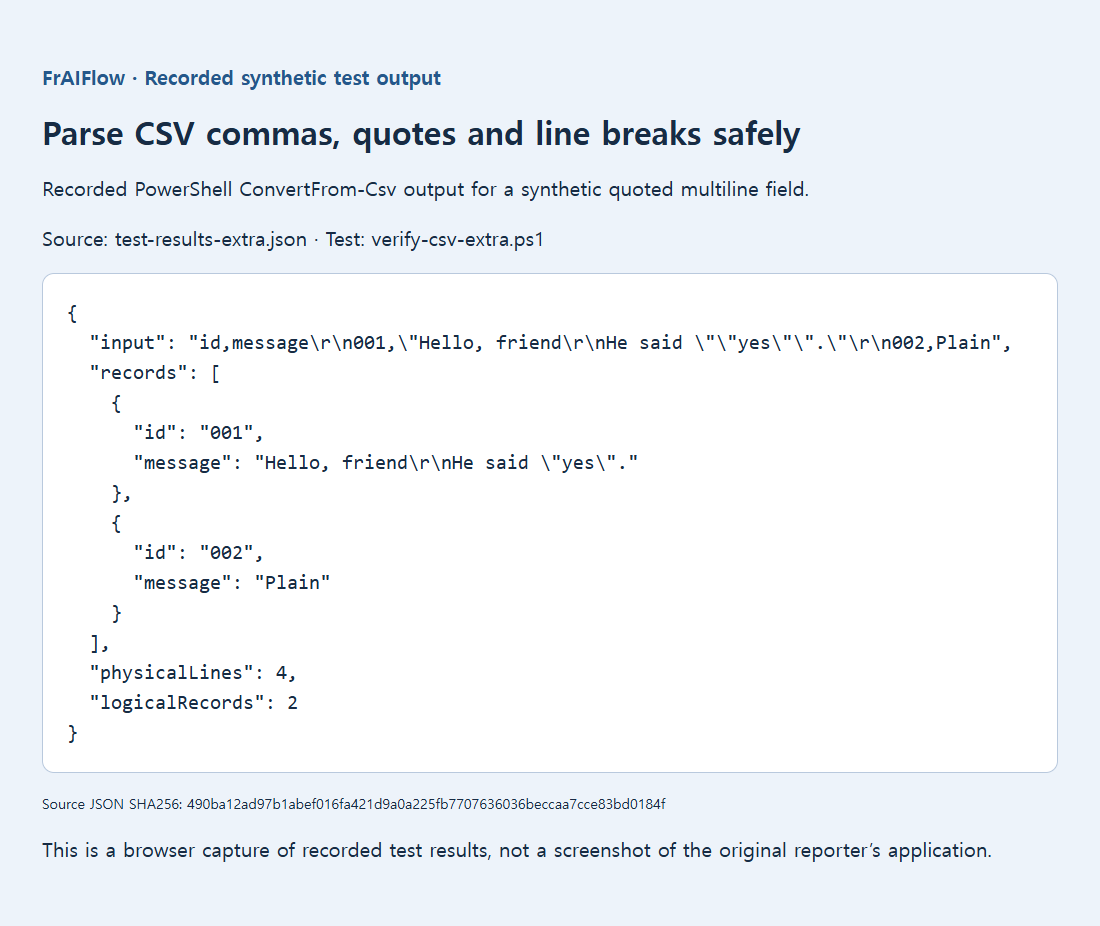
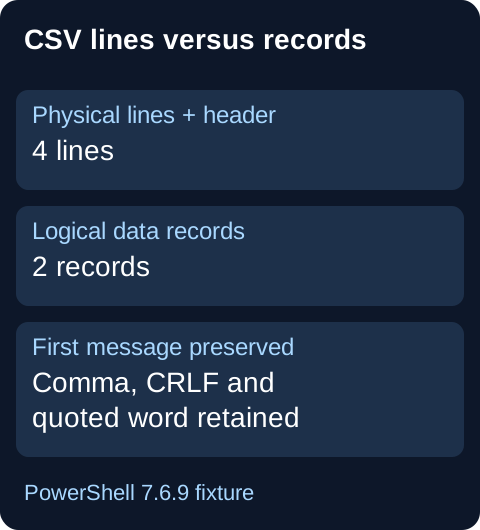
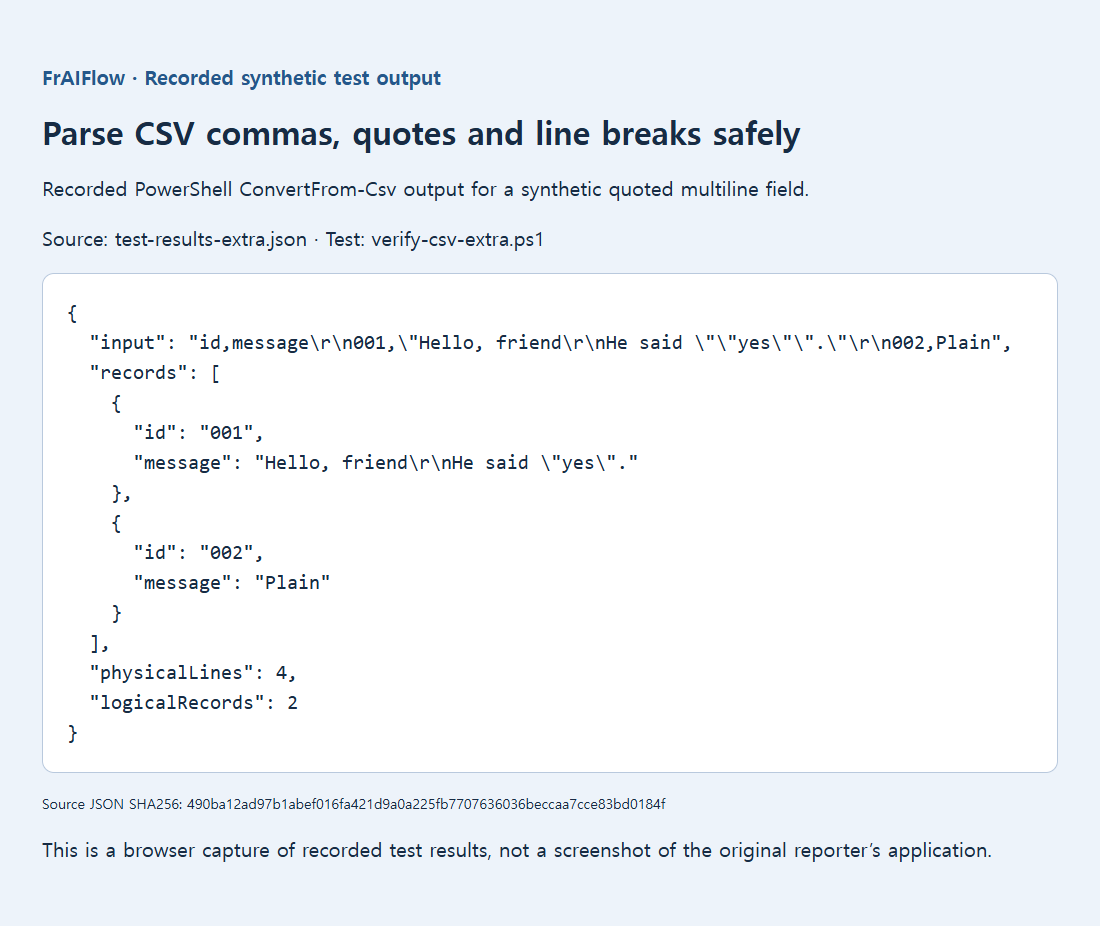
En offentlig rapport om ett skalkommando visade att cut inte tillförlitligt kunde extrahera en kolumn ur den här typen av fil. I det bevarade syntetiska testmaterialet tolkade PowerShell 7.6.9 två dataposter och bevarade det första meddelandet exakt, inklusive CRLF och det citerade ordet. Det är ett parserresultat, inte ett test av alla kalkylbladsimportörer.
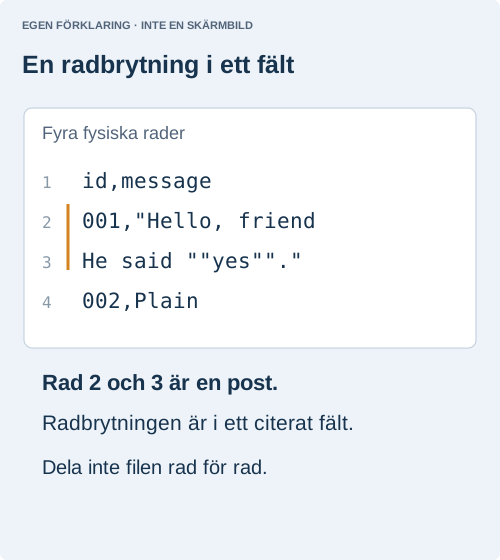
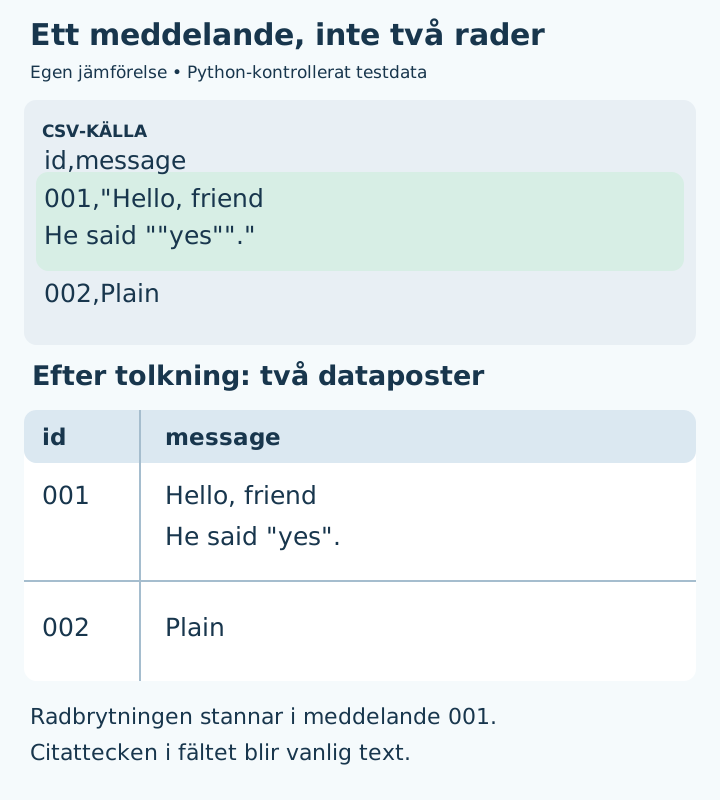
id,message
001,"Hello, friend
He said ""yes""."
002,Plain
Det finns fyra fysiska rader inklusive rubriken, men bara två dataposter. Dubblerade citattecken representerar bokstavliga citattecken i det citerade meddelandet. Ta inte bort alla citattecken för att få filen att se enklare ut.
Kör en parser och granska de faktiska värdena
Om Python redan är installerat sparar du följande som check_csv.py bredvid input.csv. Kör python check_csv.py från den mappen. Skriptet läser bara indata. Det skriver ut antalet fält i varje post och gör inbäddade radbrytningstecken synliga så att du kan se om parsern höll ihop meddelandet.
import csv

with open("input.csv", encoding="utf-8", newline="") as source:
    reader = csv.reader(source, delimiter=",", strict=True)
    for record_number, fields in enumerate(reader, start=1):
        print("Record", record_number, "fields:", len(fields))
        for column, value in enumerate(fields, start=1):
            print("  Column", column, repr(value))
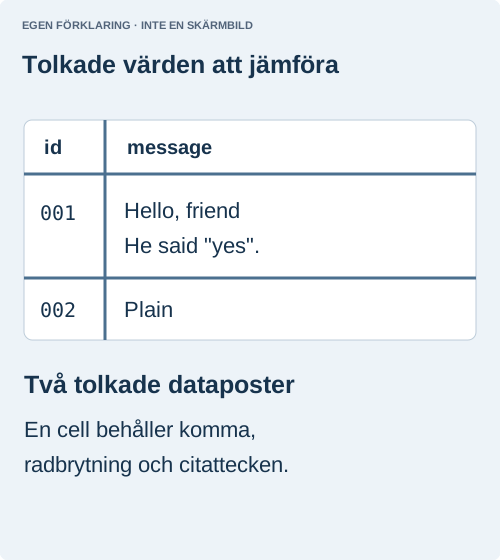
Den första posten är rubriken, så exemplet ovan ska ge tre poster totalt, med två fält i varje. Det första datameddelandet ska innehålla både Hello, friend och He said "yes". i ett enda fält. Skriptet är ett granskningsrecept, inte ett påstående om att det körts på din export. Ett avkodningsfel innebär att antagandet om UTF-8 behöver undersökas. Ett CSV-tolkningsfel pekar på filens citering eller dialekt. Ingetdera är skäl att automatiskt kasta bort oläsbara tecken.
Skriptet antar UTF-8. Det är varken en teckenkodningsdetektor eller ett nytt testresultat. Ge parsern hela filen i stället för att anropa den separat för varje textrad. För semikolonavgränsade data ställer du in avgränsaren så att den motsvarar exporten.
Kontrollera importen innan du ersätter originalet
Det avgränsar problemet till importvägen i stället för att bevisa att exporten är trasig. Använd kalkylprogrammets text-/CSV-import och granska förhandsvisningen före inläsning. Matcha avgränsaren med producentens inställning och låt identifierare förbli text om inledande nollor spelar roll. Exakta kontroller varierar med program och version. Importera samma lilla testfil först; experimentera inte med den enda kopian av ett arbetsblad i produktion.
En lyckad import håller meddelandet i en cell, bevarar dess citattecken och radbrytning och lämnar alla andra kolumner under rätt rubriker. Spara ett separat resultat och öppna det igen via det avsedda arbetsflödet. Ett prydligt rutnät räcker inte: jämför hela värdet i den svåra cellen. Om båda verktygen avvisar källan bör du fråga exportören om avgränsare, teckenkodning och citeringsregler innan du försöker reparera.
Om citeringen verkligen är felaktig behåller du källan och begär en ren export. Ett ensamt citattecken kan betyda flera saker, så en universell reparation är osäker. En historisk Excel 2007-rapport beskriver också skillnader mellan importvägar, men fastställer inte hur en aktuell Excel-installation beter sig. Testa en representativ fil genom exakt den importväg du tänker använda.
Källor och vidare läsning
- Ursprungligt förklarande diagram
- Citerade kommatecken och radbrytningar ställer till det för cut
- Inbäddat citattecken skapar ett extra fält
- Rapport om tolkning av felaktig CSV
- Historisk Excel 2007-rapport
- Pythons dokumentation om CSV-dialekter och radbrytningar
- Ursprungligt visuellt underlag
- Behåll inledande nollor och långa ID:n vid CSV-import
- Åtgärda en CSV som öppnas i en enda kolumn