Varför JSON som ser giltig ut misslyckas vid första tecknet
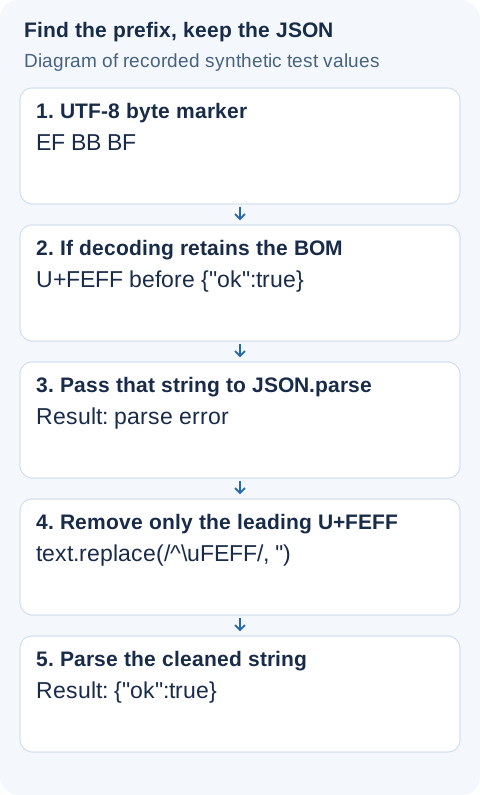
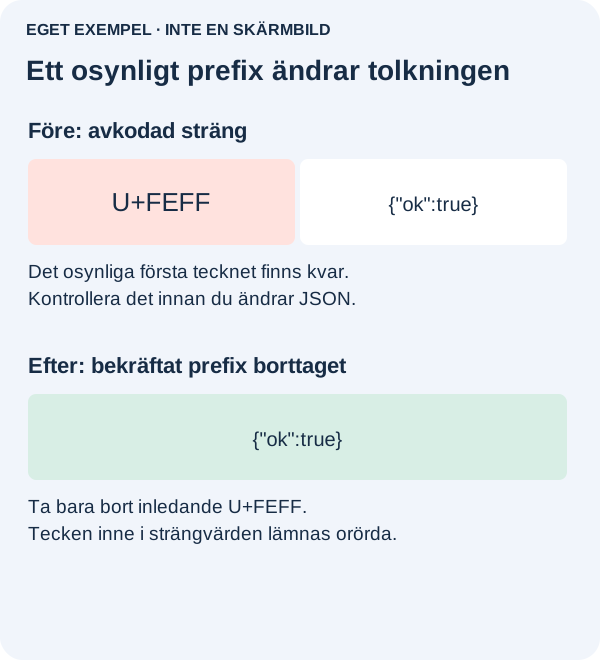
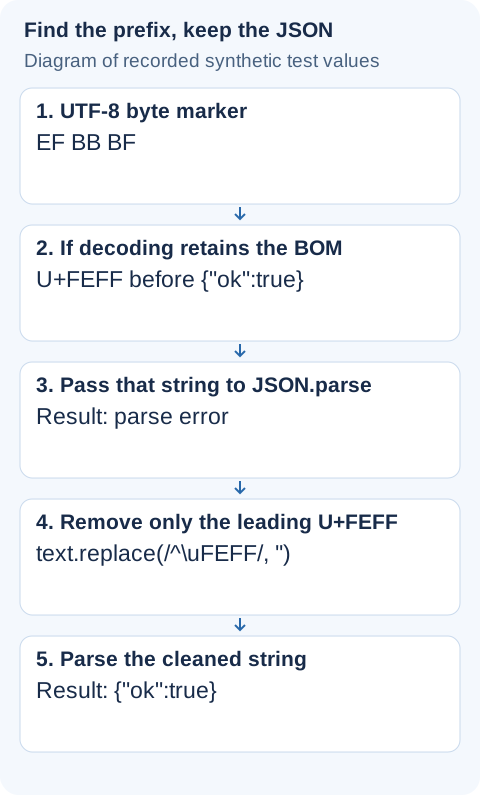
Du kan se ett giltigt JSON-objekt och ändå få ett fel vid position noll. Den inledande klammerparentesen kanske inte är första tecknet: ett osynligt U+FEFF kan stå före den. Behåll originalet innan du försöker reparera. En HTML-inloggningssida, ett tomt svar eller en felavkodad fil kräver en annan lösning.
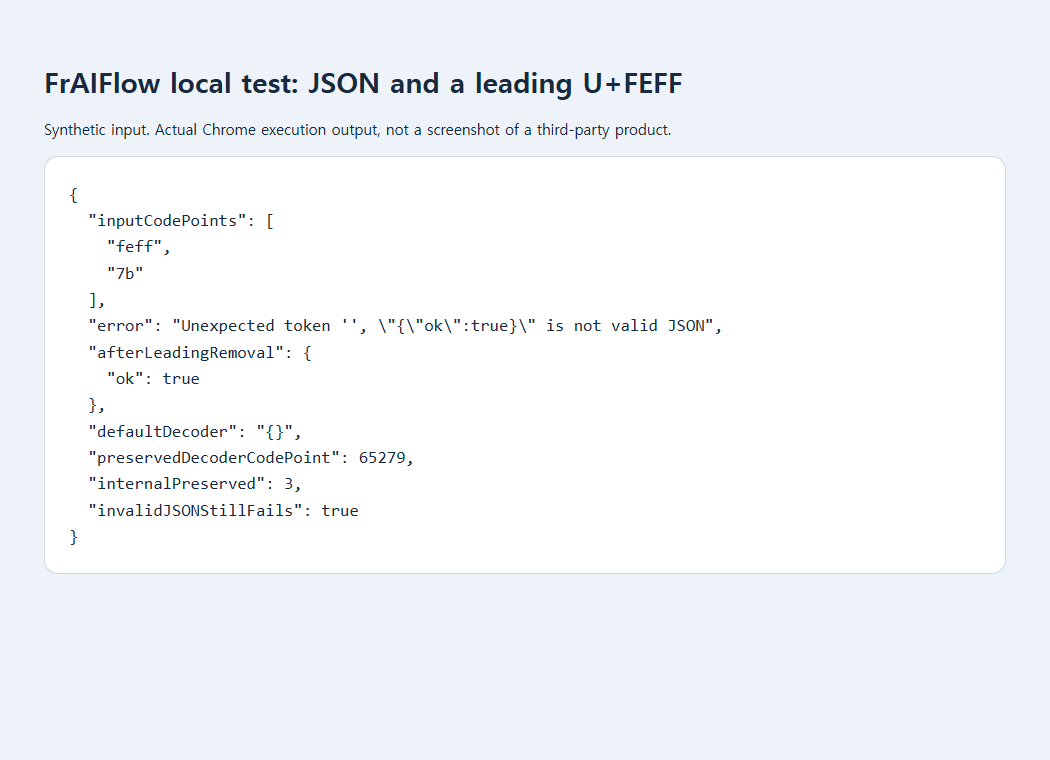
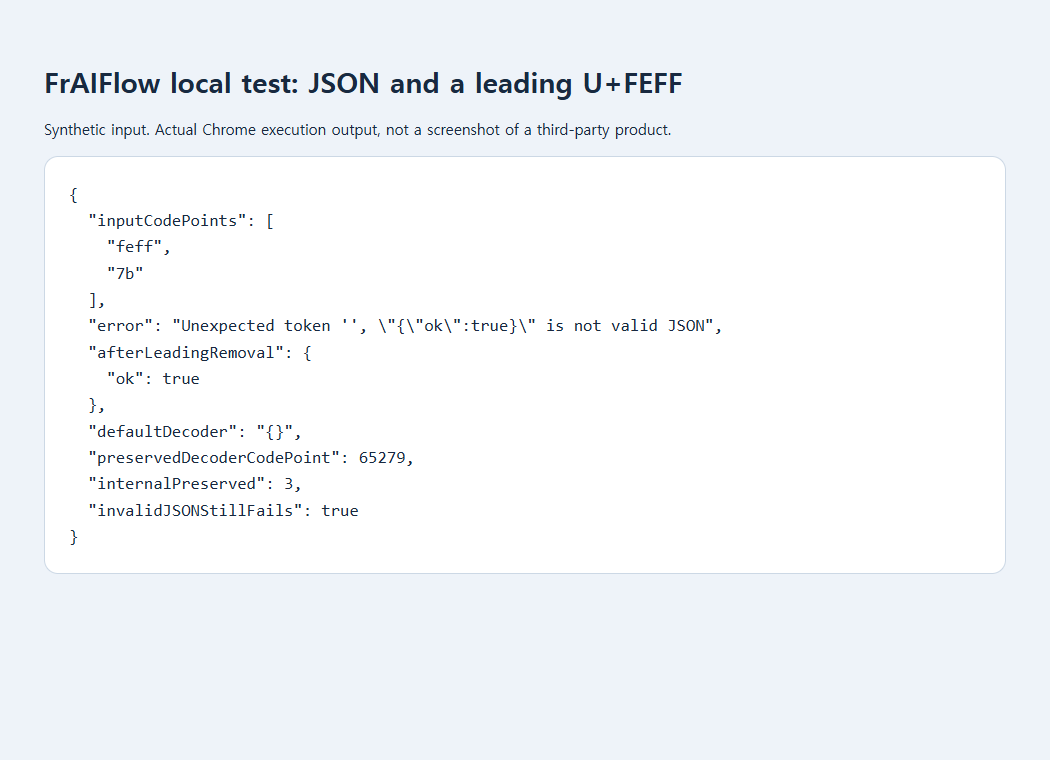
En Stack Overflow-rapport från 2017 spårade ett liknande Node.js-fel till decimalt 65279, alltså U+FEFF. Ett sparat lokalt webbläsartest är separat underlag: ett syntetiskt U+FEFF följt av {"ok":true} misslyckades men kunde tolkas när bara prefixet togs bort. Skärmbilden dokumenterar det lokala testet, inte rapportörens fil.
Ta bort en inledande BOM och kontrollera resultatet
Börja med en kopia av filen, inte din enda export. Om innehållet kommer från en webbförfrågan kontrollerar du först HTTP-status och innehållstyp: en inloggningssida som börjar med <!doctype html> kräver rättad autentisering, inte JSON-städning. För en lokal fil använder du en redigerare som kan visa teckenkodningen. Spara inte över originalet under undersökningen.
När du har avkodat filen till en JavaScript-sträng med namnet text använder du följande lilla hjälpfunktion i ditt eget importskript. Den accepterar en känd inledande markör och lämnar allt annat orört.
function parseJsonText(text) {
  if (typeof text !== "string") throw new TypeError("Expected text");
  const hadBOM = text.charCodeAt(0) === 0xFEFF;
  const cleaned = hadBOM ? text.slice(1) : text;
  return { value: JSON.parse(cleaned), removedLeadingBOM: hadBOM };
}
const sample = '\uFEFF{"ok":true,"name":"한글"}';
const result = parseJsonText(sample);
console.log(result.removedLeadingBOM); // true
console.log(result.value.ok);          // true
console.log(result.value.name);        // 한글
Framgångskontrollen är mer än att ”felet försvann”. Bekräfta att förväntade egenskaper finns och att icke-engelsk text fortfarande är korrekt. Kör hjälpfunktionen även på vanlig JSON: den ska kunna tolkas utan att en borttagen markör rapporteras. Tom indata eller ett felaktigt objekt ska fortfarande kasta fel. Låt anroparen se felet i stället för att returnera ett tomt objekt som kan misstas för giltiga data.
Om första kodpunkten inte är U+FEFF avbryter du denna reparationsväg. En fil som avkodats med fel kodning kan exempelvis innehålla ersättningstecken eller varannan nollbyte. Öppna den igen med exportörens valda kodning eller begär en ny UTF-8-export. Att ta bort tecken kan inte återskapa byte som avkodats fel.
Skillnaden mellan byte och ett dolt tecken
TextDecoder("utf-8") utelämnar normalt en inledande UTF-8-BOM. Alternativet ignoreBOM är kontraintuitivt: true tar med markören i den avkodade strängen. Vårt byteexempel EF BB BF 7B 7D blev {} med standardbeteendet. Detta är inte automatisk identifiering av teckenkodning.
Kontrollera producenten
En separat PowerShell-rapport gällde fel avkodningsväg. Windows PowerShell Out-File och omdirigering kan skapa UTF-16LE; nyare PowerShell beter sig annorlunda. Att ta bort icke-ASCII-text kan förstöra giltiga namn utan att rätta kodningsfelet. Kontrollera kommandot och versionen som skapade filen och avkoda eller exportera sedan korrekt. Användarens arbetsflöde återskapades inte i vårt test.
RFC 8259 kräver UTF-8 för JSON som utbyts utanför ett slutet ekosystem och förbjuder producenter att lägga till en nätverks-BOM. Rätta exportören om möjligt. Vid importgränsen testar du vanlig JSON, det bekräftade prefixet, felaktig JSON och icke-engelska värden. Logga bara det diagnostiska prefixet, inte privat dokumentinnehåll.
Källor, exempel och vidare läsning
- Offentlig diskussion: JSON.parse ger SyntaxError unexpected token vid position 0
- Ursprungligt kompletterande diagram
- Sparat lokalt testunderlag
- MDN-referens: ignoreBOM
- Offentlig diskussion: JSON.parse SyntaxError unexpected token vid position 0
- Microsofts dokumentation: about_character_encoding
- RFC 8259: formatet JSON för datautbyte
- Varför text som ser likadan ut inte matchar
- Varför Base64 inte fungerar med all text