Vì sao JSON trông hợp lệ lại lỗi ngay ký tự đầu?
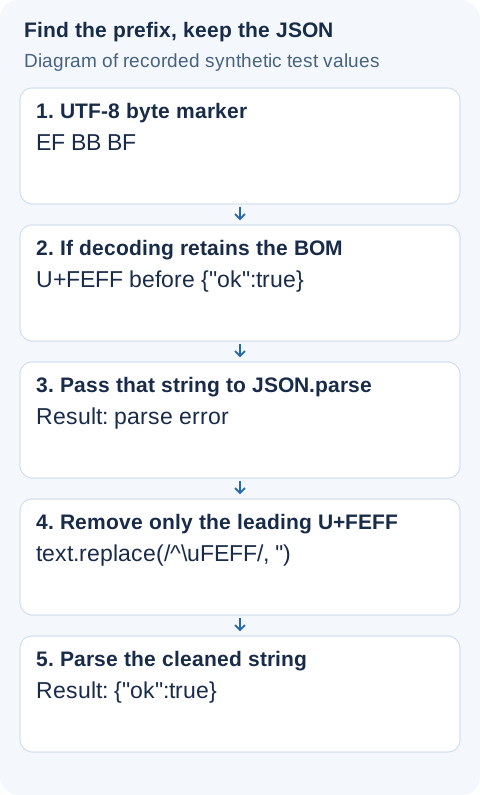
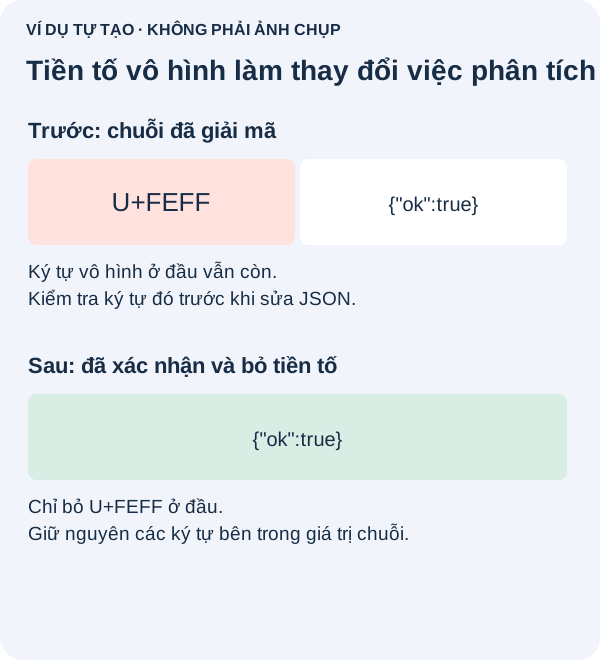
Bạn thấy đối tượng JSON hợp lệ nhưng vẫn gặp lỗi ở vị trí 0. Dấu ngoặc mở có thể không phải ký tự đầu: U+FEFF vô hình nằm trước nó. Giữ bản gốc trước khi sửa. Trang đăng nhập HTML, phản hồi rỗng hay tệp giải mã sai cần cách khắc phục khác.
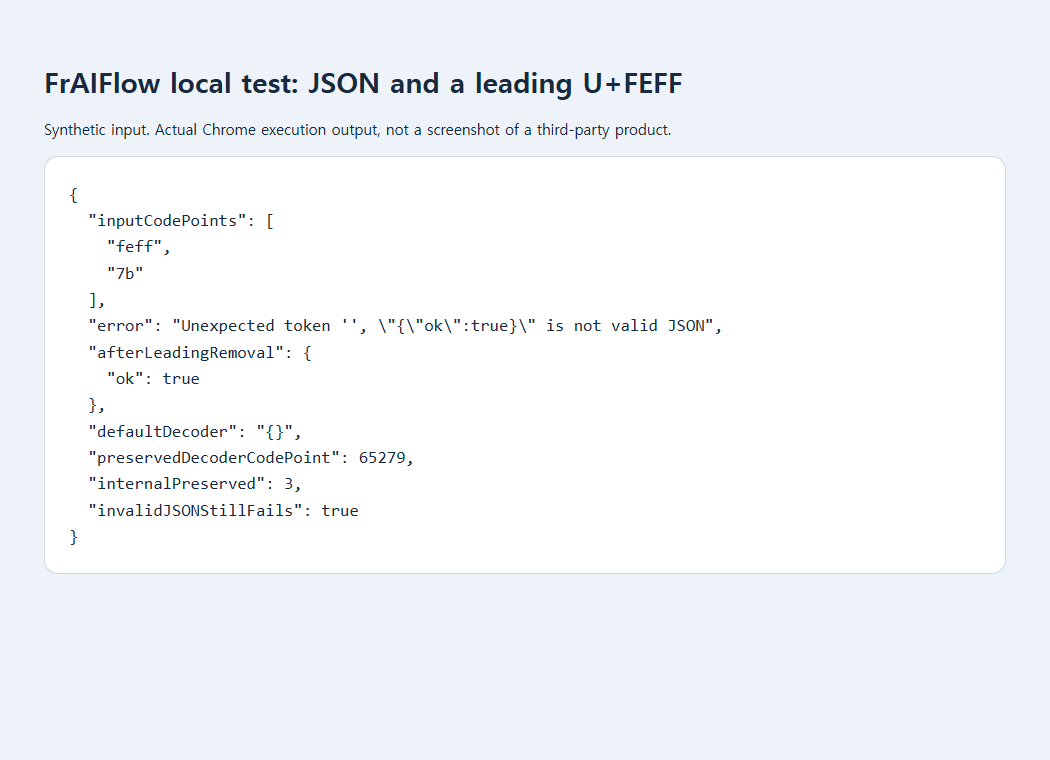
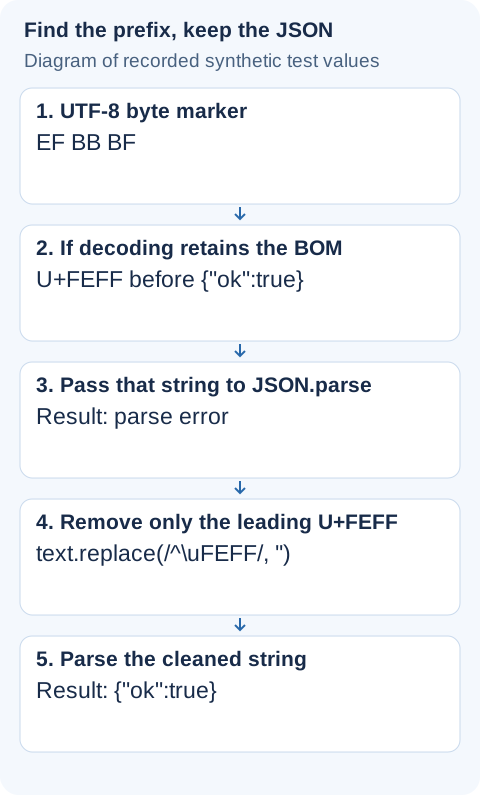
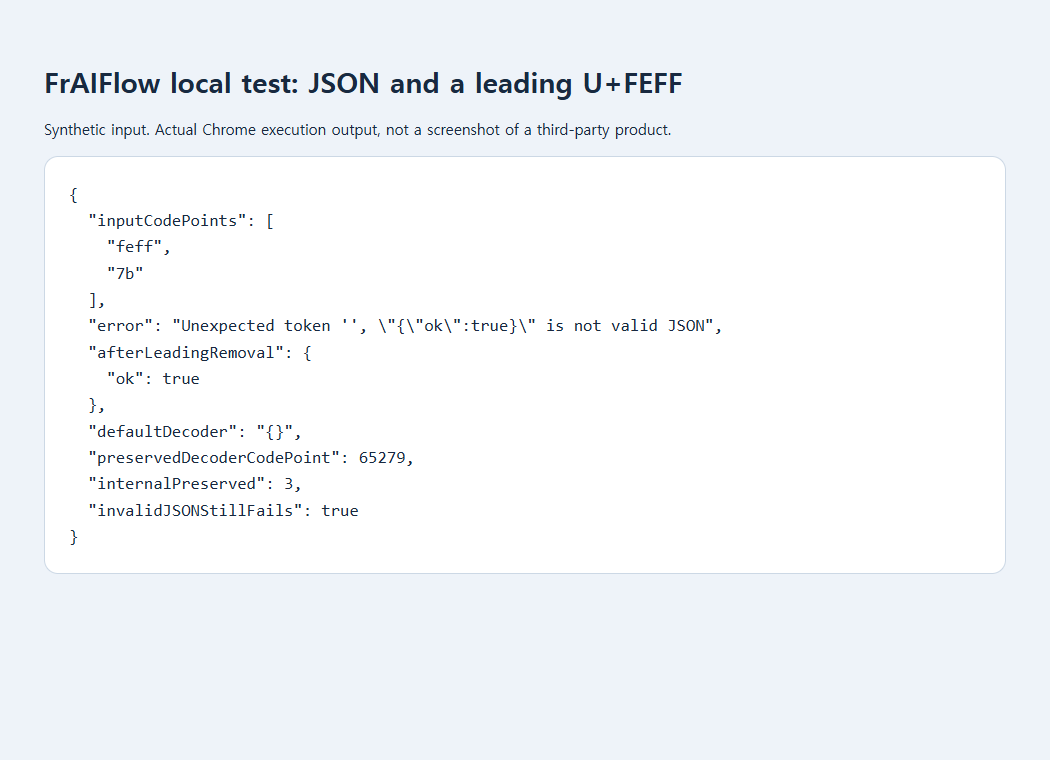
Báo cáo Stack Overflow năm 2017 truy lỗi Node.js tương tự tới giá trị thập phân 65279, tức U+FEFF. Thử nghiệm trình duyệt cục bộ đã lưu là bằng chứng riêng: U+FEFF tổng hợp theo sau bởi {"ok":true} gây lỗi, rồi phân tích được khi chỉ bỏ tiền tố. Ảnh chụp ghi thử nghiệm cục bộ, không phải tệp người báo lỗi.
Cách sửa an toàn có thể thực hiện
Bắt đầu với bản sao, không phải bản xuất duy nhất. Nếu từ yêu cầu web, kiểm tra trạng thái HTTP và loại nội dung trước: trang đăng nhập bắt đầu bằng <!doctype html> cần sửa xác thực, không phải dọn JSON. Với tệp cục bộ, dùng trình soạn thảo hiển thị bảng mã. Đừng lưu đè bản gốc trong lúc điều tra.
Sau khi giải mã tệp thành chuỗi JavaScript tên text, dùng hàm nhỏ dưới đây trong script nhập của bạn. Nó chấp nhận một dấu đầu đã biết và giữ nguyên mọi thứ khác.
function parseJsonText(text) {
  if (typeof text !== "string") throw new TypeError("Expected text");
  const hadBOM = text.charCodeAt(0) === 0xFEFF;
  const cleaned = hadBOM ? text.slice(1) : text;
  return { value: JSON.parse(cleaned), removedLeadingBOM: hadBOM };
}
const sample = '\uFEFF{"ok":true,"name":"한글"}';
const result = parseJsonText(sample);
console.log(result.removedLeadingBOM); // true
console.log(result.value.ok);          // true
console.log(result.value.name);        // 한글
Xác nhận thành công không chỉ là “hết lỗi”. Kiểm tra thuộc tính mong đợi tồn tại và văn bản không phải tiếng Anh vẫn đọc đúng. Chạy hàm với JSON thường nữa: phải phân tích mà không báo đã xóa dấu. Đầu vào rỗng hoặc đối tượng sai cấu trúc vẫn phải ném lỗi. Giữ lỗi cho bên gọi thấy thay vì trả đối tượng rỗng dễ bị nhầm là dữ liệu hợp lệ.
Nếu điểm mã đầu không phải U+FEFF, dừng cách sửa này. Chẳng hạn, tệp giải mã sai có thể chứa ký tự thay thế hoặc byte null xen kẽ. Mở lại bằng bảng mã bên xuất chọn, hoặc xin bản xuất UTF-8 mới. Xóa ký tự không tái tạo được byte đã giải mã sai.
Khác biệt giữa byte và ký tự ẩn
TextDecoder("utf-8") thường bỏ BOM UTF-8 ở đầu. Tùy chọn ignoreBOM hơi trái trực giác: true đưa dấu đó vào chuỗi giải mã. Mẫu byte EF BB BF 7B 7D của chúng tôi thành {} theo mặc định. Đây không phải tự động phát hiện bảng mã.
Sửa từ nơi tạo ra dữ liệu JSON
Báo cáo PowerShell riêng liên quan đến cách giải mã sai. Out-File và chuyển hướng của Windows PowerShell có thể tạo UTF-16LE; PowerShell mới hơn có hành vi khác. Xóa văn bản ngoài ASCII có thể phá tên hợp lệ mà không sửa bất tương thích. Kiểm tra lệnh và phiên bản tạo dữ liệu, rồi giải mã hoặc xuất lại đúng. Quy trình của người dùng đó không được tái hiện trong thử nghiệm này.
RFC 8259 yêu cầu UTF-8 cho JSON trao đổi ngoài hệ sinh thái khép kín và cấm bên tạo thêm BOM khi truyền mạng. Sửa bộ xuất nếu có thể. Ở ranh giới nhập, thử JSON thường, tiền tố đã xác nhận, JSON sai và giá trị không phải tiếng Anh. Chỉ ghi tiền tố chẩn đoán, không ghi nội dung tài liệu riêng tư.
Nguồn, ví dụ và bài đọc thêm
- Thảo luận công khai: JSON.parse báo SyntaxError unexpected token tại vị trí 0
- Sơ đồ bổ trợ gốc
- Bằng chứng thử nghiệm cục bộ đã lưu
- Tài liệu MDN: ignoreBOM
- Thảo luận công khai: JSON.parse SyntaxError unexpected token tại vị trí 0
- Tài liệu Microsoft: about_character_encoding
- RFC 8259: định dạng trao đổi dữ liệu JSON
- Vì sao văn bản trông giống nhau lại không khớp?
- Vì sao Base64 làm hỏng văn bản không phải tiếng Anh?