Hvorfor JSON som ser gyldig ut, feiler på første tegn
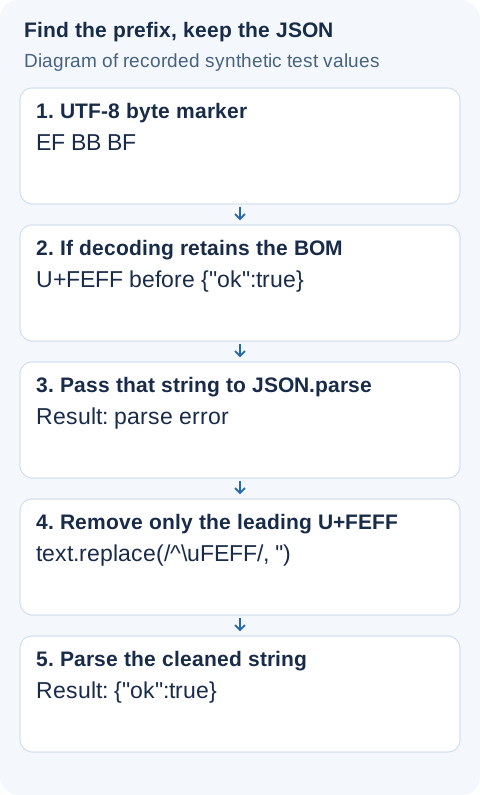
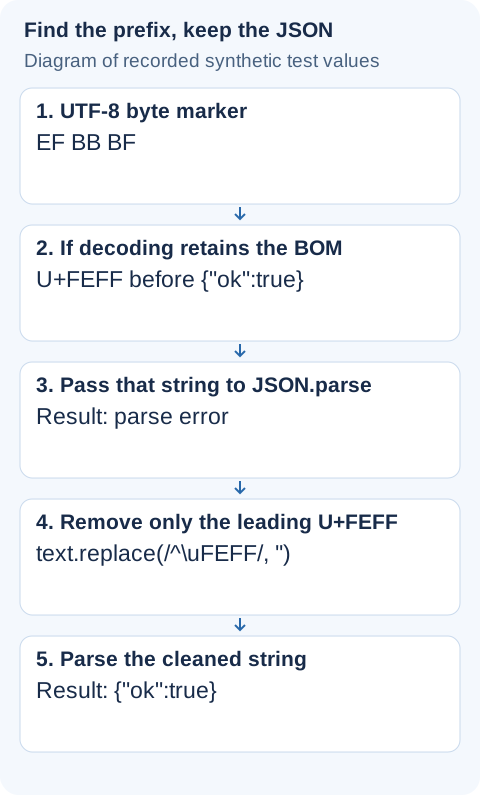
Du ser et gyldig JSON-objekt, men får likevel en feil ved posisjon null. Den åpne krøllparentesen er kanskje ikke første tegn: Et usynlig U+FEFF kan stå foran den. Behold originalen før du forsøker reparasjon. En HTML-innloggingsside, en tom respons eller en feil dekodet fil trenger en annen løsning.
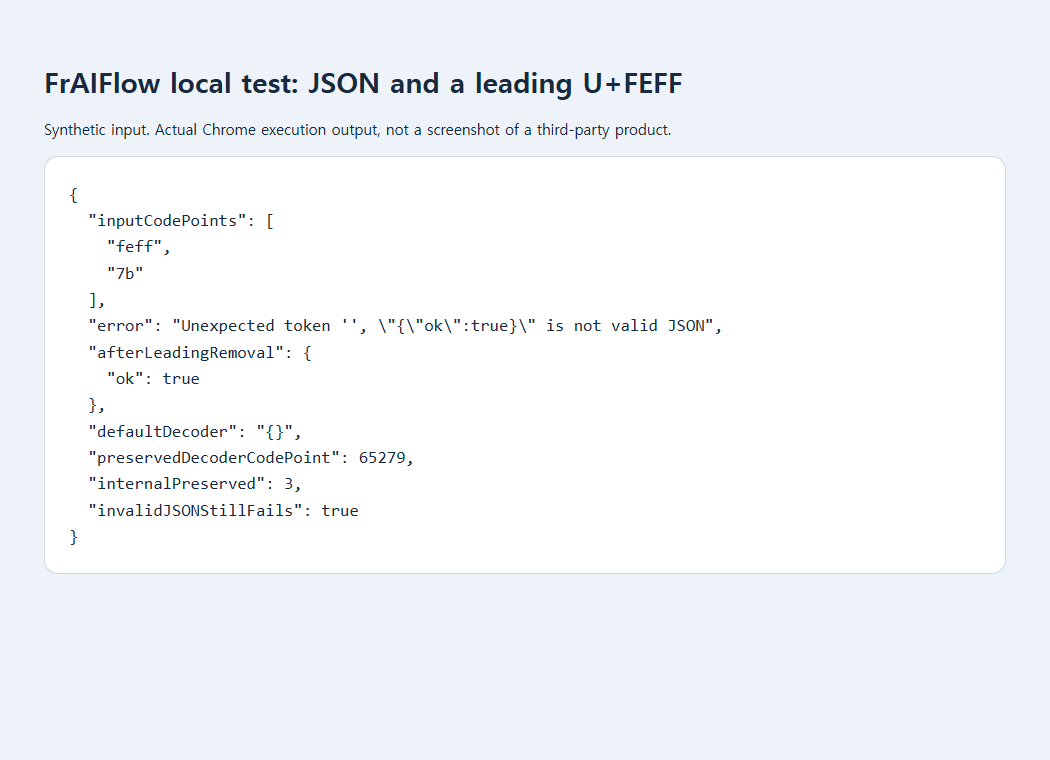
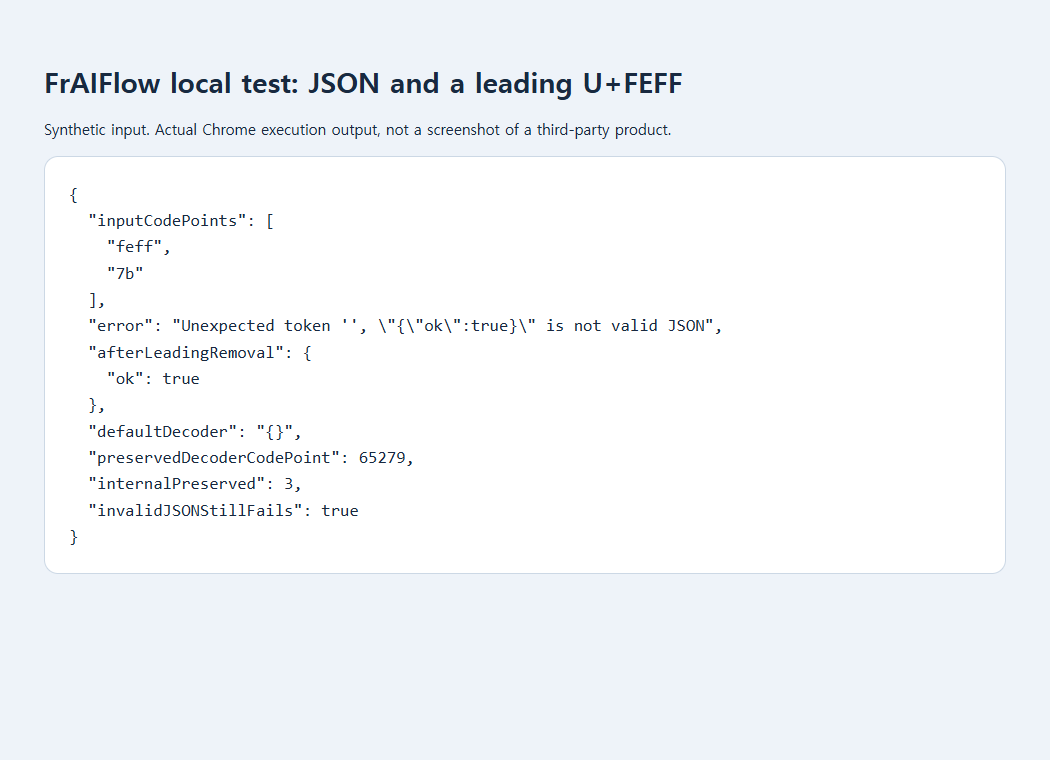
En Stack Overflow-rapport fra 2017 sporet en lignende Node.js-feil til desimalverdien 65279, altså U+FEFF. En lagret lokal nettlesertest er separat dokumentasjon: Et syntetisk U+FEFF etterfulgt av {"ok":true} feilet, men ble tolket etter at bare prefikset ble fjernet. Skjermbildet dokumenterer den lokale testen, ikke rapportørens fil.
Fjern bare en innledende BOM og kontroller resultatet
Start med en kopi av filen, ikke din eneste eksport. Kom den fra en nettforespørsel, kontrollerer du HTTP-status og innholdstype først. En innloggingsside som begynner med <!doctype html> trenger en autentiseringsrettelse, ikke JSON-opprydding. For en lokal fil bruker du et redigeringsprogram som kan vise tegnkodingen. Ikke lagre over originalen under undersøkelsen.
Når filen er dekodet til en JavaScript-streng kalt text, bruker du den lille hjelpefunksjonen nedenfor i ditt eget importskript. Den godtar én kjent innledende markør og lar alt annet være urørt.
function parseJsonText(text) {
  if (typeof text !== "string") throw new TypeError("Expected text");
  const hadBOM = text.charCodeAt(0) === 0xFEFF;
  const cleaned = hadBOM ? text.slice(1) : text;
  return { value: JSON.parse(cleaned), removedLeadingBOM: hadBOM };
}
const sample = '\uFEFF{"ok":true,"name":"한글"}';
const result = parseJsonText(sample);
console.log(result.removedLeadingBOM); // true
console.log(result.value.ok);          // true
console.log(result.value.name);        // 한글
Suksesskontrollen er mer enn «feilen forsvant». Bekreft at forventede egenskaper finnes og at ikke-engelsk tekst fortsatt er lesbar. Kjør også hjelpefunksjonen på vanlig JSON. Den skal tolkes uten at en fjernet markør rapporteres. Tomme inndata eller et ugyldig objekt skal fortsatt kaste en feil. La feilen være synlig for den som kaller funksjonen, i stedet for å returnere et tomt objekt som kan forveksles med gyldige data.
Hvis første kodepunkt ikke er U+FEFF, stopper du denne reparasjonsmetoden. En fil dekodet med feil tegnkoding kan for eksempel inneholde erstatningstegn eller vekslende nulltegn. Åpne den igjen med tegnkodingen eksportøren valgte, eller be om en ny UTF-8-eksport. Fjerning av tegn kan ikke rekonstruere byte som ble dekodet feil.
Forskjellen på byte og et skjult tegn
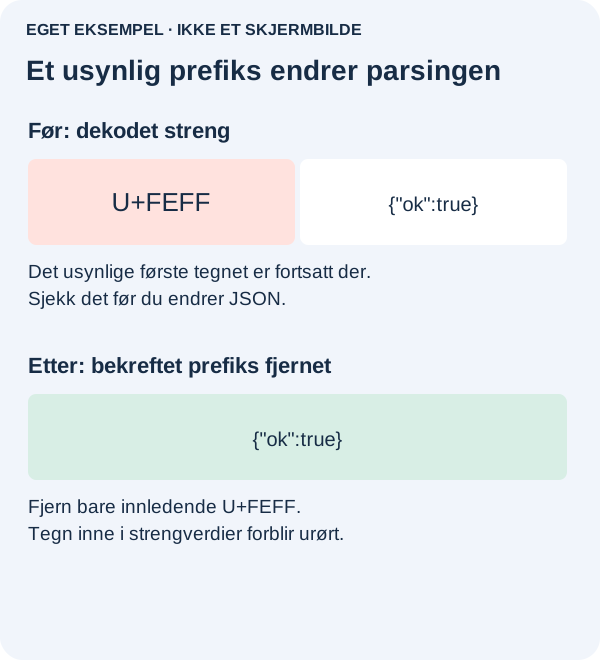
TextDecoder("utf-8") utelater normalt en innledende UTF-8-BOM. Valget ignoreBOM er lite intuitivt: true tar markøren med i den dekodede strengen. Vårt byteeksempel EF BB BF 7B 7D ble {} med standardoppførselen. Dette er ikke automatisk deteksjon av tegnkoding.
Undersøk produsenten
En separat PowerShell-rapport gjaldt feil dekodingsmåte. Windows PowerShell Out-File og omdirigering kan produsere UTF-16LE. Nyere PowerShell har annen oppførsel. Fjerning av ikke-ASCII-tekst kan ødelegge gyldige navn uten å rette dette avviket. Kontroller kommandoen og versjonen som produserte filen, og dekod eller eksporter på nytt riktig. Brukerens arbeidsflyt ble ikke gjenskapt i vår test.
RFC 8259 krever UTF-8 for JSON som utveksles utenfor et lukket økosystem, og forbyr produsenter å legge til en BOM ved nettverksutveksling. Rett eksportøren hvis mulig. Ved import tester du vanlig JSON, det bekreftede prefikset, ugyldig JSON og ikke-engelske verdier. Logg bare det diagnostiske prefikset, ikke privat dokumentinnhold.
Kilder, eksempler og videre lesning
- Offentlig diskusjon: JSON.parse gir SyntaxError for uventet token ved posisjon 0
- Opprinnelig støttediagram
- Lagret dokumentasjon fra lokal test
- MDN-referanse: ignoreBOM
- Offentlig diskusjon: JSON.parse SyntaxError for uventet token ved posisjon 0
- Microsoft-dokumentasjon: about_character_encoding
- RFC 8259: JSON-formatet for datautveksling
- Hvorfor tekst som ser lik ut, ikke samsvarer
- Hvorfor Base64 skaper problemer for tekst som ikke er engelsk