Hvorfor tekst som ser lik ut, ikke samsvarer
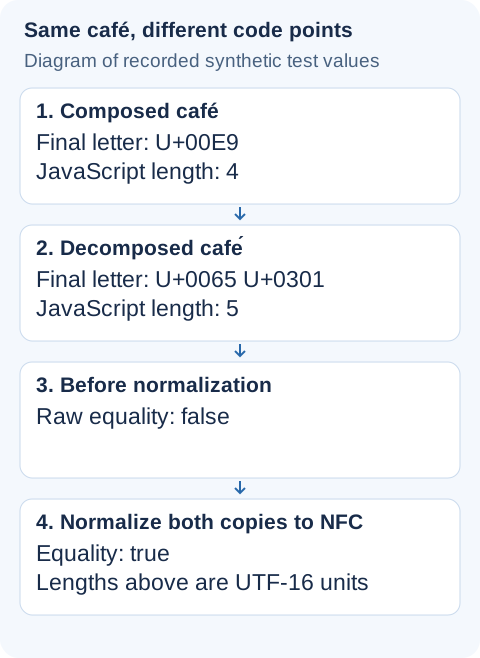
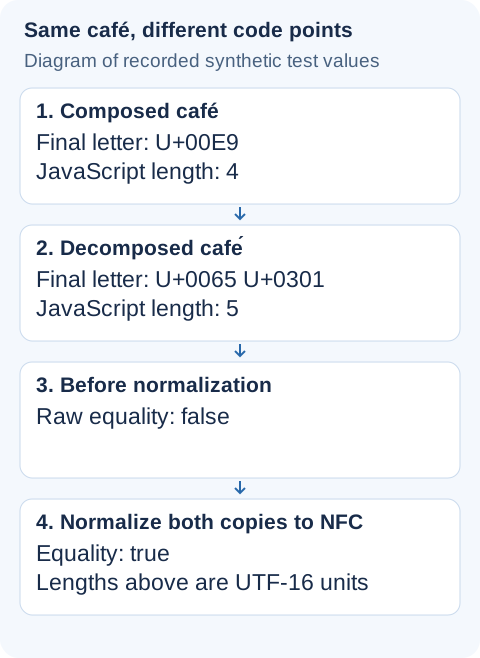
To kopier av café kan se identiske ut og likevel være ulike ved sammenligning. Den ene kan slutte med U+00E9, den andre med U+0065 etterfulgt av kombinerende U+0301. Aksenten er ikke feil. De lagrede Unicode-sekvensene er forskjellige, og sammenligningsregelen må ta hensyn til det.
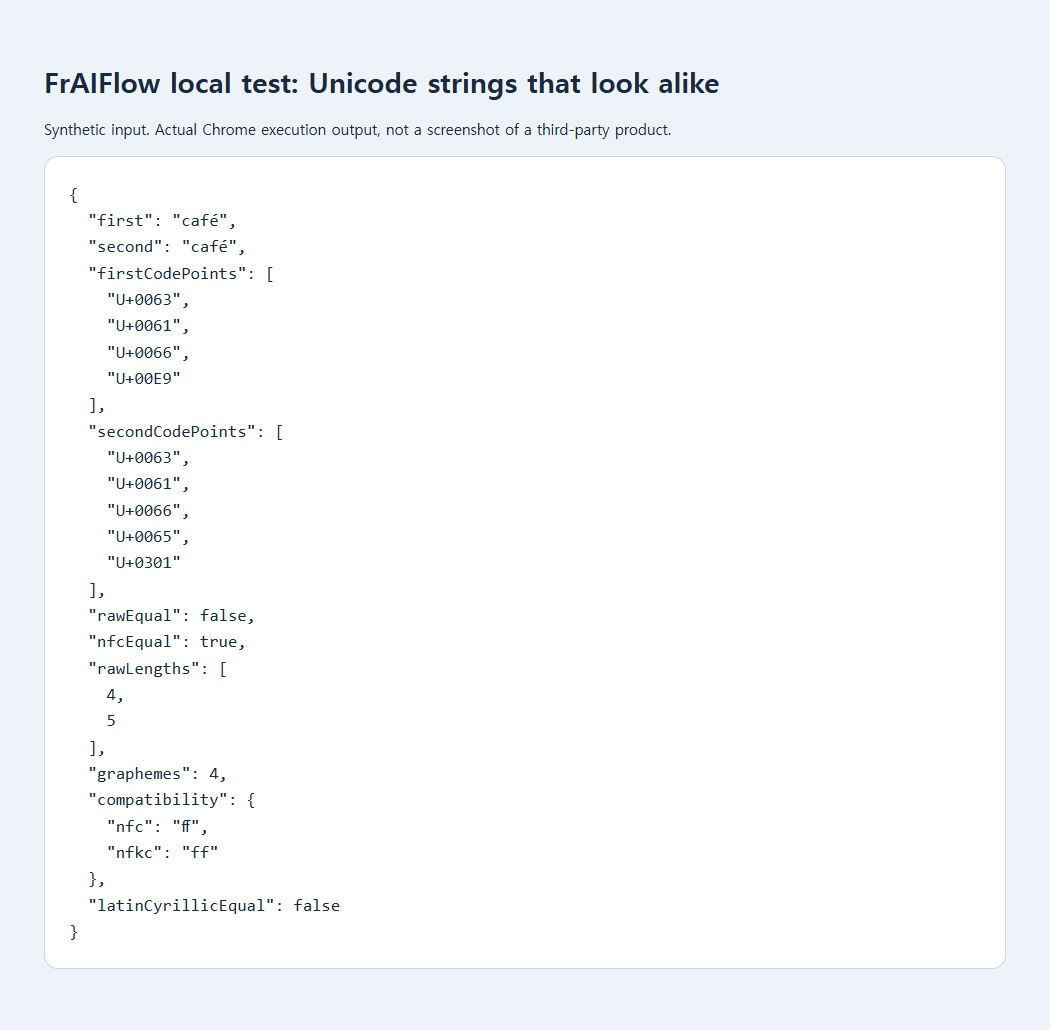
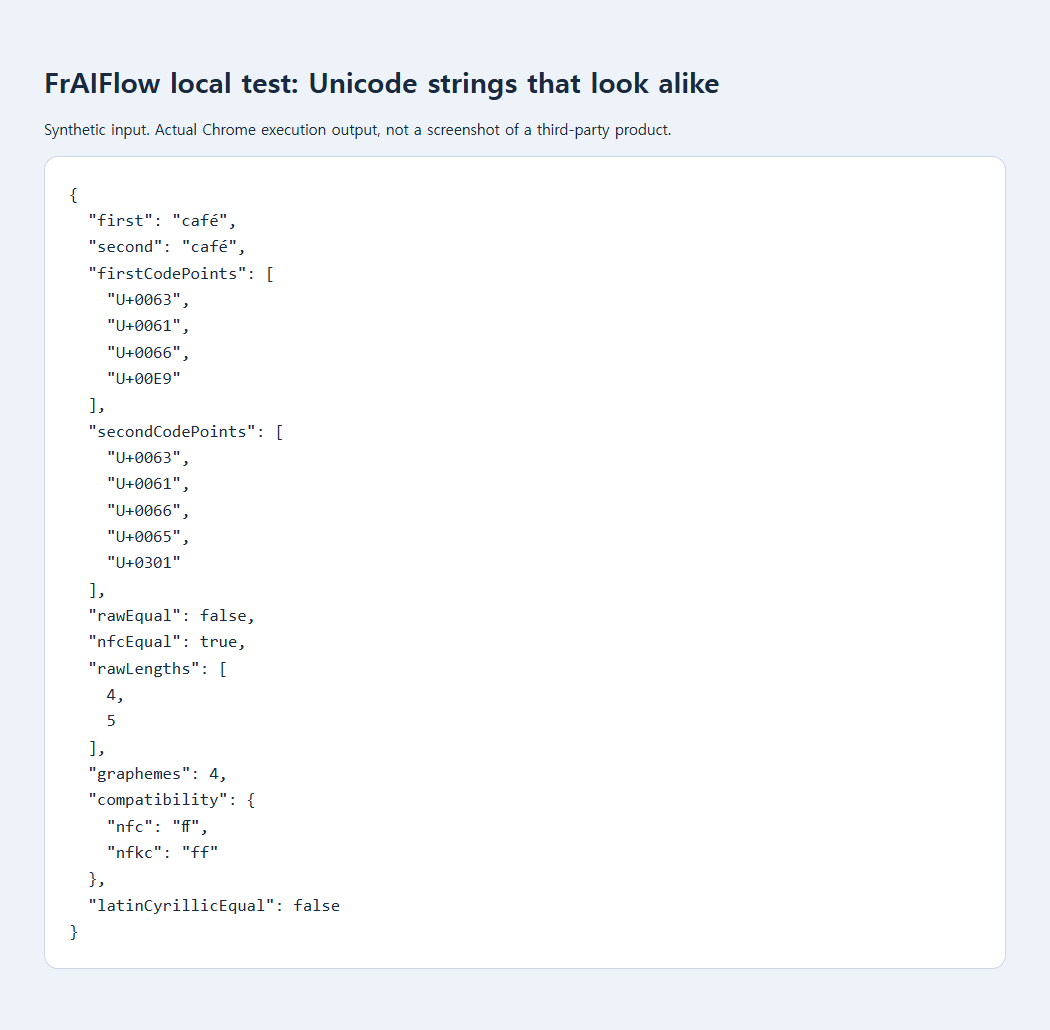
Et Stack Overflow-spørsmål fra 2019 beskrev vietnamesisk tekst som så lik ut, men ikke besto likhetskontroller. Svaret brukte en felles normaliseringsform. Vår lagrede nettlesertest bruker et annet, syntetisk café-par: Direkte likhet var false, mens sammenligning av begge NFC-formene ga true. Dette er ikke en gjenskaping av rapportørens program.
Undersøk først ett par som ikke samsvarer
Før du endrer et helt regneark eller en database, kopierer du bare de to verdiene som burde samsvare, til et lite lokalt skript. Bruk harmløs eksempeltekst hvis de virkelige verdiene identifiserer kunder. Å se kodepunktene ved siden av hverandre er langt nyttigere enn å skrive inn en aksent om og om igjen.
const typed = "caf\u00E9";
const pasted = "cafe\u0301";
const points = s => Array.from(s, c =>
  "U+" + c.codePointAt(0).toString(16).toUpperCase().padStart(4, "0")
).join(" ");
console.log(points(typed));  // U+0063 U+0061 U+0066 U+00E9
console.log(points(pasted)); // U+0063 U+0061 U+0066 U+0065 U+0301
console.log(typed === pasted); // false
const matches = typed.normalize("NFC") === pasted.normalize("NFC");
console.log(matches); // true
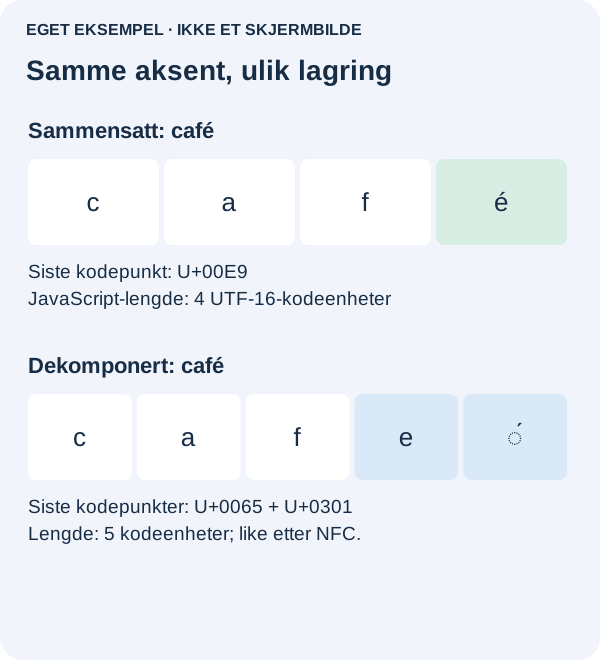
Les de to sekvensene fra venstre mot høyre. Her er de første tre bokstavene like; bare representasjonen av siste bokstav med aksent er forskjellig. Det er dette NFC er laget for å håndtere. Illustrasjonen nedenfor synliggjør de to lagringsformene. Det ekstra merket er en kombinerende aksent, ikke en uønsket ekstra bokstav.
For søk eller importsammenligning lager du en separat normalisert nøkkel og beholder originalverdien til visning. Normaliser begge sider av sammenligningen, også verdier som allerede ligger i databasen. Normalisering av bare nye inndata gjør gamle poster inkonsistente. Før regelen brukes på alle poster, kontrollerer du noen par som skal samsvare og noen som må forbli forskjellige.
Er resultatet fortsatt false, ser du etter et avsluttende mellomrom, et hardt mellomrom eller et annet alfabet. Ikke svar med å fjerne alle aksenter eller tegnsetting. Det er ekstra sammenligningsregler som kan slå sammen forskjellige navn. Berører en foreslått duplikatgruppe kontoer, betalinger eller identitet, bør den vises for gjennomgang i stedet for å behandle visuell likhet som bevis.
Ikke endre identifikatorer bare for å sammenligne tekst
Samsvar under NFC beviser ikke at to kontoer tilhører samme person. Forhåndsvis foreslåtte duplikatgrupper og avgjør hva samsvar betyr for dataene. Ikke legg normalisering til passord, signaturer eller ugjennomsiktige token som tilfeldig opprydding. Slike systemer kan kreve nøyaktige byte- eller tegnavtaler.
Hvorfor ikke bruke NFKC overalt?
NFKC legger til kompatibilitetsmappinger. I den registrerte testen var ligaturen U+FB00 uendret under NFC, men ble ff under NFKC. Det kan hjelpe en bevisst romslig søkenøkkel, men fjerne et skille som må bevares i originalteksten. Velg regelen før du velger omformingen.
Normalisering løser heller ikke problemet med tegn som ligner hverandre: Latinsk a og kyrillisk U+0430 forble ulike i eksemplet. Den definerer heller ikke et nettsteds tegngrense. De to café-formene målte 4 og 5 JavaScript UTF-16-kodeenheter. Grafemsegmentering av det dekomponerte ordet ga 4 leserrettede grupper. Dette er forskjellige mål.
Kilder, eksempler og videre lesning
- Offentlig diskusjon: Samme tekst var ikke lik; hvordan få samme koding
- Opprinnelig støttediagram
- Lagret dokumentasjon fra lokal test
- MDN-referanse: normalize
- Unicode-spesifikasjonen for normalisering
- MDN-referanse: length
- Offentlig diskusjon: Telle riktig lengde på en streng med emoji i JavaScript
- Hvorfor JSON som ser gyldig ut, feiler på første tegn
- Hvorfor Base64 skaper problemer for tekst som ikke er engelsk