Varför text som ser likadan ut inte matchar
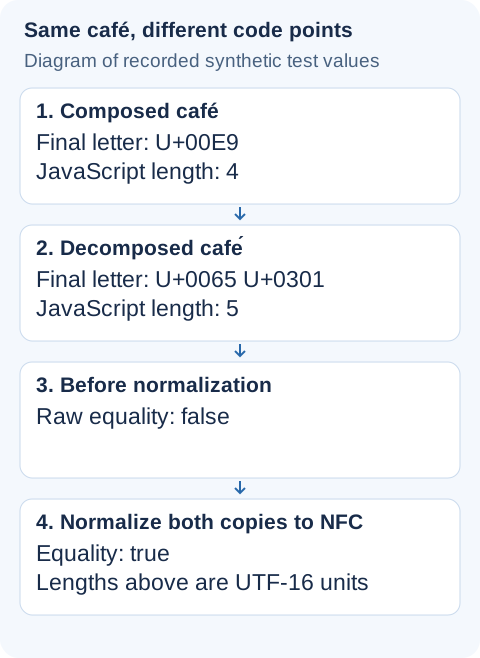
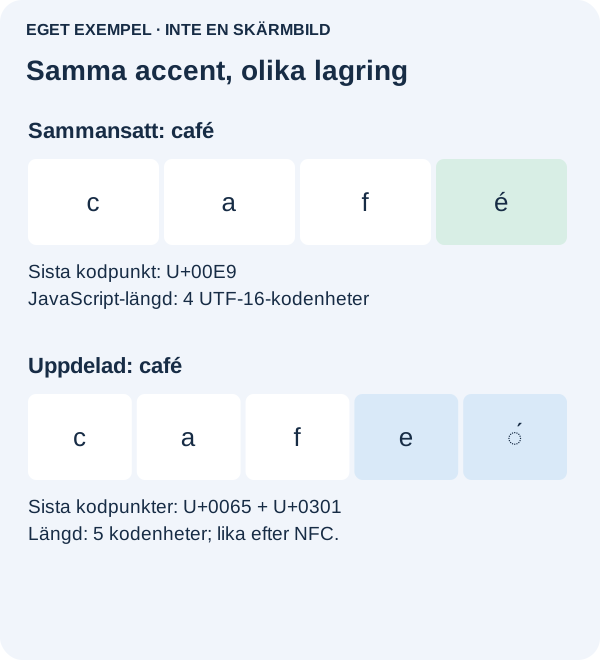
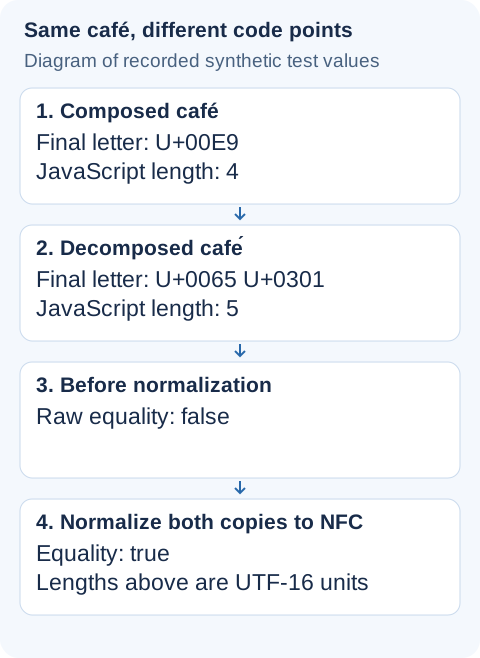
Två kopior av café kan se identiska ut men ändå jämföras som olika. Den ena kan sluta med U+00E9, den andra med U+0065 följt av kombinerande U+0301. Accenten är inte fel. De lagrade Unicode-sekvenserna skiljer sig, och jämförelseregeln behöver ta hänsyn till skillnaden.
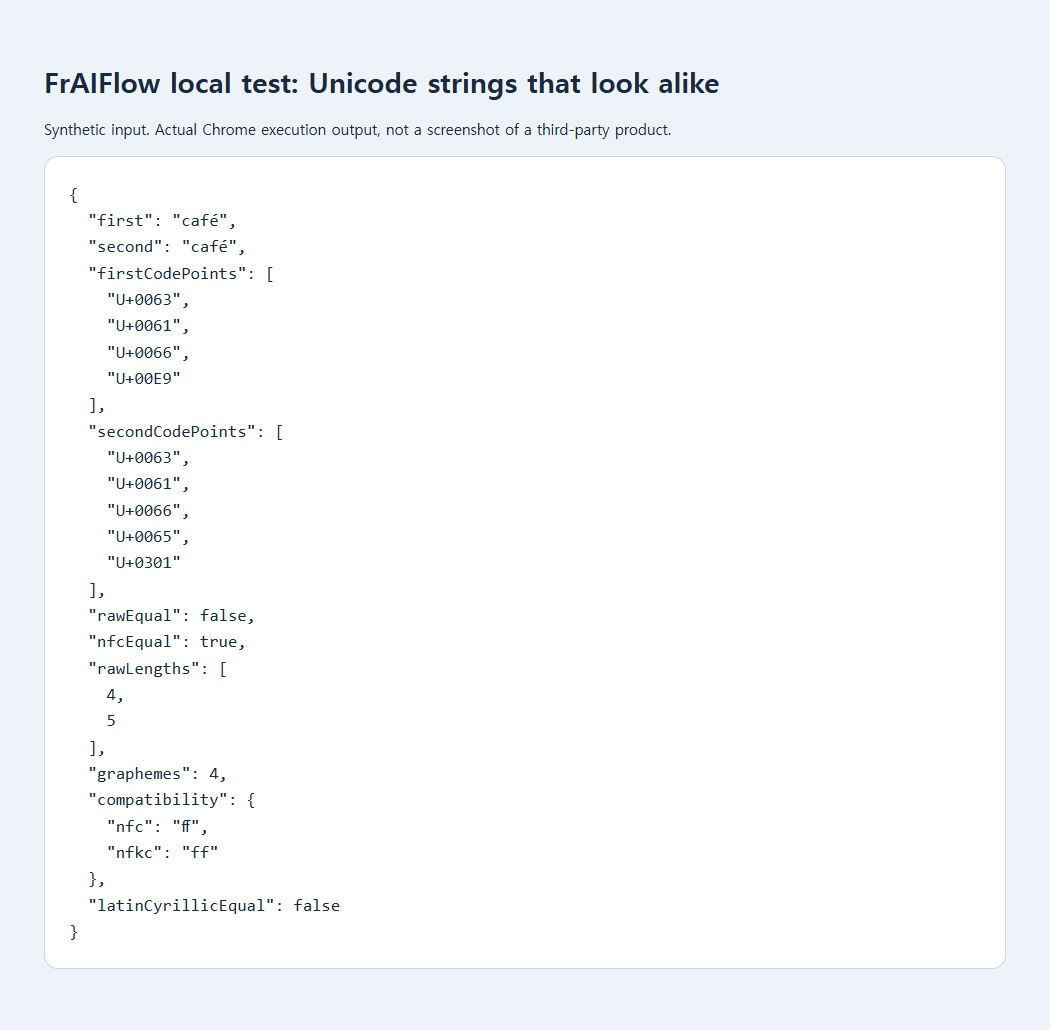
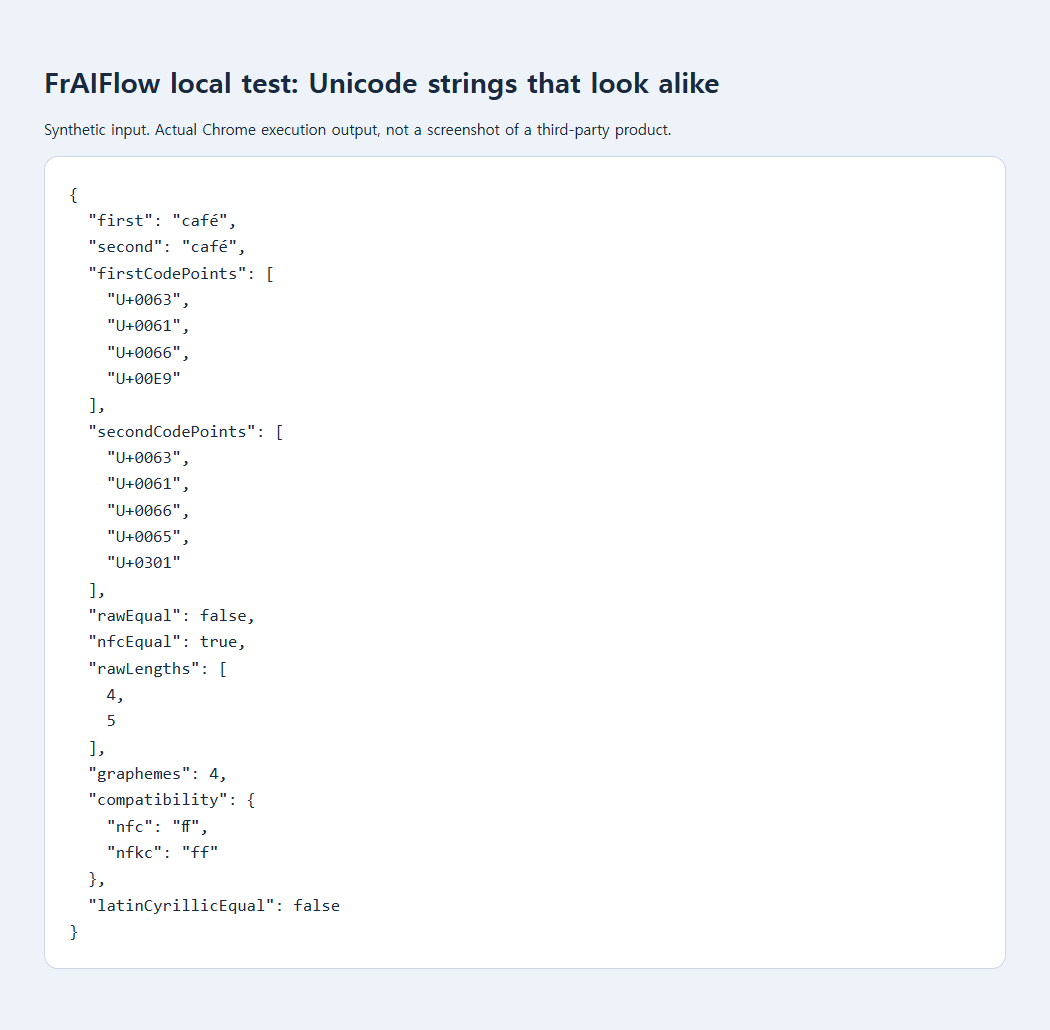
En Stack Overflow-fråga från 2019 beskrev visuellt liknande vietnamesisk text som inte klarade likhetskontroller. Svaret använde en gemensam normaliseringsform. Vårt sparade webbläsartest använder ett annat, syntetiskt café-par: direkt likhet var false, medan jämförelse av båda NFC-formerna gav true. Det är inte en återskapning av rapportörens applikation.
Gå igenom ett enda olikt par först
Innan du ändrar ett helt kalkylblad eller en databas kopierar du bara de två värden som borde matcha till ett litet lokalt skript. Använd ofarlig exempeltext om verkliga värden identifierar kunder. Att se kodpunkterna bredvid varandra hjälper mer än att gång på gång skriva om en accent.
const typed = "caf\u00E9";
const pasted = "cafe\u0301";
const points = s => Array.from(s, c =>
  "U+" + c.codePointAt(0).toString(16).toUpperCase().padStart(4, "0")
).join(" ");
console.log(points(typed));  // U+0063 U+0061 U+0066 U+00E9
console.log(points(pasted)); // U+0063 U+0061 U+0066 U+0065 U+0301
console.log(typed === pasted); // false
const matches = typed.normalize("NFC") === pasted.normalize("NFC");
console.log(matches); // true
Läs de två sekvenserna från vänster till höger. Här stämmer de första tre bokstäverna; bara representationen av den sista accentförsedda bokstaven skiljer sig. Det är situationen NFC är gjord för. Bilden nedan synliggör de två lagringsformerna. Det extra tecknet är en kombinerande accent, inte en oönskad extra bokstav.
För sökning eller importjämförelse skapar du en separat normaliserad nyckel och behåller originalvärdet för visning. Normalisera båda sidor av jämförelsen, även värden som redan finns i databasen. Om bara ny indata normaliseras blir gamla poster inkonsekventa. Kontrollera några par som ska matcha och några som måste förbli olika innan regeln används på alla poster.
Om resultatet fortfarande är false letar du efter avslutande blanksteg, hårda blanksteg eller ett annat alfabet. Ta inte automatiskt bort alla accenter eller skiljetecken. Det är ytterligare matchningsregler som kan slå ihop olika namn. Om en föreslagen dubblettgrupp påverkar konton, betalningar eller identitet bör den granskas i stället för att visuell likhet behandlas som bevis.
Ändra inte identifierare bara för att jämföra text
En NFC-matchning bevisar inte att två konton tillhör samma person. Förhandsgranska föreslagna dubblettgrupper och bestäm vad en matchning betyder för datan. Lägg inte till normalisering i lösenord, signaturer eller opaka token som en tillfällig städning: dessa system kan kräva exakta byte- eller teckenkontrakt.
Varför inte använda NFKC överallt?
NFKC lägger till kompatibilitetsmappningar. I det registrerade testet förblev ligaturen U+FB00 oförändrad under NFC men blev ff under NFKC. Det kan hjälpa en avsiktligt tolerant söknyckel, men förlora en skillnad som måste finnas kvar i originaltexten. Bestäm policyn innan du väljer omvandlingen.
Normalisering löser inte heller förväxlingsbara tecken: latinskt a och kyrilliskt U+0430 förblev olika i exemplet. Den definierar inte heller webbplatsens teckengräns. De två café-formerna mätte 4 respektive 5 JavaScript UTF-16-kodenheter. Grafemsegmentering av det dekomponerade ordet gav 4 läsaruppfattade grupper. Det är olika mått.
Källor, exempel och vidare läsning
- Offentlig diskussion: samma text men olika värden, hur konverteras de till samma kodning?
- Ursprungligt kompletterande diagram
- Sparat lokalt testunderlag
- MDN-referens: normalize
- Unicode-specifikation för normalisering
- MDN-referens: length
- Offentlig diskussion: räkna korrekt längd för en sträng med emoji i JavaScript
- Varför JSON som ser giltig ut misslyckas vid första tecknet
- Varför Base64 inte fungerar med all text