Waarom tekst die er hetzelfde uitziet toch niet overeenkomt
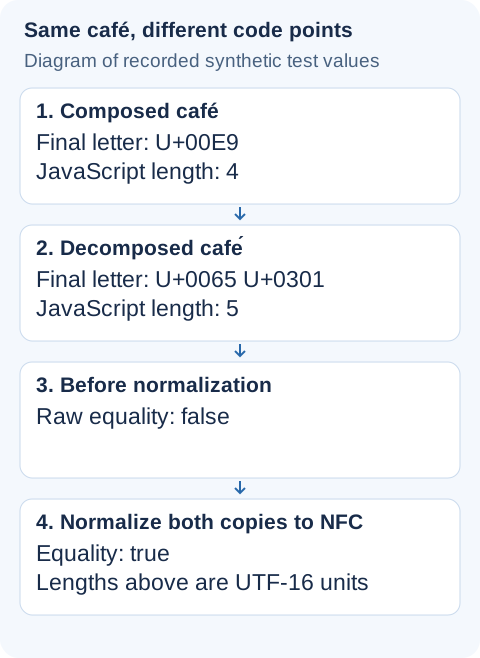
Twee exemplaren van café kunnen identiek ogen en toch ongelijk zijn bij een vergelijking. Het ene eindigt misschien op U+00E9, het andere op U+0065 gevolgd door het combinerende U+0301. Het accent is niet verkeerd. De opgeslagen Unicode-reeksen verschillen en de vergelijkingsregel moet rekening houden met dat onderscheid.
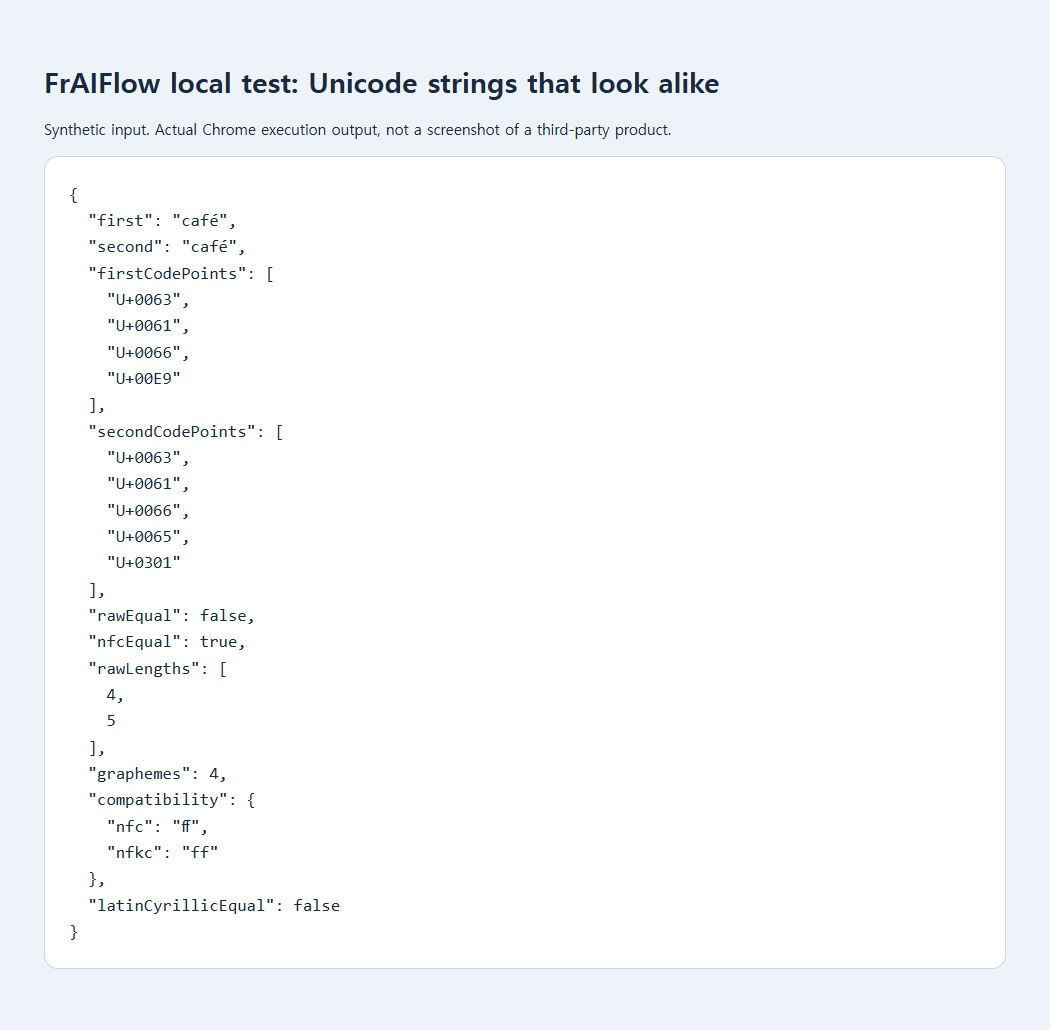
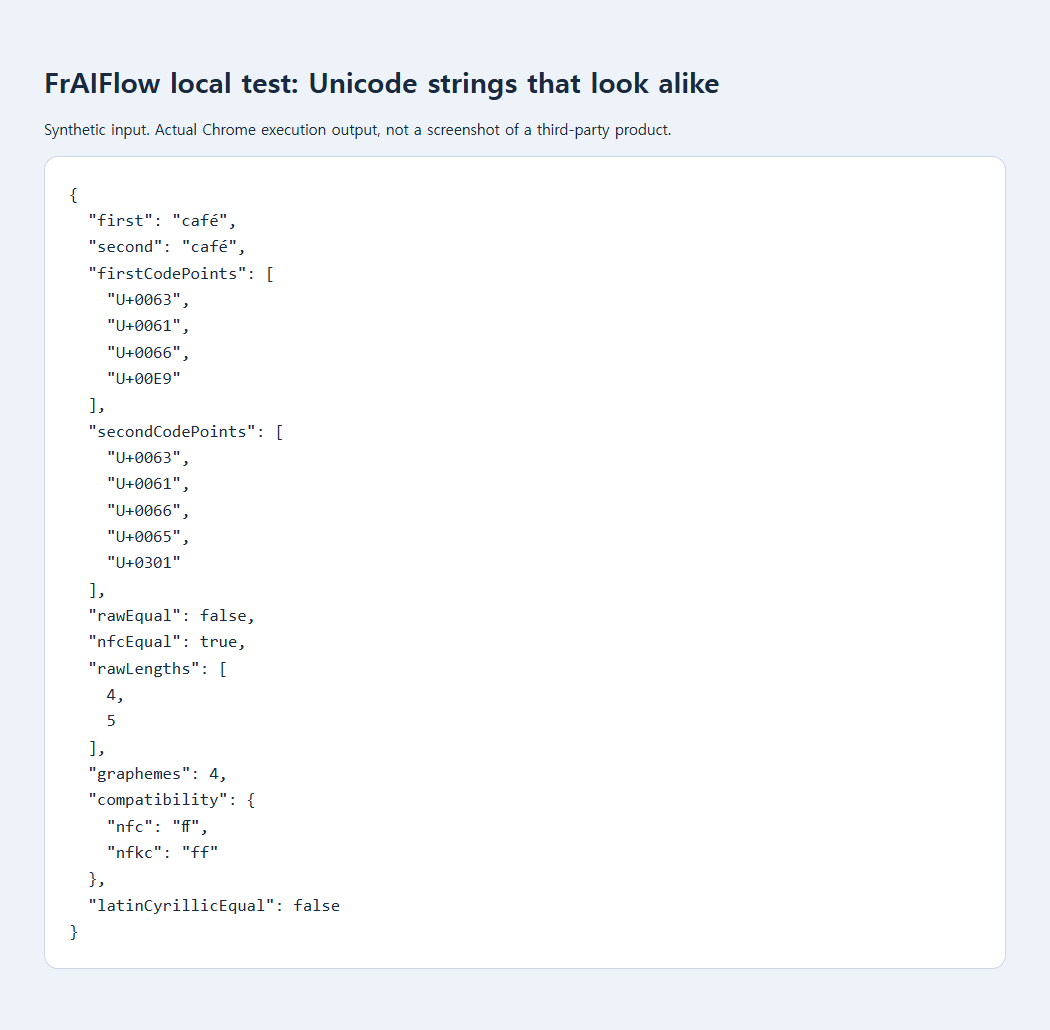
Een vraag op Stack Overflow uit 2019 beschreef visueel vergelijkbare Vietnamese tekst die niet door gelijkheidscontroles kwam. Het antwoord gebruikte een gemeenschappelijke normalisatievorm. Onze opgeslagen browsertest gebruikt een ander, synthetisch café-paar: directe gelijkheid was false, maar vergelijking van beide NFC-vormen gaf true. Dit is geen reconstructie van de toepassing van de melder.
Onderzoek eerst één paar dat niet overeenkomt
Kopieer voordat je een hele spreadsheet of database aanpast alleen de twee waarden die zouden moeten overeenkomen naar een klein lokaal script. Gebruik onschuldige voorbeeldtekst als de echte waarden klanten identificeren. De codepunten naast elkaar bekijken helpt veel meer dan steeds opnieuw een accent typen.
const typed = "caf\u00E9";
const pasted = "cafe\u0301";
const points = s => Array.from(s, c =>
  "U+" + c.codePointAt(0).toString(16).toUpperCase().padStart(4, "0")
).join(" ");
console.log(points(typed));  // U+0063 U+0061 U+0066 U+00E9
console.log(points(pasted)); // U+0063 U+0061 U+0066 U+0065 U+0301
console.log(typed === pasted); // false
const matches = typed.normalize("NFC") === pasted.normalize("NFC");
console.log(matches); // true
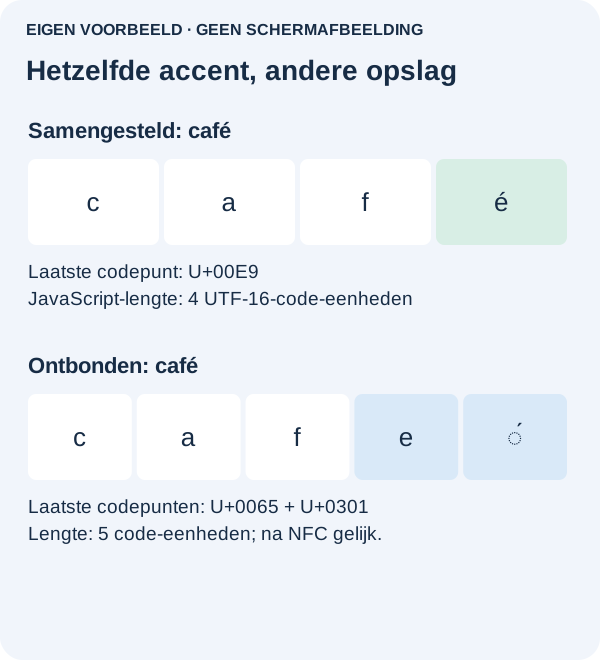
Lees de twee reeksen van links naar rechts. Hier zijn de eerste drie letters gelijk; alleen de opslagvorm van de laatste letter met accent verschilt. Daarvoor is NFC bedoeld. De illustratie hieronder maakt beide opslagvormen zichtbaar: het extra teken is een combinerend accent, geen ongewenste extra letter.
Maak voor een zoek- of importvergelijking een aparte genormaliseerde sleutel en bewaar de oorspronkelijke waarde voor weergave. Normaliseer beide kanten van een vergelijking, ook waarden die al in de database staan. Als je alleen nieuwe invoer normaliseert, blijven oude records inconsistent. Controleer vóór algemene toepassing enkele paren die moeten overeenkomen en enkele die juist verschillend moeten blijven.
Is het resultaat nog steeds false, zoek dan naar een afsluitende spatie, een vaste spatie of een ander alfabet. Verwijder niet als reactie alle accenten of leestekens. Dat zijn aanvullende vergelijkingsregels die verschillende namen kunnen samenvoegen. Gaat een voorgestelde groep duplicaten over accounts, betalingen of identiteit, laat die dan beoordelen in plaats van visuele gelijkenis als bewijs te behandelen.
Maak onderscheid tussen tekst vergelijken en een identiteit controleren
Een overeenkomst volgens NFC bewijst niet dat twee accounts van dezelfde persoon zijn. Bekijk voorgestelde groepen duplicaten vooraf en bepaal wat een overeenkomst voor de gegevens betekent. Voeg normalisatie niet als bijkomende opschoning toe aan wachtwoorden, handtekeningen of ondoorzichtige tokens: zulke systemen kunnen exacte afspraken over bytes of tekens vereisen.
Waarom niet overal NFKC gebruiken?
NFKC voegt compatibiliteitsomzettingen toe. In de geregistreerde test bleef de ligatuur U+FB00 onder NFC gelijk, maar werd deze onder NFKC ff. Dat kan nuttig zijn voor een bewust ruimere zoeksleutel, maar daarbij kan ook een onderscheid verloren gaan dat in de oorspronkelijke tekst belangrijk is. Kies eerst de vergelijkingsregels, daarna de omzetting.
Normalisatie lost ook gelijkende tekens niet op: de Latijnse a en de Cyrillische U+0430 bleven in het voorbeeld ongelijk. Ook bepaalt normalisatie niet de tekenlimiet van een website. De twee café-vormen telden 4 en 5 JavaScript UTF-16-code-eenheden; grafeemsegmentatie van het ontlede woord gaf 4 groepen zoals een lezer die ziet. Dat zijn verschillende metingen.
Bronnen, voorbeelden en meer informatie
- Openbare discussie: dezelfde ogende tekst is niet gelijk; hoe maak je de codering gelijk?
- Oorspronkelijk verklarend diagram
- Opgeslagen bewijs van de lokale test
- MDN-naslag: normalize
- Unicode-specificatie voor normalisatie
- MDN-naslag: length
- Openbare discussie: de juiste lengte tellen van een JavaScript-string met emoji
- Waarom ogenschijnlijk geldige JSON al bij het eerste teken vastloopt
- Waarom btoa() vastloopt op Unicode-tekens