Perché testi apparentemente identici non corrispondono
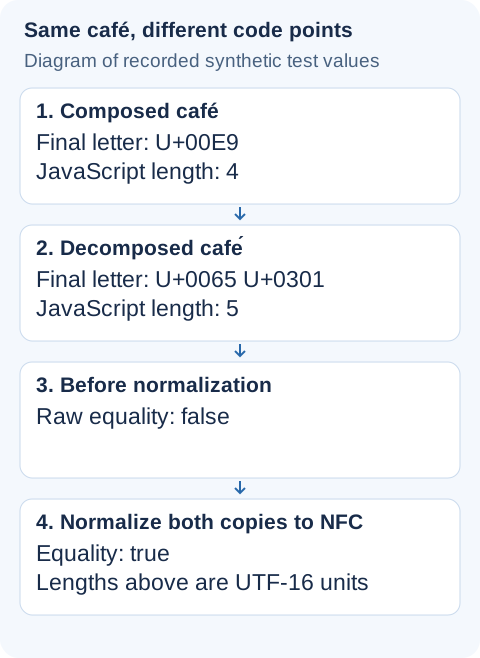
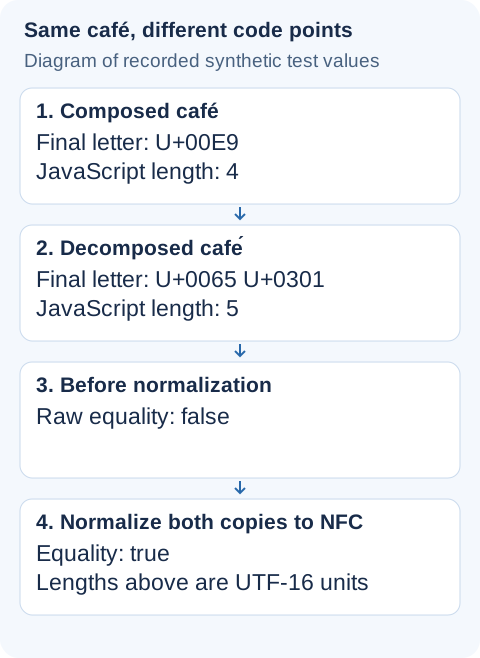
Due copie di café possono sembrare identiche e risultare diverse in un confronto. Una può terminare con U+00E9, l’altra con U+0065 seguito dall’accento combinante U+0301. L’accento non è sbagliato: differiscono le sequenze Unicode memorizzate, e la regola di confronto deve tenerne conto.
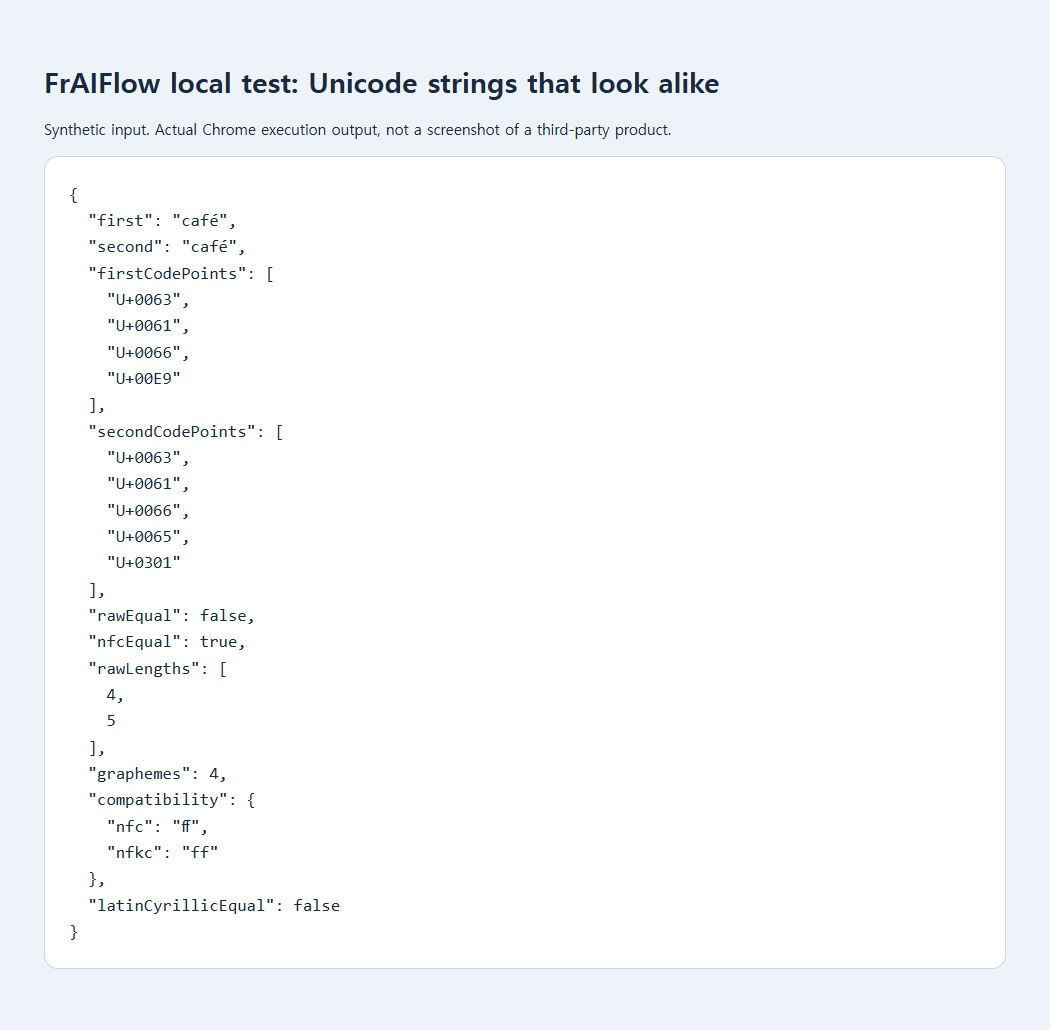
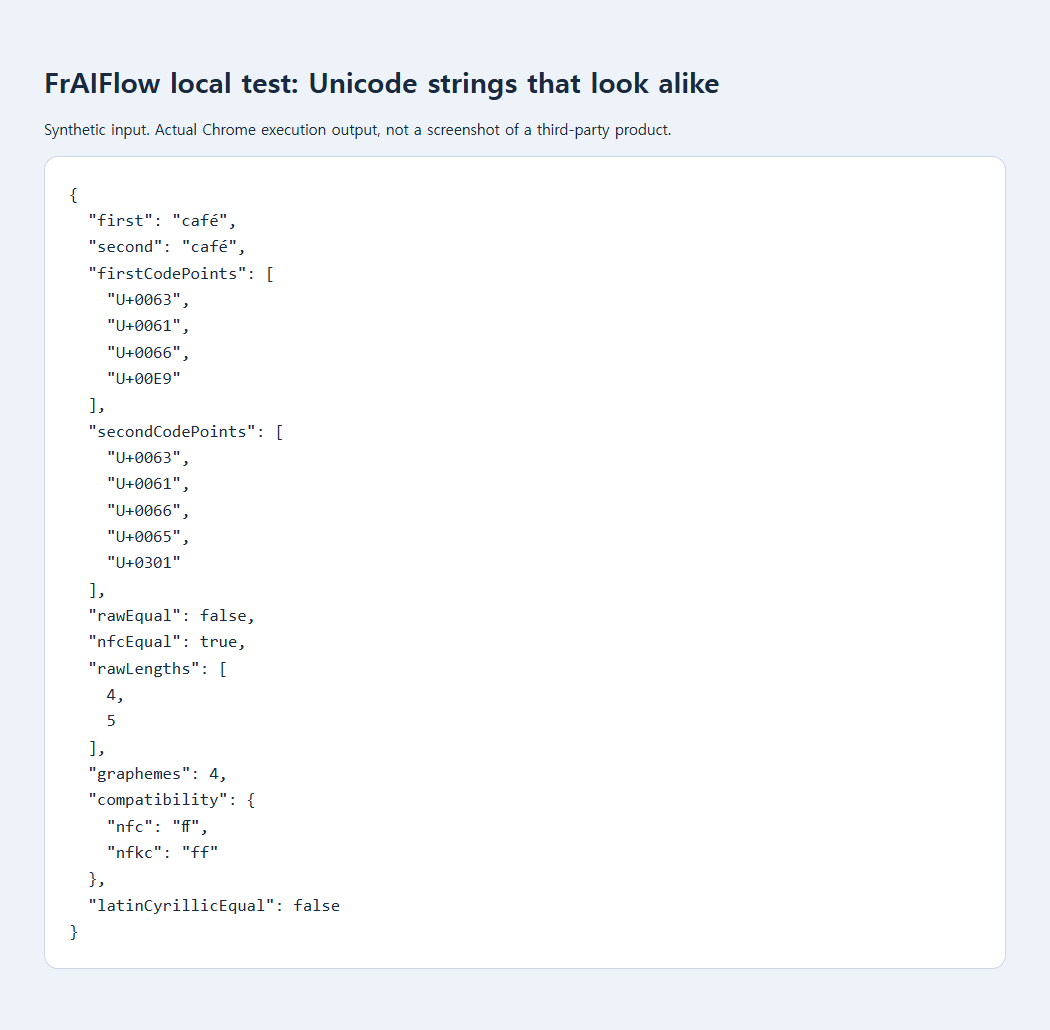
Una domanda su Stack Overflow del 2019 descriveva testi vietnamiti visivamente simili che non superavano un confronto di uguaglianza. La risposta usava una forma comune di normalizzazione. Il nostro test salvato nel browser usa una coppia diversa e sintetica di café: l’uguaglianza diretta dava false, il confronto delle due forme NFC dava true. Non riproduce l’applicazione dell’autore della domanda.
Esamina prima una sola coppia che non corrisponde
Prima di cambiare un intero foglio di calcolo o database, copia soltanto i due valori che dovrebbero corrispondere in un piccolo script locale. Usa testo innocuo se i valori reali identificano clienti. Vedere i punti di codice affiancati è molto più utile che riscrivere continuamente un accento.
const typed = "caf\u00E9";
const pasted = "cafe\u0301";
const points = s => Array.from(s, c =>
  "U+" + c.codePointAt(0).toString(16).toUpperCase().padStart(4, "0")
).join(" ");
console.log(points(typed));  // U+0063 U+0061 U+0066 U+00E9
console.log(points(pasted)); // U+0063 U+0061 U+0066 U+0065 U+0301
console.log(typed === pasted); // false
const matches = typed.normalize("NFC") === pasted.normalize("NFC");
console.log(matches); // true
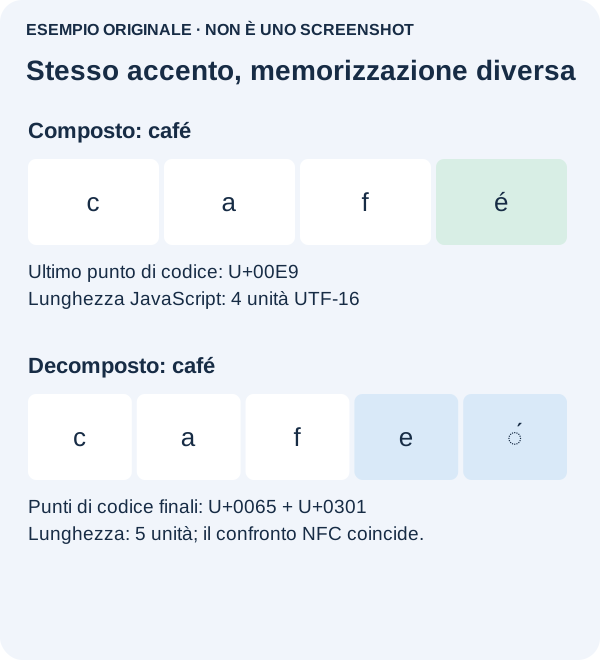
Leggi le due sequenze da sinistra a destra. Qui le prime tre lettere coincidono; cambia soltanto la rappresentazione della lettera finale accentata. È proprio il caso per cui serve NFC. L’illustrazione seguente rende visibili le due forme memorizzate: il segno aggiuntivo è un accento combinante, non una lettera indesiderata.
Per un confronto durante ricerche o importazioni, crea una chiave normalizzata separata e conserva l’originale per la visualizzazione. Normalizza entrambi i lati, compresi i valori già presenti nel database. Normalizzare solo il nuovo input lascia incoerenti i vecchi record. Prima di applicare la regola a tutto, controlla alcune coppie che devono corrispondere e altre che devono restare diverse.
Se il risultato resta false, cerca uno spazio finale, uno spazio non separabile o una lettera di un alfabeto diverso. Non eliminare automaticamente tutti gli accenti o la punteggiatura: sono ulteriori regole di confronto che possono fondere nomi diversi. Se un possibile duplicato riguarda account, pagamenti o identità, sottoponilo a revisione invece di considerare la somiglianza visiva una prova.
Separa il confronto dall’identità
Una corrispondenza in NFC non dimostra che due account appartengano alla stessa persona. Esamina prima i gruppi di possibili duplicati e stabilisci che cosa significhi corrispondere per quei dati. Non normalizzare password, firme o token opachi come semplice pulizia: quei sistemi possono richiedere byte o caratteri esatti.
Perché non usare sempre NFKC?
NFKC aggiunge equivalenze di compatibilità. Nel test registrato, la legatura U+FB00 restava invariata con NFC ma diventava ff con NFKC. Può aiutare una chiave di ricerca volutamente permissiva, ma perdere una distinzione necessaria nel testo originale. Scegli la regola prima della trasformazione.
La normalizzazione non risolve neppure i caratteri somiglianti: nell’esempio, la a latina e la U+0430 cirillica restavano diverse. Inoltre non definisce il limite di caratteri di un sito. Le due forme di café misuravano 4 e 5 unità di codice UTF-16 in JavaScript; la segmentazione in grafemi della forma decomposta produceva 4 gruppi percepiti dal lettore. Sono misure diverse.
Fonti, esempi e approfondimenti
- Discussione pubblica: testo uguale nell’aspetto ma diverso nel confronto, come uniformarlo
- Schema di supporto originale
- Documentazione del test locale salvato
- Riferimento MDN: normalize
- Specifica della normalizzazione Unicode
- Riferimento MDN: length
- Discussione pubblica: come contare correttamente una stringa con emoji in JavaScript
- Perché un JSON apparentemente valido fallisce al primo carattere
- Perché Base64 non funziona con il testo non inglese