Perché Base64 non funziona con il testo non inglese
Se btoa() gestisce Hello ma fallisce con il coreano o le emoji, di solito manca il passaggio di codifica del testo. Base64 rappresenta byte. Una stringa JavaScript deve prima essere convertita in byte secondo una convenzione concordata, e l’applicazione ricevente deve eseguire l’operazione inversa.
Una segnalazione pubblica riguardava markup SVG con caratteri non latini; un’altra decodificava contenuti dell’API GitHub ottenendo un simbolo di marchio illeggibile. Sono i due lati della stessa separazione. Una chiamata atob() riuscita restituisce una stringa binaria, non automaticamente testo UTF-8 leggibile.
Esegui un ciclo completo in UTF-8
Se gestisci il codice che produce Base64, correggi il passaggio dal testo ai byte invece di eliminare i caratteri che causano l’errore. Queste funzioni JavaScript per il browser rendono esplicito quel passaggio. Sono pensate per testi di dimensioni ragionevoli, non per caricamenti grandi.
function encodeUtf8Base64(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
function decodeUtf8Base64(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, c => c.charCodeAt(0));
  return new TextDecoder("utf-8", {
    fatal: true, ignoreBOM: true
  }).decode(bytes);
}
const original = "Hello, 한글 ™ 🌍";
const encoded = encodeUtf8Base64(original);
const restored = decodeUtf8Base64(encoded);
console.log(encoded); // SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==
console.log(restored === original); // true
Aggiungi le funzioni vicino al codice di conversione esistente e prova il campione prima di sostituirlo con contenuti reali. Il confronto di uguaglianza deve dare true. Se dà false, confronta le stringhe prima della codifica e dopo la decodifica: non giudicare il risultato solo perché “sembra Base64”. Includi nei test una lettera accentata, un’emoji e una stringa vuota.
Se ricevi soltanto i dati, chiedi quali byte abbia codificato il mittente. L’alfabeto Base64 non rivela se siano UTF-8. Una decodifica Base64 riuscita seguita da un errore UTF-8 può indicare un’altra codifica del testo o un file non testuale. Per PNG e PDF, conserva i byte decodificati in forma binaria anziché passarli a un decodificatore di testo.
In uno strumento per utenti, intercetta gli errori di input malformato e lascia disponibile il testo originale per correggerlo. Non trasformare una decodifica fallita in un risultato vuoto dichiarato riuscito. Non incollare token privati in convertitori online sconosciuti: Base64 rende il contenuto trasportabile, non segreto.
Perché i test solo ASCII nascondono il problema
Due opzioni del decodificatore meritano attenzione: fatal: true rifiuta UTF-8 non valido invece di inserire silenziosamente caratteri sostitutivi; ignoreBOM: true conserva un marcatore iniziale del testo. TextEncoder sostituisce un surrogato UTF-16 isolato, quindi questa trasformazione non è senza perdita per qualsiasi stringa JavaScript possibile.
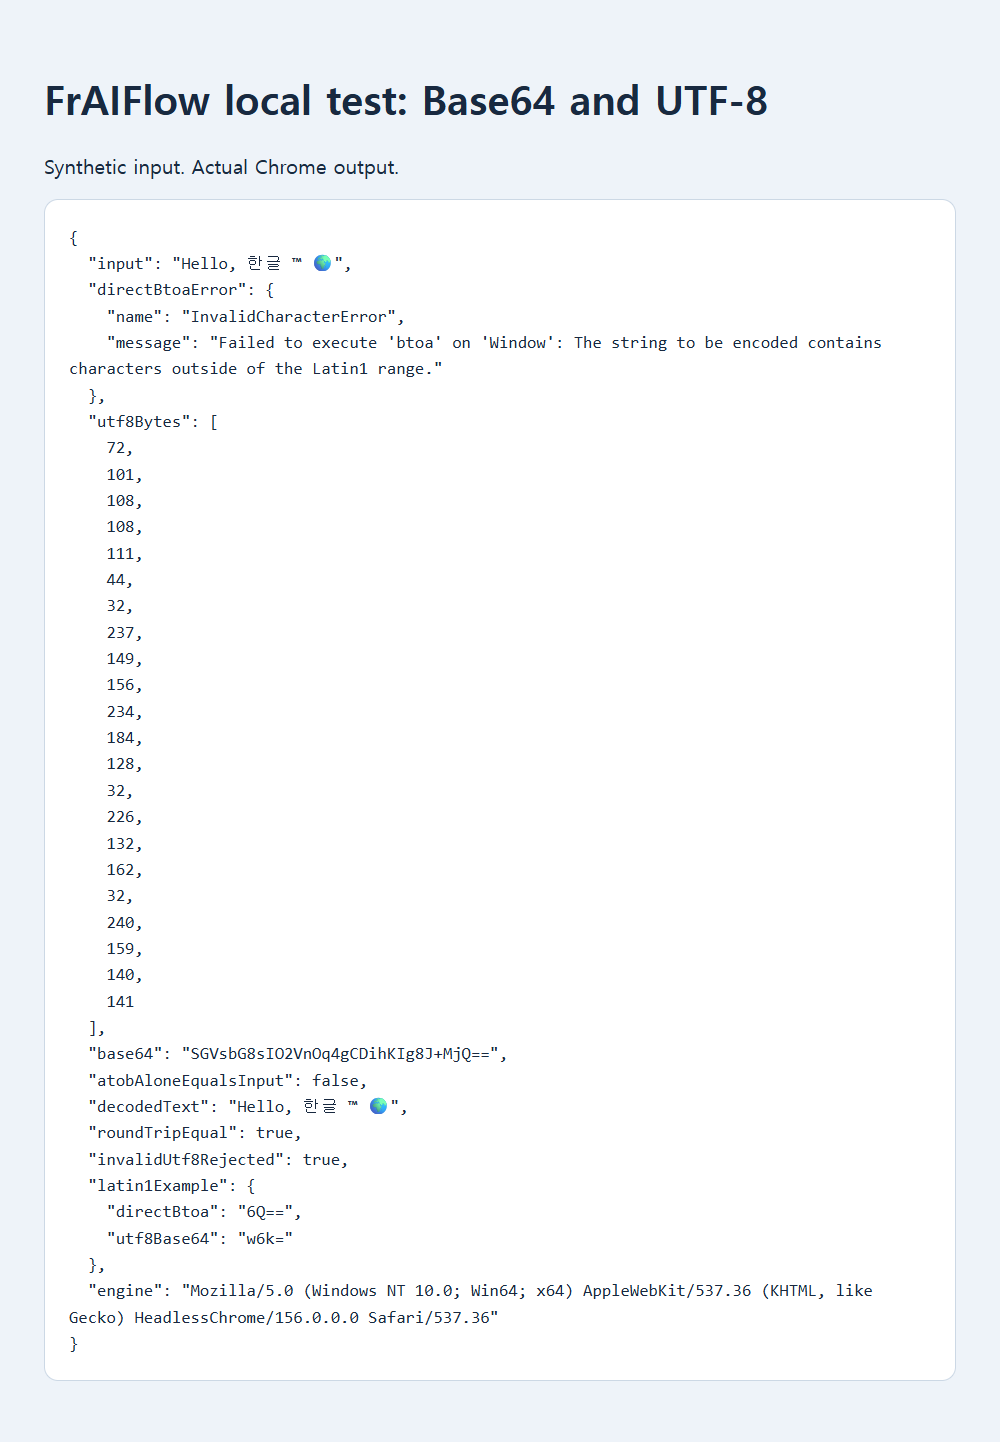
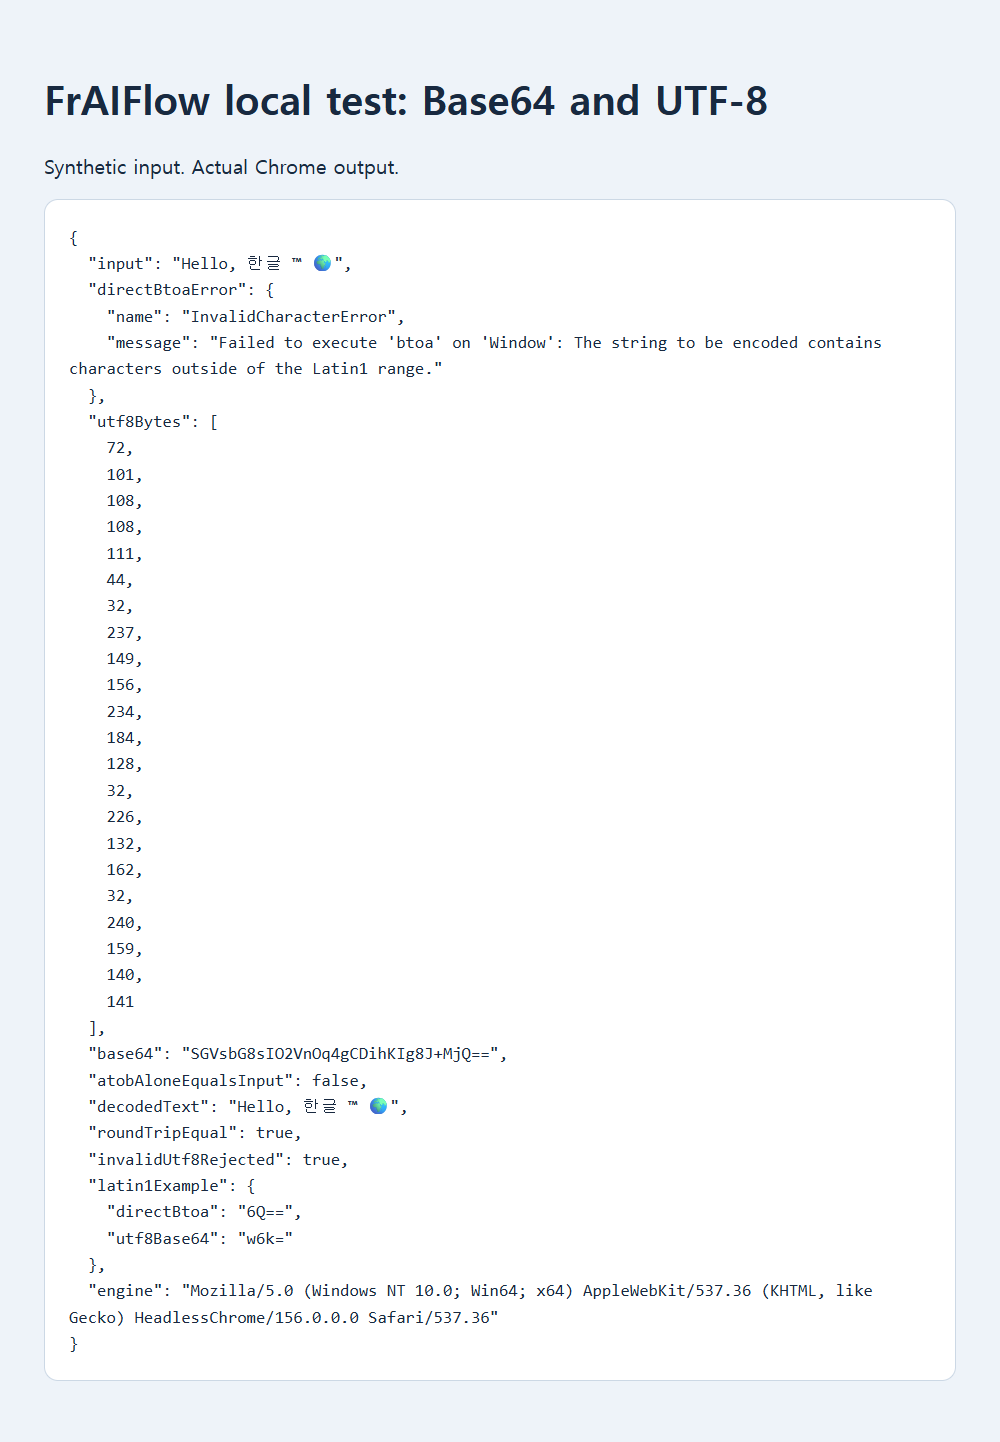
Un test locale salvato nel browser ha usato Hello, 한글 ™ 🌍. btoa() diretto ha generato InvalidCharacterError. TextEncoder ha prodotto 22 byte UTF-8, codificati in SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==. Decodificare quei byte come UTF-8 ha restituito esattamente la frase iniziale. È un test locale sintetico, non l’applicazione di uno dei segnalanti.
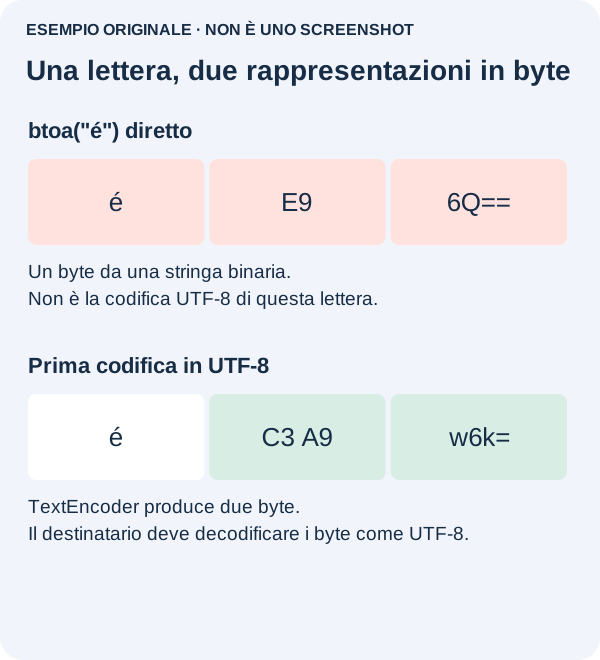
Provare solo ASCII può nascondere un difetto. Nell’esempio, btoa("é") ha restituito 6Q==, mentre la codifica preliminare UTF-8 ha dato w6k=. La prima chiamata non ha generato un’eccezione, ma i suoi byte sono sbagliati per un destinatario che si aspetta UTF-8. Base64 non contiene una dichiarazione della codifica dei caratteri.
Decodifica e verifica il ritorno all’originale
Base64 non è né crittografia né escape per URL. Il segno più può avere un significato speciale nei parametri di query: consulta la guida collegata. Evita il vecchio espediente con unescape, imposta limiti pratici alla dimensione dei dati e non esporre contenuti privati solo per dimostrare un errore di codifica.
Fonti, esempi e approfondimenti
- Discussione pubblica: codifica Base64 fallita con caratteri non latini
- Discussione pubblica: atob di JavaScript non decodifica correttamente stringhe UTF-8
- Riferimento MDN: btoa
- Schema di supporto originale
- Documentazione del test locale salvato
- Riferimento MDN: TextEncoder
- Riferimento MDN: atob
- Riferimento MDN: TextDecoder
- Riferimento MDN: ignoreBOM
- Riferimento MDN: decode
- Riferimento MDN: unescape
- Guida correlata: Base64 nei parametri di query
- Perché un JSON apparentemente valido fallisce al primo carattere
- Perché testi apparentemente identici non corrispondono