Por que o Base64 falha com texto em outros idiomas
Se btoa() aceita Hello, mas falha com texto em coreano ou emojis, geralmente falta a etapa de codificação de texto. Base64 representa bytes. Primeiro, uma string JavaScript precisa ser convertida em bytes segundo uma codificação definida, e o aplicativo que recebe os dados precisa desfazer essa conversão.
Um relato público envolvia marcação SVG com caracteres não latinos; outro decodificava conteúdo da API do GitHub, mas obtinha um símbolo de marca comercial corrompido. São dois lados da mesma fronteira. Uma chamada bem-sucedida a atob() retorna uma string binária, não automaticamente um texto UTF-8 legível.
Faça o percurso completo usando UTF-8
Se você mantém o código que produz o Base64, corrija a conversão entre texto e bytes em vez de remover os caracteres que causam o erro. Estas funções auxiliares de JavaScript para navegador tornam essa etapa explícita. Elas se destinam a volumes de texto razoavelmente pequenos, não a uploads grandes.
function encodeUtf8Base64(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
function decodeUtf8Base64(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, c => c.charCodeAt(0));
  return new TextDecoder("utf-8", {
    fatal: true, ignoreBOM: true
  }).decode(bytes);
}
const original = "Hello, 한글 ™ 🌍";
const encoded = encodeUtf8Base64(original);
const restored = decodeUtf8Base64(encoded);
console.log(encoded); // SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==
console.log(restored === original); // true
Coloque as funções junto ao código de conversão existente e teste com o exemplo antes de inserir conteúdo real. A comparação de igualdade deve retornar true. Se retornar false, compare as strings antes da codificação e depois da decodificação; não avalie o sucesso apenas porque a saída “parece Base64”. Inclua nos testes uma letra acentuada, um emoji e uma string vazia.
Se você apenas recebe os dados, pergunte quais bytes o remetente codificou. O alfabeto Base64 não informa se o conteúdo é UTF-8. Uma decodificação Base64 bem-sucedida seguida de erro UTF-8 pode indicar outra codificação de texto ou um arquivo que não é texto. Para um PNG ou PDF, preserve os bytes decodificados como dados binários em vez de submetê-los a um decodificador de texto.
Em uma ferramenta para usuários, capture os erros de entrada malformada e mantenha o conteúdo original disponível para edição. Não substitua uma falha de decodificação por um resultado vazio apresentado como sucesso. Nunca cole tokens privados em um conversor on-line desconhecido: Base64 torna o conteúdo transportável, não secreto.
Por que testar só ASCII não revela o problema
Duas escolhas do decodificador merecem atenção: fatal: true rejeita UTF-8 inválido em vez de inserir silenciosamente caracteres de substituição; ignoreBOM: true preserva um marcador inicial de texto. Um substituto UTF-16 isolado é substituído pelo TextEncoder; portanto, esta transformação não é sem perdas para toda string JavaScript possível.
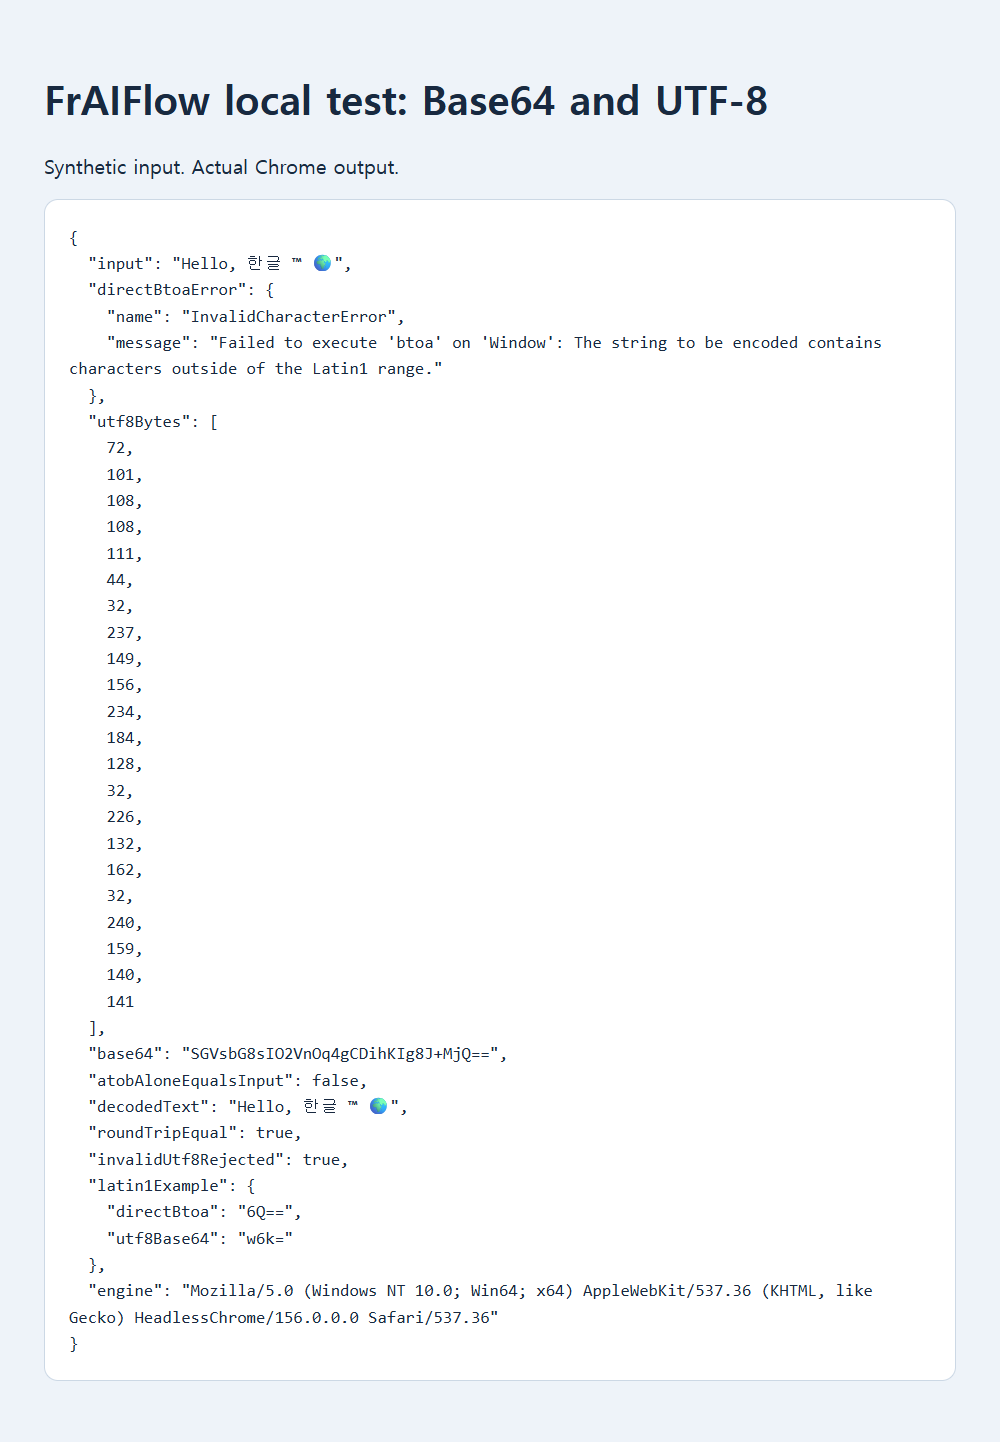
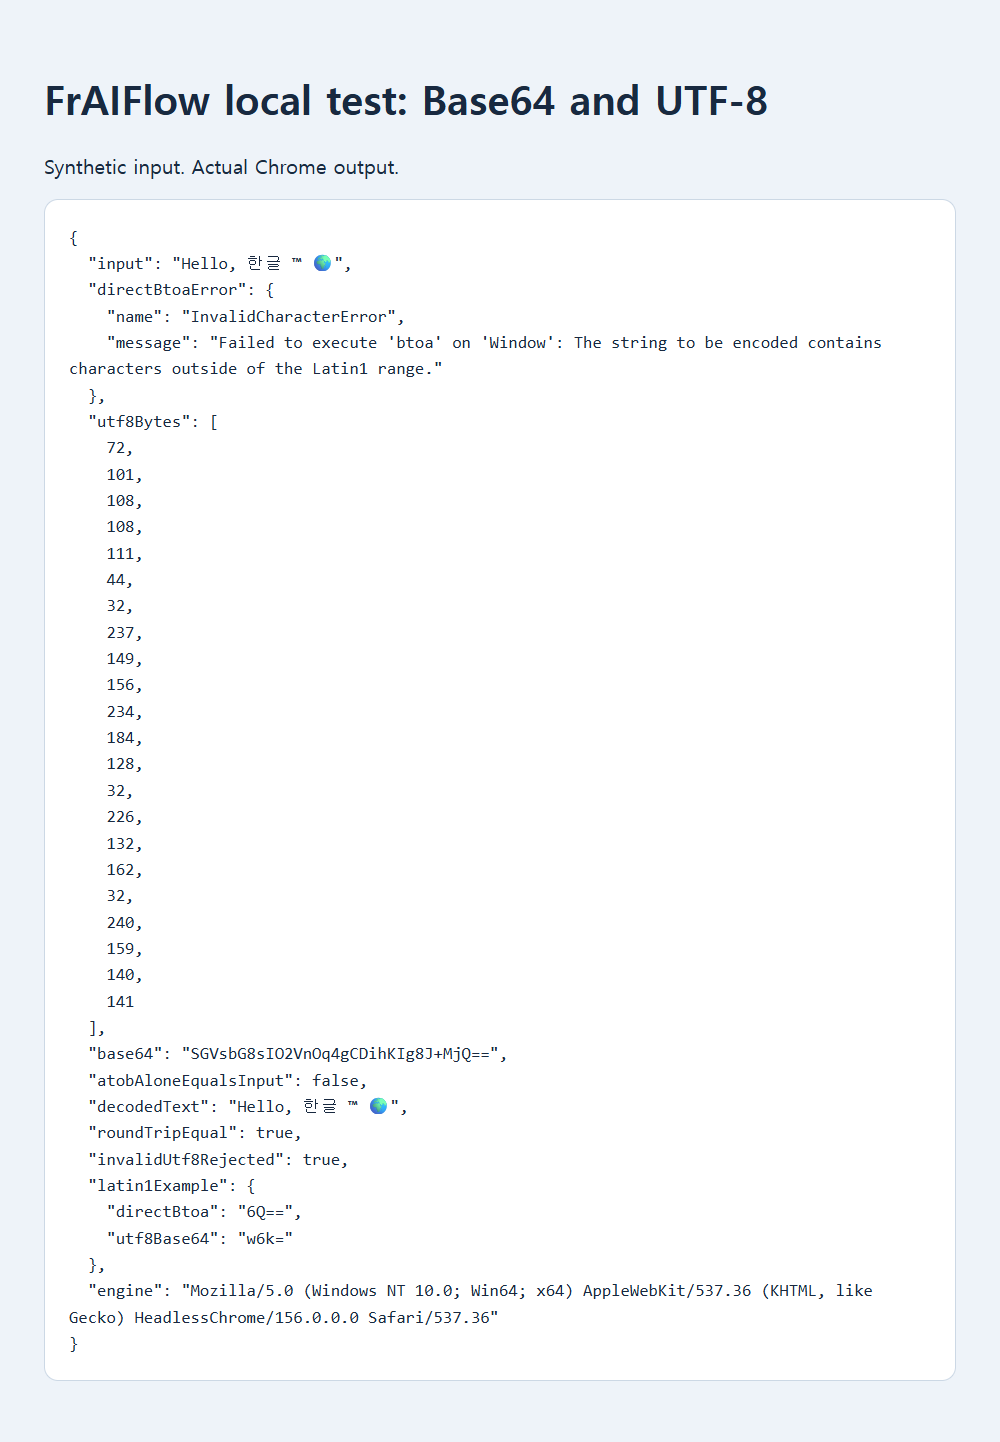
Um teste local de navegador preservado usou Hello, 한글 ™ 🌍. A chamada direta a btoa() lançou InvalidCharacterError. TextEncoder produziu 22 bytes UTF-8, codificados como SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==. Decodificar esses bytes como UTF-8 restaurou a frase exata. É um teste local sintético, não o aplicativo de nenhum dos autores dos relatos.
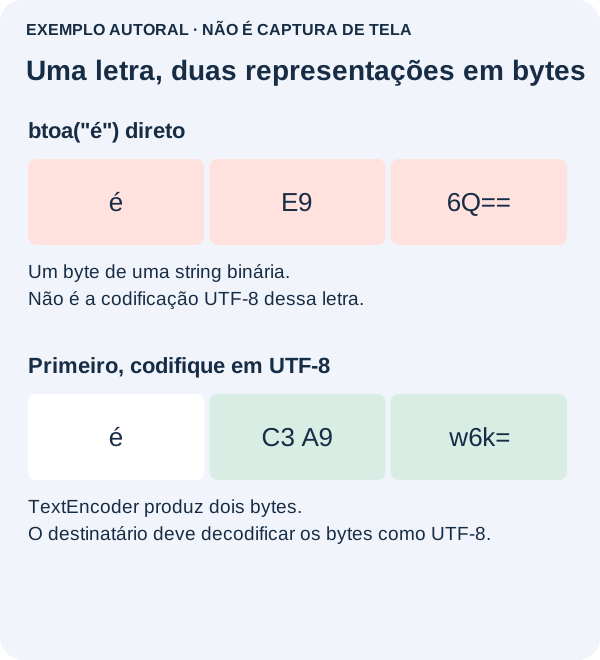
Testar somente ASCII pode esconder um erro. No exemplo, btoa("é") retornou 6Q==, enquanto a codificação UTF-8 prévia retornou w6k=. A primeira chamada não lançou erro, mas seus bytes são inadequados para um destinatário que espera UTF-8. O Base64 em si não contém uma declaração de codificação de caracteres.
Decodifique e confira o percurso de ida e volta
Base64 não é criptografia nem escape de URL. Um sinal de mais pode receber interpretação especial em parâmetros de consulta; siga o guia de parâmetros indicado nos links. Evite a solução alternativa obsoleta com unescape, defina limites práticos de volume e nunca exponha conteúdo privado só para demonstrar um erro de codificação.
Fontes, exemplos e leituras adicionais
- Discussão pública: codificação base64 falha com caracteres não latinos
- Discussão pública: atob do JavaScript não decodifica corretamente strings UTF-8 em base64
- Referência MDN: btoa
- Diagrama complementar original
- Evidência preservada do teste local
- Referência MDN: TextEncoder
- Referência MDN: atob
- Referência MDN: TextDecoder
- Referência MDN: ignoreBOM
- Referência MDN: decode
- Referência MDN: unescape
- Guia relacionado: base64 em parâmetro de consulta
- Por que um JSON aparentemente válido falha no primeiro caractere
- Por que textos visualmente idênticos não coincidem