Vì sao Base64 làm hỏng văn bản không phải tiếng Anh?
Nếu btoa() xử lý được Hello nhưng lỗi với chữ Hàn hoặc emoji, bước còn thiếu thường là mã hóa văn bản. Base64 biểu diễn các byte. Trước hết chuỗi JavaScript cần được chuyển thành byte theo một quy ước, rồi ứng dụng nhận phải đảo ngược phép chuyển đổi đó.
Một báo cáo công khai gặp vấn đề với mã SVG chứa ký tự ngoài bảng chữ Latin; báo cáo khác giải mã nội dung từ GitHub API nhưng ký hiệu nhãn hiệu bị lỗi. Đây là hai đầu của cùng một ranh giới xử lý. atob() chạy thành công sẽ trả về chuỗi nhị phân, không tự động trở thành văn bản UTF-8 có thể đọc được.
Thực hiện trọn vẹn chu trình mã hóa và giải mã UTF-8
Nếu bạn quản lý đoạn mã tạo Base64, hãy sửa bước chuyển văn bản thành dữ liệu nhị phân thay vì loại bỏ những ký tự gây lỗi. Các hàm JavaScript dành cho trình duyệt dưới đây làm rõ ranh giới đó. Chúng phù hợp với nội dung văn bản tương đối nhỏ, không dành cho tệp tải lên lớn.
function encodeUtf8Base64(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
function decodeUtf8Base64(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, c => c.charCodeAt(0));
  return new TextDecoder("utf-8", {
    fatal: true, ignoreBOM: true
  }).decode(bytes);
}
const original = "Hello, 한글 ™ 🌍";
const encoded = encodeUtf8Base64(original);
const restored = decodeUtf8Base64(encoded);
console.log(encoded); // SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==
console.log(restored === original); // true
Đặt các hàm bên cạnh mã chuyển đổi hiện có, rồi thử mẫu trước khi thay bằng nội dung thực. Phép so sánh bằng nhau phải trả về true. Nếu là false, hãy đối chiếu chuỗi trước mã hóa và sau giải mã; đừng đánh giá chỉ dựa vào việc đầu ra có “trông giống Base64” hay không. Bộ thử nên có một chữ có dấu, một emoji và chuỗi rỗng.
Nếu bạn chỉ nhận dữ liệu, hãy hỏi bên gửi đã mã hóa những byte nào. Bảng chữ Base64 không cho biết dữ liệu là UTF-8. Giải mã Base64 thành công nhưng tiếp đó lỗi UTF-8 có thể cho thấy dữ liệu dùng bảng mã khác hoặc không phải văn bản. Với PNG hay PDF, giữ các byte đã giải mã dưới dạng nhị phân, thay vì đưa chúng qua bộ giải mã văn bản.
Trong công cụ dành cho người dùng, hãy bắt lỗi đầu vào sai định dạng và giữ nguyên dữ liệu ban đầu để họ chỉnh sửa. Đừng biến lỗi giải mã thành kết quả trống rồi báo thành công. Không dán token riêng tư vào công cụ chuyển đổi trực tuyến không rõ nguồn gốc: Base64 giúp vận chuyển nội dung, không bảo mật nội dung.
Vì sao thử nghiệm chỉ với ASCII bỏ sót lỗi?
Có hai lựa chọn của bộ giải mã đáng chú ý: fatal: true từ chối UTF-8 không hợp lệ thay vì âm thầm chèn ký tự thay thế; ignoreBOM: true giữ lại dấu đánh dấu ở đầu văn bản. TextEncoder thay thế surrogate UTF-16 không có cặp, nên đây không phải phép chuyển đổi không mất dữ liệu với mọi chuỗi JavaScript có thể có.
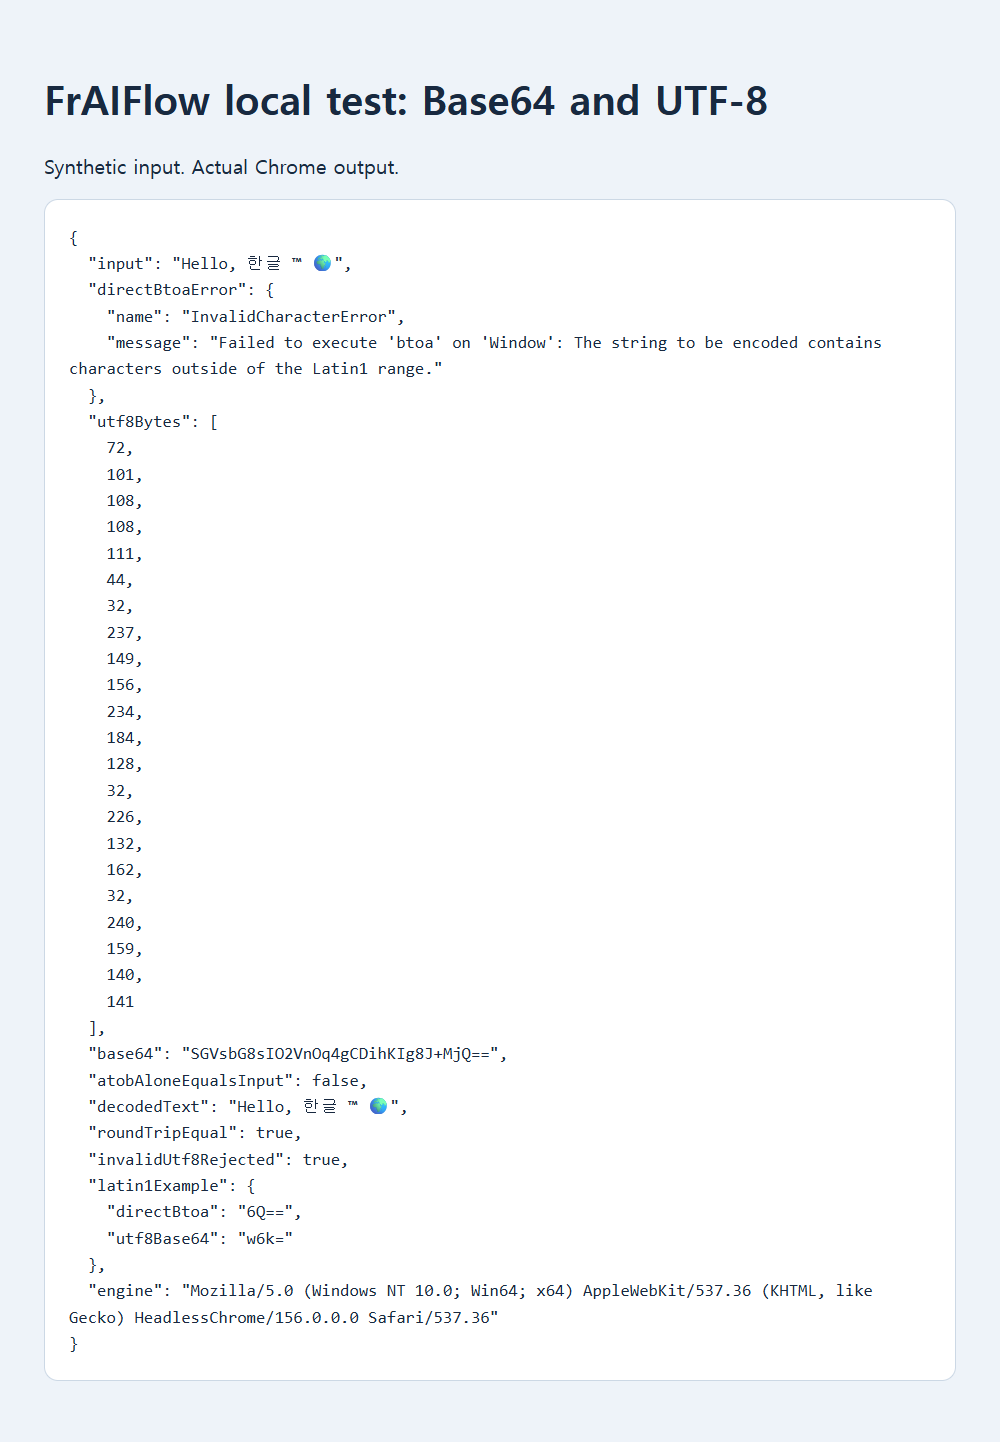
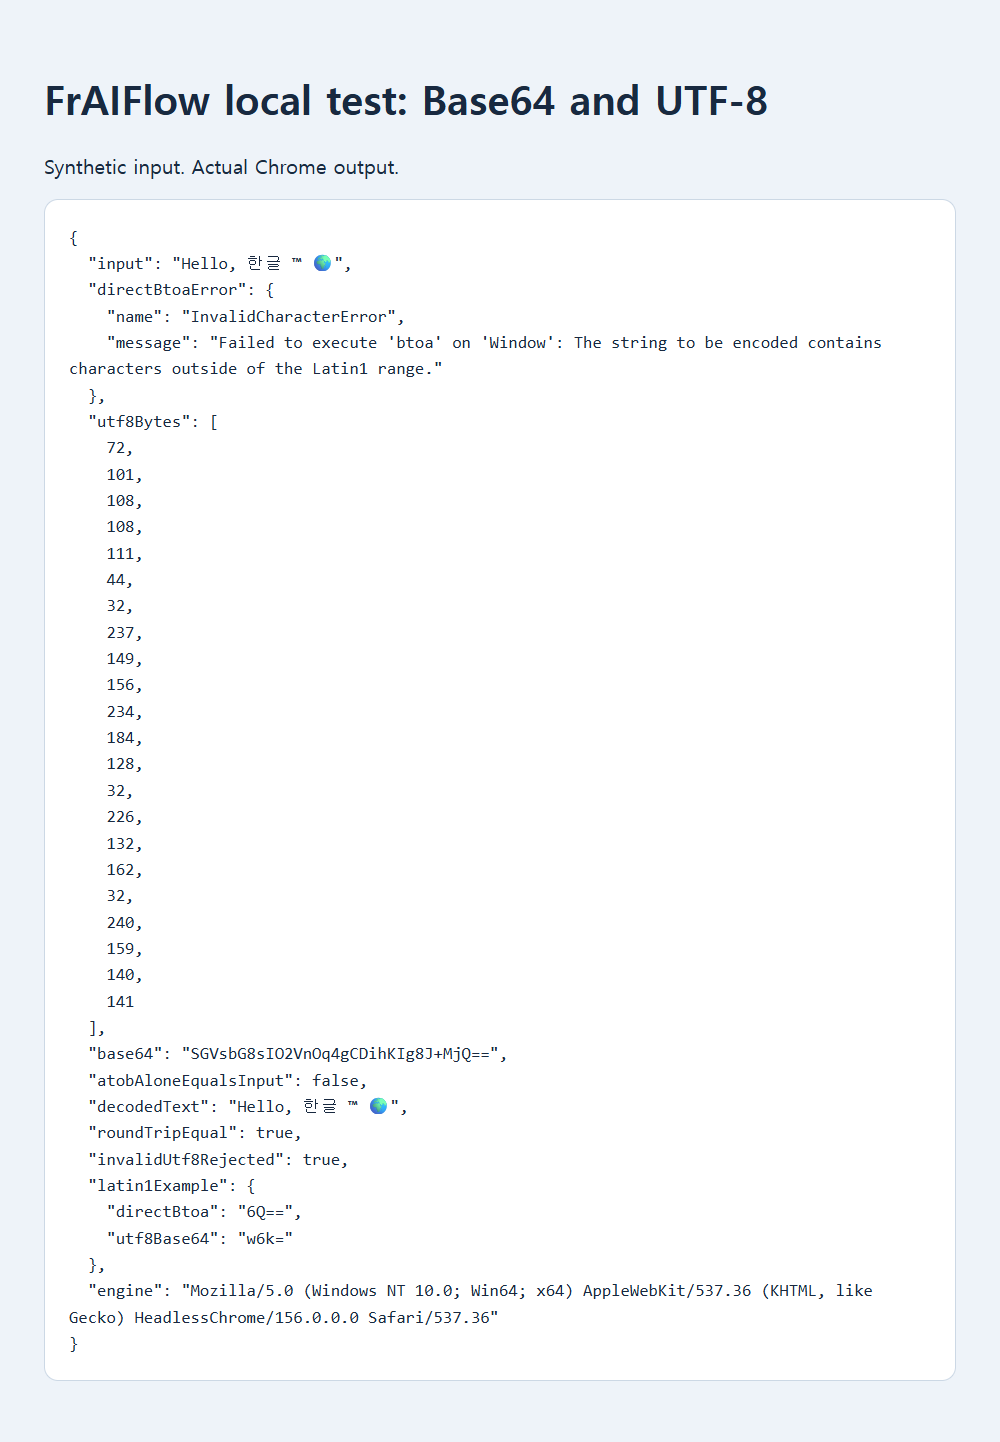
Một thử nghiệm trình duyệt cục bộ đã lưu sử dụng Hello, 한글 ™ 🌍. Gọi btoa() trực tiếp gây InvalidCharacterError. TextEncoder tạo ra 22 byte UTF-8, được mã hóa thành SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==. Giải mã các byte đó theo UTF-8 khôi phục chính xác câu ban đầu. Đây là thử nghiệm tổng hợp trên máy, không phải ứng dụng của những người báo lỗi.
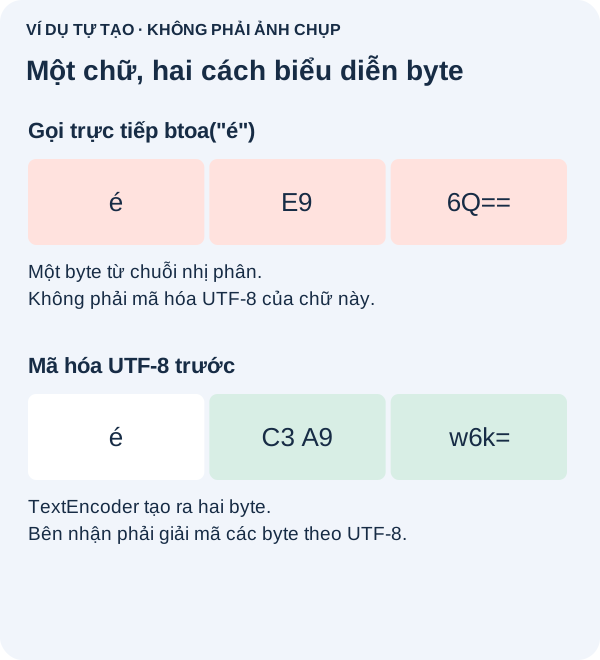
Chỉ thử ASCII có thể che giấu lỗi. Trong ví dụ, btoa("é") trả về 6Q==, còn mã hóa UTF-8 trước trả về w6k=. Lần gọi đầu không phát sinh ngoại lệ, nhưng các byte không đúng với bên nhận đang chờ UTF-8. Bản thân Base64 không mang khai báo bảng mã ký tự.
Giải mã và kiểm tra việc khôi phục nguyên văn
Base64 không phải mã hóa bảo mật hay thoát ký tự URL. Dấu cộng có thể được xử lý đặc biệt trong tham số truy vấn; xem hướng dẫn tham số truy vấn được liên kết. Tránh cách xử lý tạm bằng unescape đã lỗi thời, đặt giới hạn dung lượng hợp lý và không công khai nội dung riêng tư chỉ để minh họa lỗi mã hóa.
Nguồn, ví dụ và bài đọc thêm
- Thảo luận công khai: mã hóa Base64 thất bại với ký tự ngoài Latin
- Thảo luận công khai: atob trong JavaScript giải mã Base64 nhưng không giải mã đúng chuỗi UTF-8
- Tài liệu MDN: btoa
- Sơ đồ bổ trợ gốc
- Bằng chứng thử nghiệm cục bộ đã lưu
- Tài liệu MDN: TextEncoder
- Tài liệu MDN: atob
- Tài liệu MDN: TextDecoder
- Tài liệu MDN: ignoreBOM
- Tài liệu MDN: decode
- Tài liệu MDN: unescape
- Hướng dẫn liên quan: Base64 trong tham số truy vấn
- Vì sao JSON trông hợp lệ lại lỗi ngay ký tự đầu?
- Vì sao văn bản trông giống nhau lại không khớp?