Waarom btoa() vastloopt op Unicode-tekens
Werkt btoa() wel met Hello, maar niet met Koreaanse tekst of emoji? Meestal ontbreekt de stap waarin tekst wordt gecodeerd. Base64 stelt bytes voor. Een JavaScript-string moet eerst volgens een afgesproken codering worden omgezet in bytes; de ontvangende toepassing moet die omzetting weer ongedaan maken.
In een openbare melding ging het om SVG-opmaak met niet-Latijnse tekens; iemand anders decodeerde inhoud uit de GitHub-API en kreeg een onleesbaar handelsmerkteken. In beide gevallen gaat het mis bij de omzetting tussen tekst en bytes. Een geslaagde aanroep van atob() levert een binaire string op, niet automatisch leesbare UTF-8-tekst.
Zet tekst om naar UTF-8-bytes en controleer de weg terug
Beheer je de code die Base64 maakt, herstel dan de overgang van tekst naar bytes in plaats van de tekens te verwijderen die de fout veroorzaken. Deze hulpfuncties voor JavaScript in de browser maken die overgang expliciet. Ze zijn bedoeld voor redelijk kleine hoeveelheden tekst, niet voor grote uploads.
function encodeUtf8Base64(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
function decodeUtf8Base64(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, c => c.charCodeAt(0));
  return new TextDecoder("utf-8", {
    fatal: true, ignoreBOM: true
  }).decode(bytes);
}
const original = "Hello, 한글 ™ 🌍";
const encoded = encodeUtf8Base64(original);
const restored = decodeUtf8Base64(encoded);
console.log(encoded); // SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==
console.log(restored === original); // true
Plaats de hulpfuncties bij je bestaande conversiecode en probeer eerst het voorbeeld voordat je echte inhoud gebruikt. De gelijkheidscontrole moet true opleveren. Is het resultaat false, vergelijk dan de strings vóór het coderen en na het decoderen. Beoordeel het resultaat niet alleen op de vraag of het eruitziet als Base64. Test ook een letter met accent, een emoji en een lege string.
Ontvang je alleen gegevens, vraag dan welke bytes de afzender heeft gecodeerd. Aan het Base64-alfabet kun je niet zien of UTF-8 is gebruikt. Een geslaagde Base64-decodering gevolgd door een UTF-8-fout kan wijzen op een andere tekstcodering of op een bestand dat geen tekst bevat. Bewaar bij een PNG of PDF de gedecodeerde bytes als binaire gegevens; haal ze niet door een tekstdecoder.
Vang fouten door ongeldige invoer op in een gebruikerstool en laat de oorspronkelijke invoer beschikbaar om te bewerken. Presenteer een mislukte decodering niet als een geslaagd, leeg resultaat. Plak nooit privétokens in een onbekende online converter: Base64 maakt inhoud overdraagbaar, niet geheim.
Waarom tests met alleen ASCII het probleem missen
Twee decoderopties verdienen aandacht: fatal: true weigert ongeldige UTF-8 in plaats van stilzwijgend vervangingstekens in te voegen; ignoreBOM: true behoudt een tekstmarkering aan het begin. TextEncoder vervangt een ongepaarde UTF-16-surrogaatcode. De omzetting is dus niet verliesvrij voor elke mogelijke JavaScript-string.
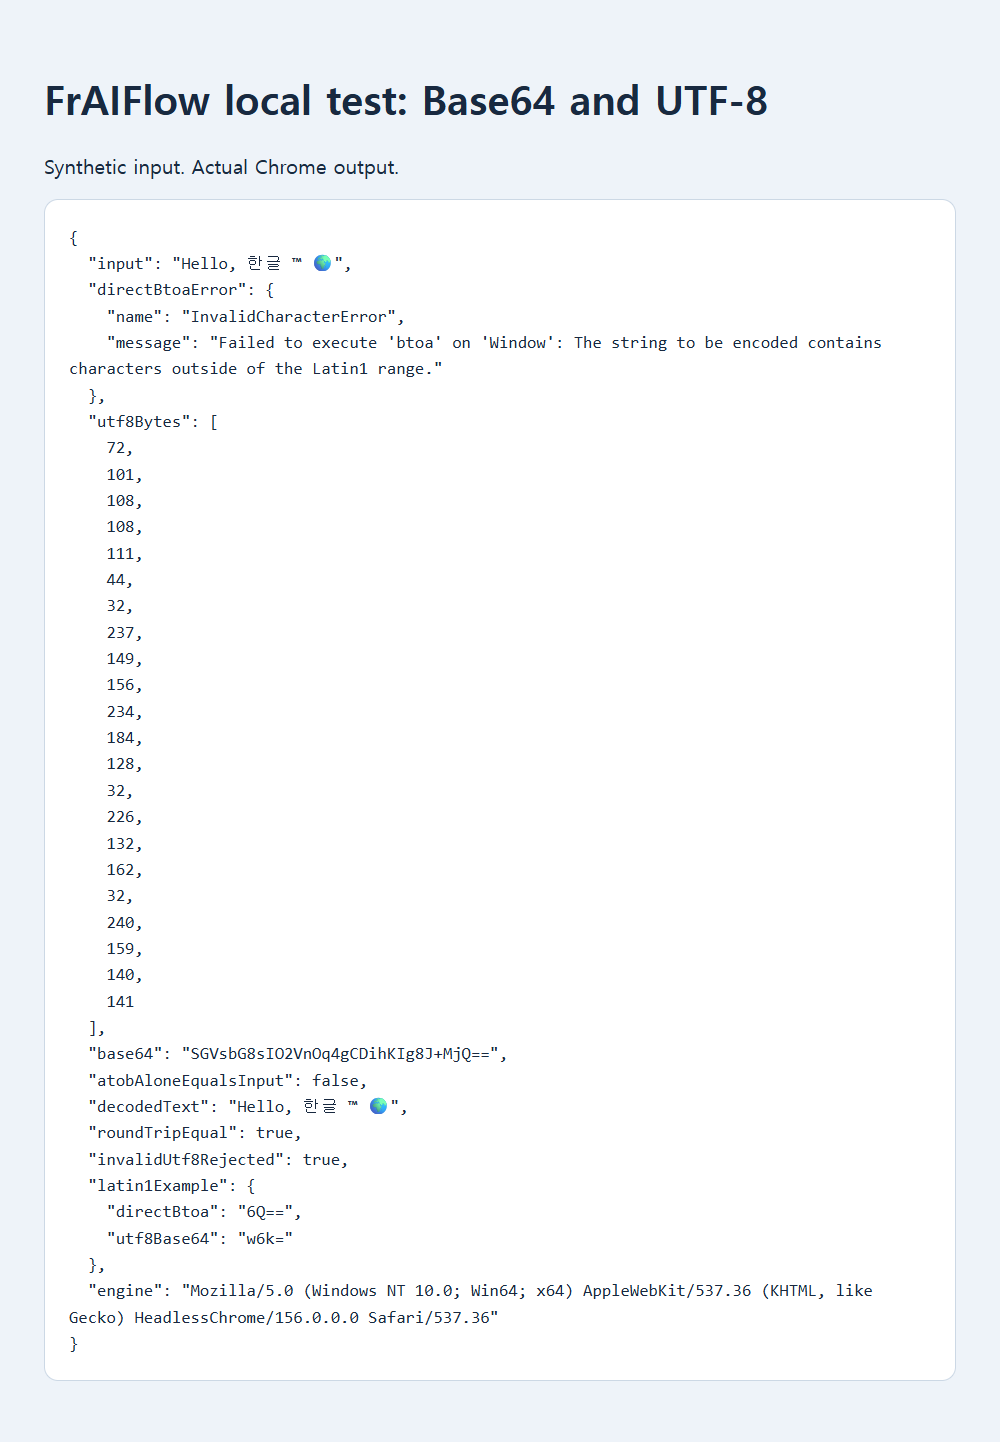
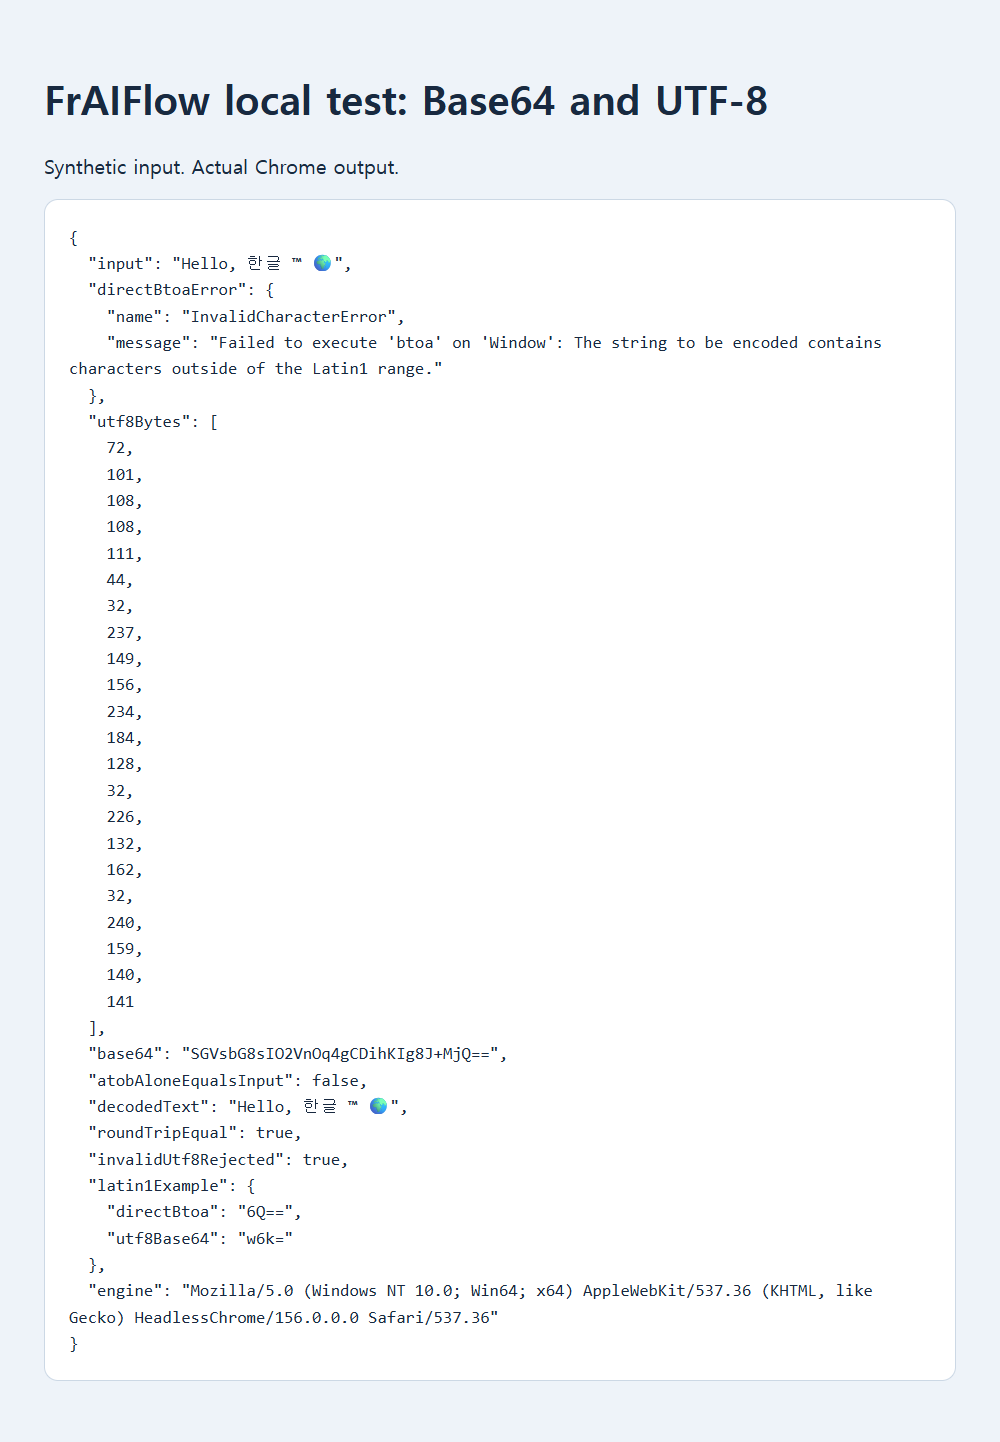
Een opgeslagen lokale browsertest gebruikte Hello, 한글 ™ 🌍. Rechtstreeks btoa() aanroepen gaf InvalidCharacterError. TextEncoder maakte 22 UTF-8-bytes, die werden gecodeerd als SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==. Door die bytes als UTF-8 te decoderen kwam precies dezelfde zin terug. Dit is een synthetische lokale test, niet de toepassing van een van de melders.
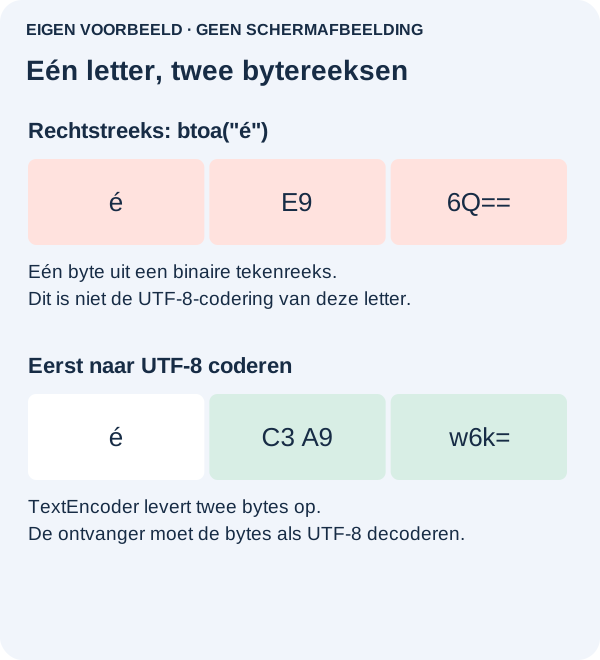
Testen met alleen ASCII kan een fout verbergen. In het voorbeeld gaf btoa("é") de waarde 6Q==, terwijl eerst UTF-8 coderen w6k= opleverde. De eerste aanroep gaf geen fout, maar de bytes zijn onjuist voor een ontvanger die UTF-8 verwacht. Base64 zelf bevat geen aanduiding van de tekencodering.
Controleer of decoderen de oorspronkelijke tekst teruggeeft
Base64 is geen versleuteling en ook geen URL-escaping. Een plusteken kan in queryparameters een bijzondere betekenis hebben; volg daarvoor de gekoppelde handleiding. Vermijd de verouderde oplossing met unescape, stel praktische limieten voor de invoergrootte in en maak nooit privé-inhoud openbaar om een coderingsfout te demonstreren.
Bronnen, voorbeelden en meer informatie
- Openbare discussie: Base64-codering mislukt bij niet-Latijnse tekens
- Openbare discussie: atob in JavaScript decodeert Base64 niet correct als UTF-8-tekst
- MDN-naslag: btoa
- Oorspronkelijk verklarend diagram
- Opgeslagen bewijs van de lokale test
- MDN-naslag: TextEncoder
- MDN-naslag: atob
- MDN-naslag: TextDecoder
- MDN-naslag: ignoreBOM
- MDN-naslag: decode
- MDN-naslag: unescape
- Verwante handleiding: Base64 in queryparameters
- Waarom ogenschijnlijk geldige JSON al bij het eerste teken vastloopt
- Waarom tekst die er hetzelfde uitziet toch niet overeenkomt