Waarom ogenschijnlijk geldige JSON al bij het eerste teken vastloopt
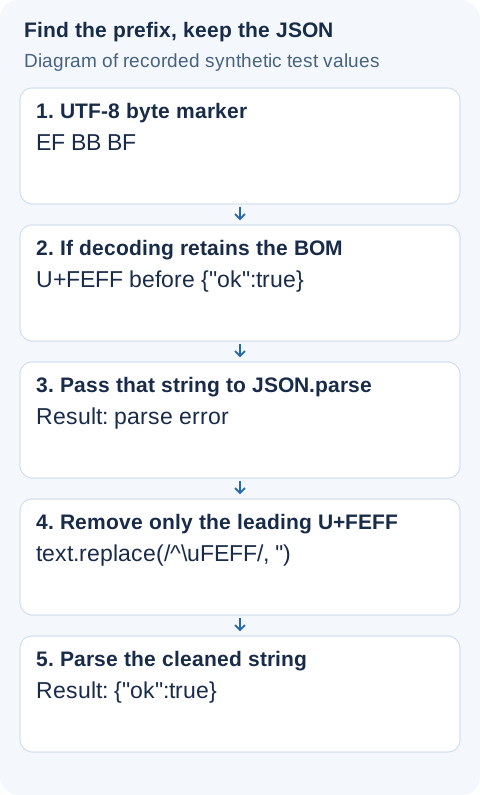
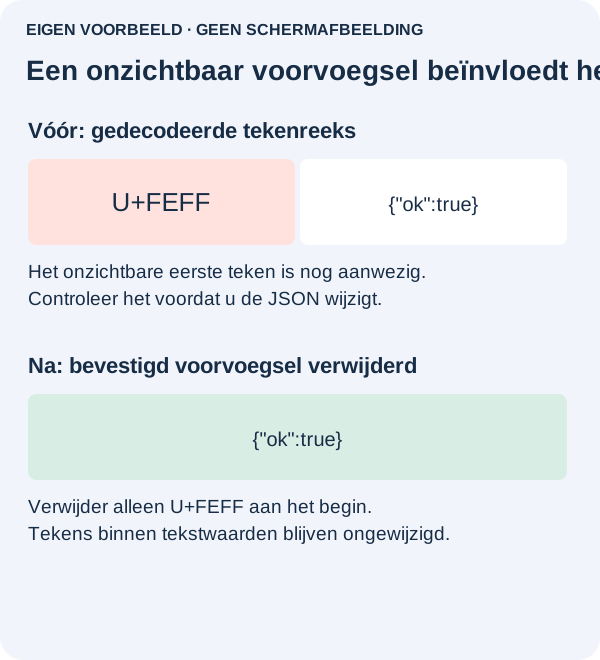
Je ziet een geldig JSON-object, maar krijgt toch een fout op positie nul. De openingsaccolade is mogelijk niet het eerste teken: ervoor kan een onzichtbare U+FEFF staan. Bewaar het origineel voordat je iets herstelt. Een HTML-inlogpagina, lege respons of verkeerd gedecodeerd bestand vraagt om een andere oplossing.
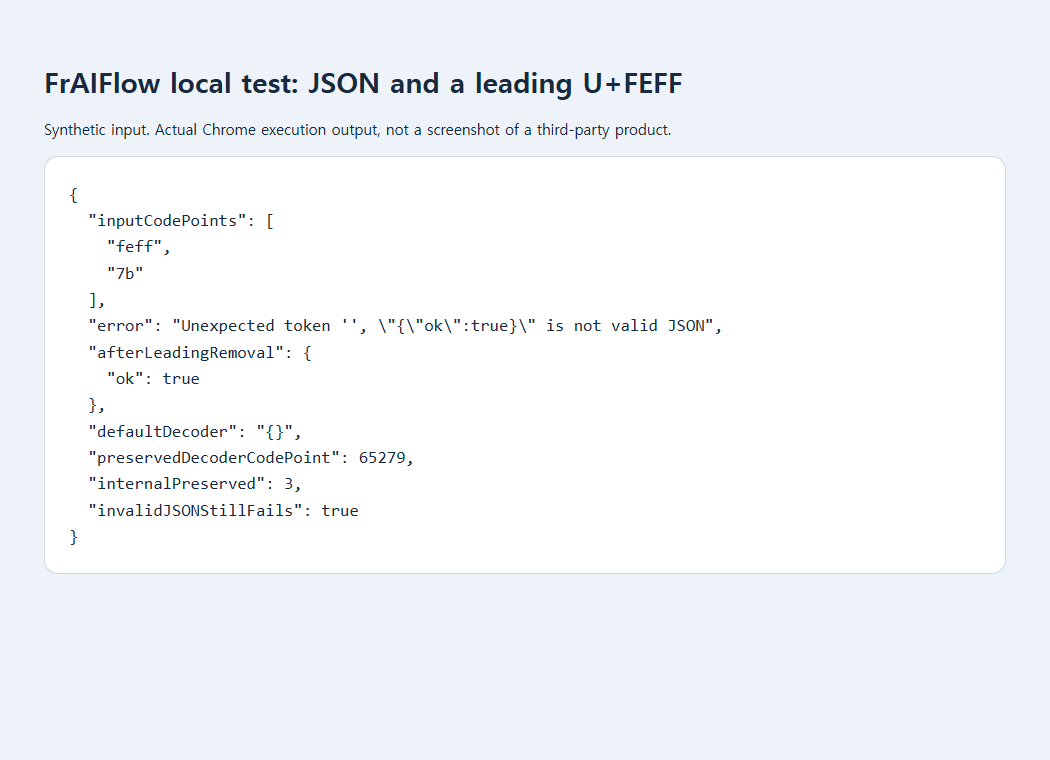
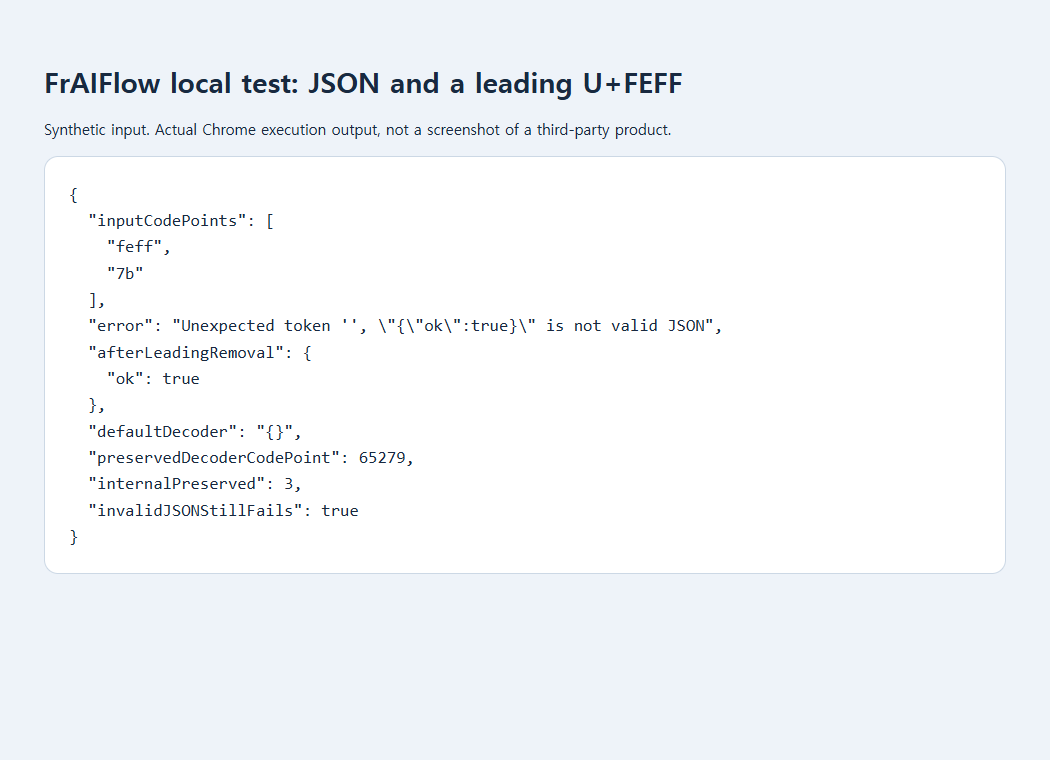
In een Stack Overflow-melding uit 2017 werd een vergelijkbare Node.js-fout herleid tot decimaal 65279, oftewel U+FEFF. Een opgeslagen lokale browsertest vormt apart bewijs: een synthetische U+FEFF gevolgd door {"ok":true} mislukte en kon vervolgens worden verwerkt nadat alleen het voorvoegsel was verwijderd. De schermafbeelding toont die lokale test, niet het bestand van de melder.
Een gerichte reparatie die je zelf kunt uitvoeren
Begin met een kopie van het bestand, niet je enige export. Komt de inhoud uit een webverzoek, controleer dan eerst de HTTP-status en het inhoudstype: een inlogpagina die begint met <!doctype html> vraagt om herstel van de authenticatie, niet om JSON-opschoning. Gebruik voor een lokaal bestand een editor die de codering kan tonen. Sla tijdens het onderzoek niet over het origineel heen op.
Heb je het bestand gedecodeerd naar een JavaScript-string met de naam text, gebruik dan de volgende kleine hulpfunctie in je eigen importscript. Die accepteert één bekende markering aan het begin en laat al het andere ongemoeid.
function parseJsonText(text) {
  if (typeof text !== "string") throw new TypeError("Expected text");
  const hadBOM = text.charCodeAt(0) === 0xFEFF;
  const cleaned = hadBOM ? text.slice(1) : text;
  return { value: JSON.parse(cleaned), removedLeadingBOM: hadBOM };
}
const sample = '\uFEFF{"ok":true,"name":"한글"}';
const result = parseJsonText(sample);
console.log(result.removedLeadingBOM); // true
console.log(result.value.ok);          // true
console.log(result.value.name);        // 한글
Een geslaagde controle is meer dan ‘de fout is weg’. Controleer of de verwachte eigenschappen bestaan en niet-Engelse tekst nog goed leesbaar is. Test de functie ook met gewone JSON: die moet worden verwerkt zonder melding dat een markering is verwijderd. Lege invoer en een ongeldig object moeten nog steeds een fout geven. Laat die fout zichtbaar voor de aanroeper in plaats van een leeg object terug te geven dat voor geldige gegevens kan worden aangezien.
Is het eerste codepunt geen U+FEFF, stop dan met deze herstelroute. Een bestand met een verkeerde decodering kan bijvoorbeeld vervangingstekens of afwisselende nultekens bevatten. Open het opnieuw met de codering die de exporterende toepassing gebruikt of vraag om een nieuwe UTF-8-export. Tekens verwijderen kan verkeerd gedecodeerde bytes niet reconstrueren.
Het verschil tussen bytes en een verborgen teken
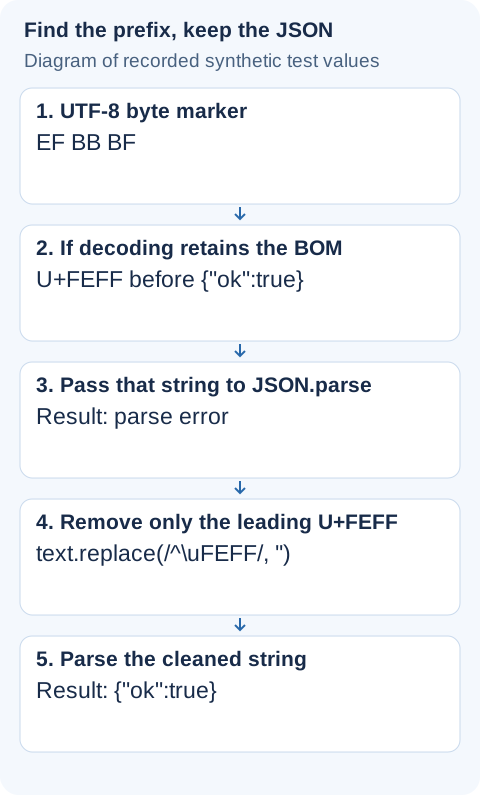
TextDecoder("utf-8") laat een UTF-8-BOM aan het begin normaal weg. De optie ignoreBOM is verwarrend: true neemt de markering juist op in de gedecodeerde string. Ons bytevoorbeeld EF BB BF 7B 7D werd met het standaardgedrag {}. Dit is geen automatische herkenning van de codering.
Controleer de bron van het bestand
Een aparte PowerShell-melding ging over een onjuiste decodeerroute. Windows PowerShell Out-File en omleiding kunnen UTF-16LE produceren; nieuwere PowerShell-versies werken anders. Niet-ASCII-tekst verwijderen kan geldige namen beschadigen zonder dat verschil op te lossen. Controleer het gebruikte commando en de versie en decodeer of exporteer daarna correct. De werkwijze van die gebruiker is niet in onze test gereproduceerd.
RFC 8259 vereist UTF-8 voor JSON-uitwisseling buiten een gesloten ecosysteem en verbiedt producenten een BOM aan netwerkgegevens toe te voegen. Herstel indien mogelijk de exporter. Test bij de importgrens gewone JSON, het bevestigde voorvoegsel, ongeldige JSON en niet-Engelse waarden. Log alleen het diagnostische voorvoegsel, niet de privé-inhoud van documenten.
Bronnen, voorbeelden en meer informatie
- Openbare discussie: JSON.parse geeft SyntaxError bij positie 0
- Oorspronkelijk verklarend diagram
- Opgeslagen bewijs van de lokale test
- MDN-naslag: ignoreBOM
- Openbare discussie: JSON.parse SyntaxError, onverwacht teken op positie 0
- Microsoft-documentatie: about_character_encoding
- RFC 8259: het JSON-formaat voor gegevensuitwisseling
- Waarom tekst die er hetzelfde uitziet toch niet overeenkomt
- Waarom btoa() vastloopt op Unicode-tekens