Miksi kelvolliselta näyttävä JSON epäonnistuu ensimmäiseen merkkiin
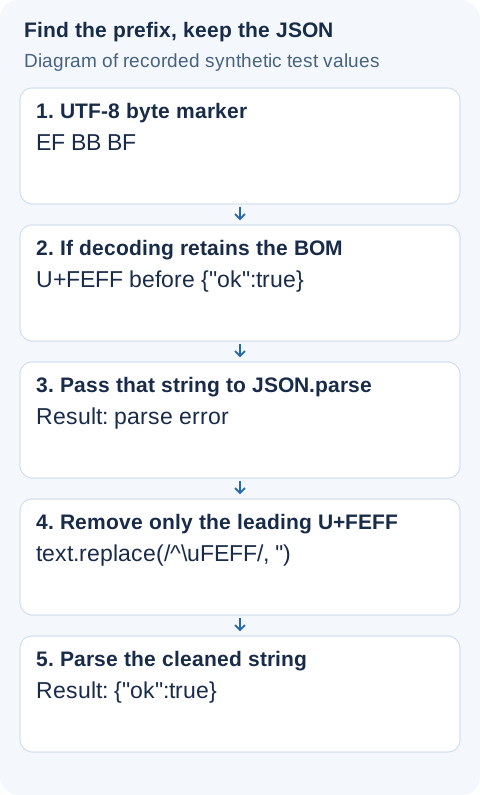
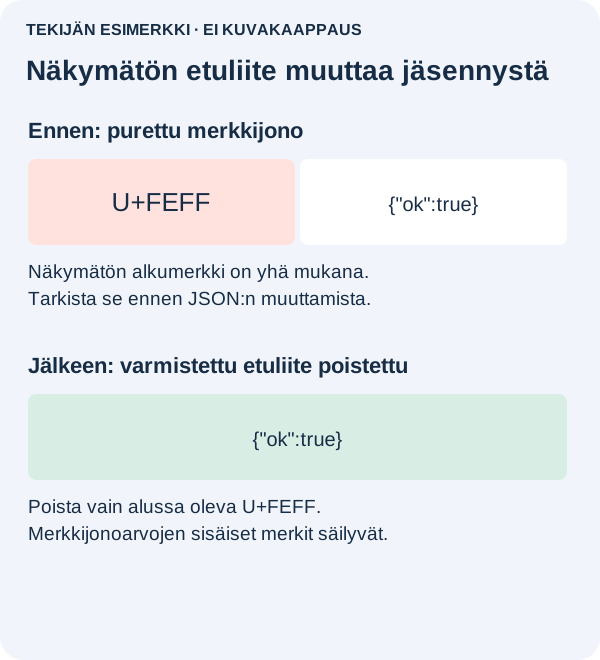
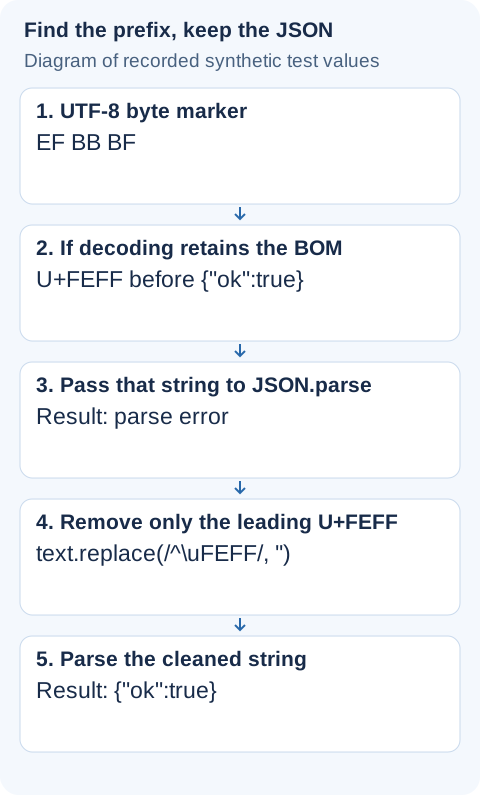
Näet kelvollisen JSON-objektin, mutta saat silti virheen kohdassa nolla. Avaava aaltosulje ei ehkä ole ensimmäinen merkki: sen edessä voi olla näkymätön U+FEFF. Säilytä alkuperäinen ennen korjaamista. HTML-kirjautumissivu, tyhjä vastaus tai väärin dekoodattu tiedosto vaatii eri ratkaisun.
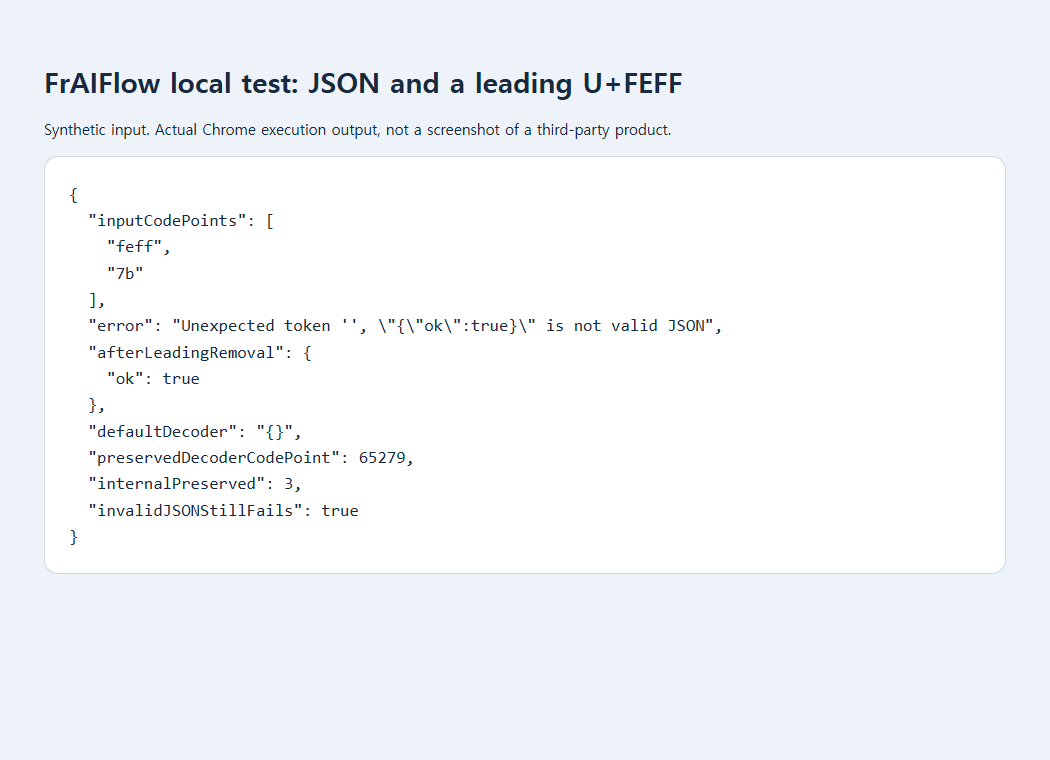
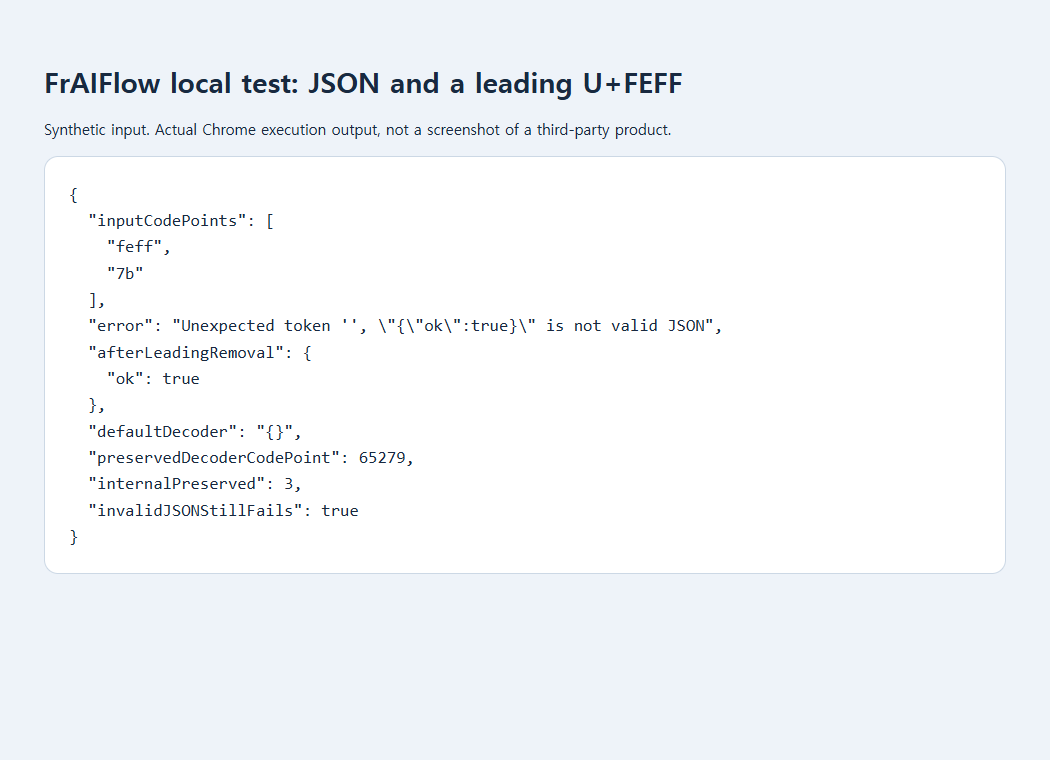
Vuoden 2017 Stack Overflow -tapauksessa vastaava Node.js-virhe jäljitettiin desimaaliarvoon 65279 eli U+FEFF:iin. Tallennettu paikallinen selaintesti on erillinen todiste: synteettinen U+FEFF, jota seurasi {"ok":true}, epäonnistui mutta jäsentyi pelkän etuliitteen poistamisen jälkeen. Kuvakaappaus tallentaa paikallistestin, ei ilmoittajan tiedostoa.
Poista vain alussa oleva BOM ja tarkista tulos
Aloita tiedoston kopiosta, älä ainoasta vientitiedostostasi. Jos aineisto tuli verkkopyynnöstä, tarkista ensin HTTP-tila ja sisältötyyppi: merkillä <!doctype html> alkava kirjautumissivu tarvitsee tunnistautumisen korjaamista, ei JSON-siivousta. Paikallista tiedostoa varten käytä editoria, joka näyttää merkistökoodauksen. Älä tallenna alkuperäisen päälle tutkinnan aikana.
Kun tiedosto on dekoodattu JavaScript-merkkijonoksi nimeltä text, käytä seuraavaa pientä apufunktiota omassa tuontiskriptissäsi. Se hyväksyy yhden tunnetun aloitusmerkin ja jättää kaiken muun ennalleen.
function parseJsonText(text) {
  if (typeof text !== "string") throw new TypeError("Expected text");
  const hadBOM = text.charCodeAt(0) === 0xFEFF;
  const cleaned = hadBOM ? text.slice(1) : text;
  return { value: JSON.parse(cleaned), removedLeadingBOM: hadBOM };
}
const sample = '\uFEFF{"ok":true,"name":"한글"}';
const result = parseJsonText(sample);
console.log(result.removedLeadingBOM); // true
console.log(result.value.ok);          // true
console.log(result.value.name);        // 한글
Onnistumisen tarkistus on enemmän kuin virheilmoituksen katoaminen. Varmista odotetut ominaisuudet ja muunkielisen tekstin oikea luettavuus. Aja apufunktio myös tavallisella JSON:lla: sen pitäisi jäsentyä ilmoittamatta poistetusta merkistä. Tyhjän syötteen tai virheellisen objektin pitää yhä aiheuttaa poikkeus. Näytä virhe kutsujalle äläkä palauta tyhjää objektia, jota voitaisiin pitää kelvollisena tietona.
Jos ensimmäinen koodipiste ei ole U+FEFF, lopeta tämä korjaustapa. Väärällä merkistökoodauksella dekoodattu tiedosto voi esimerkiksi sisältää korvausmerkkejä tai vuorottelevia nollamerkkejä. Avaa se viejän valitsemalla koodauksella tai pyydä uusi UTF-8-vienti. Merkkien poistaminen ei palauta väärin dekoodattuja tavuja.
Tavujen ja näkymättömän merkin ero
TextDecoder("utf-8") jättää tavallisesti johtavan UTF-8-BOMin pois. Sen ignoreBOM-asetus on epäintuitiivinen: true sisällyttää merkin dekoodattuun merkkijonoon. Tavuaineistomme EF BB BF 7B 7D muuttui oletusasetuksilla muotoon {}. Kyse ei ole automaattisesta merkistökoodauksen tunnistuksesta.
Tarkista tiedon tuottaja
Erillisessä PowerShell-tapauksessa ongelma oli väärä dekoodauspolku. Windows PowerShellin Out-File ja uudelleenohjaus voivat tuottaa UTF-16LE:tä; uudempi PowerShell toimii eri tavalla. Muiden kuin ASCII-merkkien poistaminen voi tuhota kelvollisia nimiä korjaamatta ristiriitaa. Tarkista tuottava komento ja versio ja dekoodaa tai vie tiedot oikein uudelleen. Käyttäjän työnkulkua ei toistettu testissämme.
RFC 8259 edellyttää UTF-8:aa suljetun ympäristön ulkopuolella vaihdettavalle JSON:lle ja kieltää tuottajaa lisäämästä verkossa BOMia. Korjaa viejä, jos mahdollista. Testaa tuontirajalla tavallinen JSON, vahvistettu etuliite, virheellinen JSON ja muunkieliset arvot. Kirjaa vain diagnostiikassa tarvittava etuliite, älä yksityisen asiakirjan sisältöä.
Lähteet, esimerkit ja lisälukeminen
- Julkinen keskustelu: JSON.parse ja SyntaxError kohdassa 0
- Alkuperäinen täydentävä kaavio
- Tallennettu paikallinen testiaineisto
- MDN: ignoreBOM
- Julkinen keskustelu: JSON.parse SyntaxError unexpected token kohdassa 0
- Microsoft: about_character_encoding
- RFC 8259: JSON-tiedonsiirtomuoto
- Miksi samalta näyttävät tekstit eivät täsmää
- Miksi Base64 rikkoo muunkielisen tekstin