Warum scheinbar gültiges JSON schon am ersten Zeichen scheitert
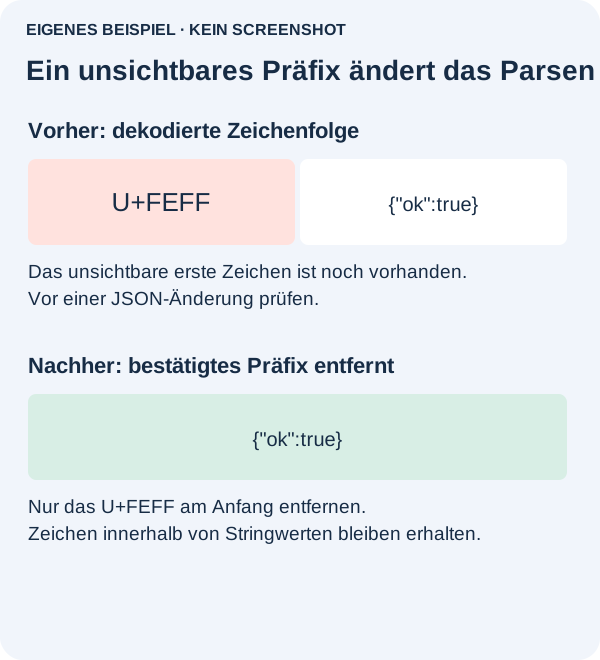
Sie sehen ein gültiges JSON-Objekt, erhalten aber trotzdem einen Fehler an Position null. Möglicherweise ist die öffnende Klammer gar nicht das erste Zeichen: Davor kann ein unsichtbares U+FEFF stehen. Bewahren Sie das Original auf, bevor Sie einen Reparaturversuch unternehmen. Eine HTML-Anmeldeseite, eine leere Antwort oder eine falsch dekodierte Datei erfordert eine andere Lösung.
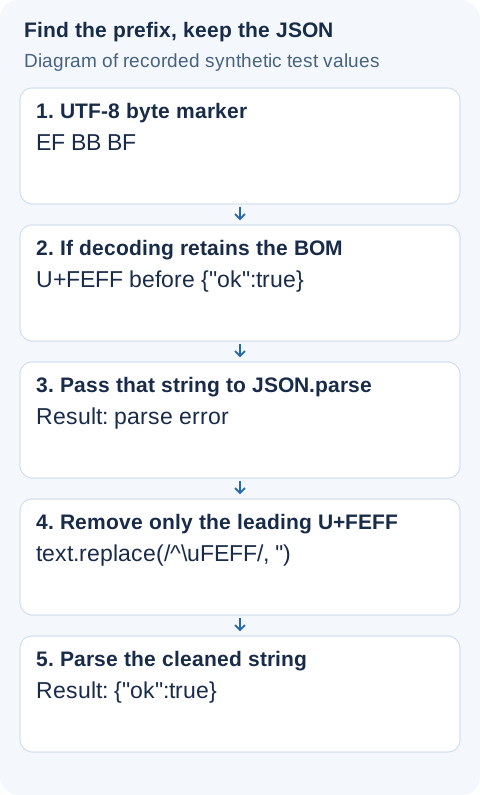
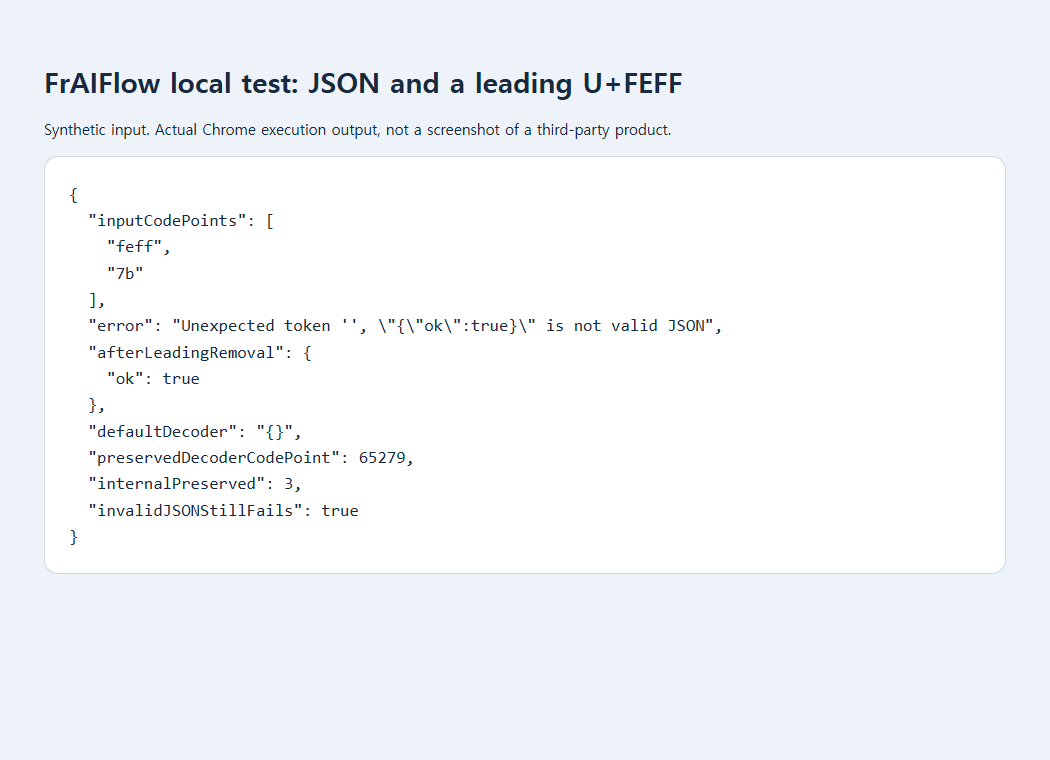
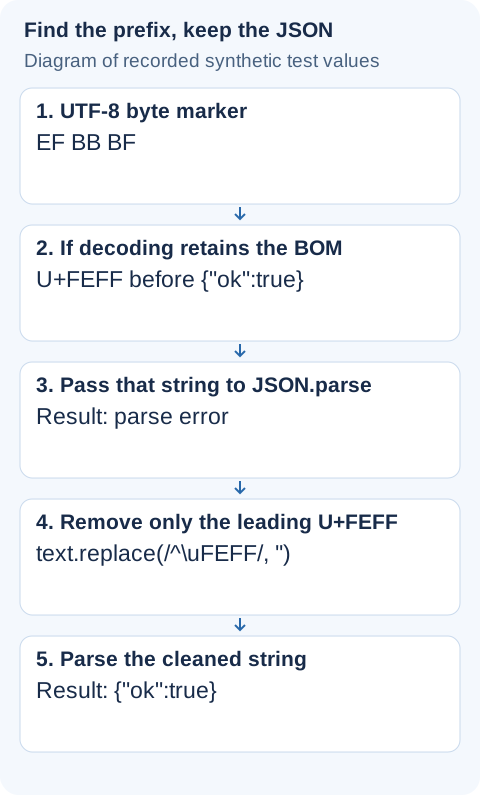
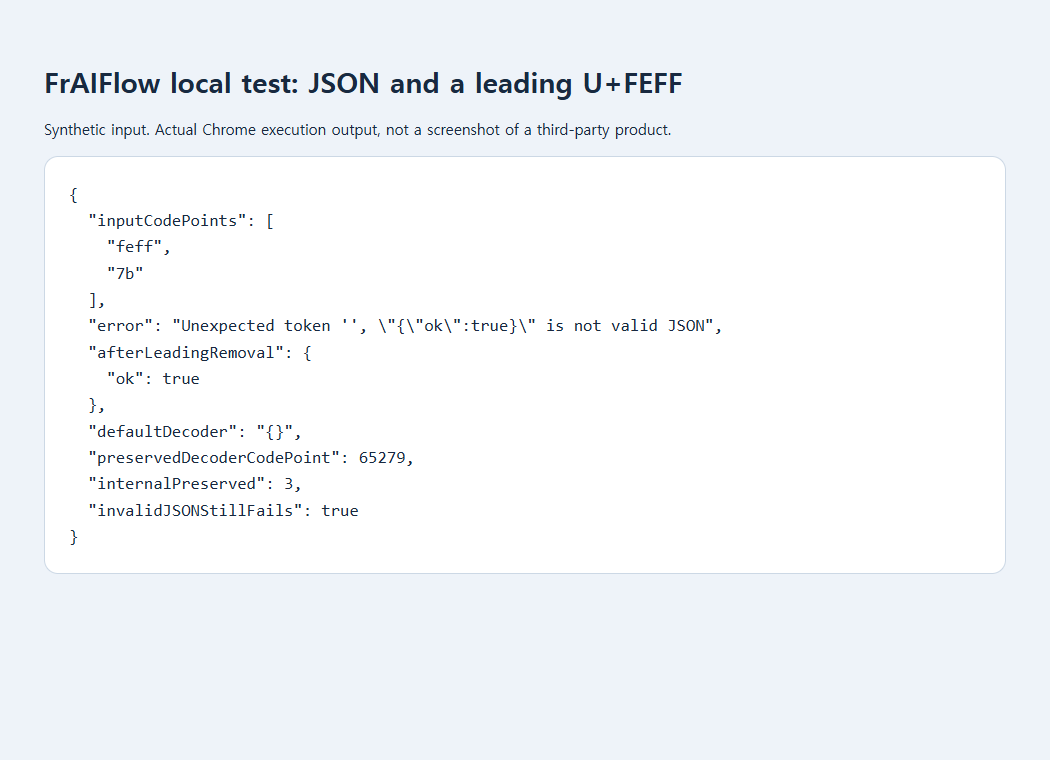
Ein Stack-Overflow-Beitrag von 2017 führte einen ähnlichen Node.js-Fehler auf den Dezimalwert 65279, also U+FEFF, zurück. Ein gespeicherter lokaler Browsertest liefert einen davon unabhängigen Nachweis: Ein künstlich vorangestelltes U+FEFF vor {"ok":true} verursachte einen Fehler. Nach dem Entfernen ausschließlich dieses Präfixes ließ sich der Text einlesen. Der Screenshot zeigt diesen lokalen Test, nicht die Datei aus dem öffentlichen Beitrag.
Eine gezielte Reparatur, die Sie selbst ausführen können
Arbeiten Sie mit einer Kopie, nicht mit Ihrem einzigen Export. Stammt die Datei aus einer Webanfrage, prüfen Sie zuerst HTTP-Status und Inhaltstyp: Eine Anmeldeseite, die mit <!doctype html> beginnt, benötigt eine Korrektur der Anmeldung, keine JSON-Bereinigung. Bei einer lokalen Datei verwenden Sie einen Editor, der die Zeichenkodierung anzeigen kann. Überschreiben Sie das Original während der Untersuchung nicht.
Wenn Sie die Datei in eine JavaScript-Zeichenfolge namens text dekodiert haben, können Sie die folgende kleine Hilfsfunktion in Ihrem Importskript verwenden. Sie berücksichtigt genau eine bekannte führende Markierung und lässt alles andere unverändert.
function parseJsonText(text) {
  if (typeof text !== "string") throw new TypeError("Expected text");
  const hadBOM = text.charCodeAt(0) === 0xFEFF;
  const cleaned = hadBOM ? text.slice(1) : text;
  return { value: JSON.parse(cleaned), removedLeadingBOM: hadBOM };
}
const sample = '\uFEFF{"ok":true,"name":"한글"}';
const result = parseJsonText(sample);
console.log(result.removedLeadingBOM); // true
console.log(result.value.ok);          // true
console.log(result.value.name);        // 한글
Zur Erfolgskontrolle gehört mehr als „Die Fehlermeldung ist verschwunden“. Prüfen Sie, ob die erwarteten Eigenschaften vorhanden sind und nicht englische Texte weiterhin korrekt lesbar sind. Testen Sie die Funktion auch mit gewöhnlichem JSON: Dieses sollte sich einlesen lassen, ohne dass eine entfernte Markierung gemeldet wird. Eine leere Eingabe oder ein fehlerhaftes Objekt muss weiterhin einen Fehler auslösen. Geben Sie diesen an den Aufrufer weiter, statt ein leeres Objekt zurückzugeben, das fälschlich als gültige Daten verstanden werden könnte.
Ist der erste Codepunkt nicht U+FEFF, verfolgen Sie diesen Reparaturweg nicht weiter. Eine mit falscher Kodierung gelesene Datei kann beispielsweise Ersatzzeichen oder abwechselnde Nullzeichen enthalten. Öffnen Sie sie mit der vom Exportprogramm verwendeten Kodierung erneut oder fordern Sie einen neuen UTF-8-Export an. Durch das Entfernen von Zeichen lassen sich falsch dekodierte Bytes nicht rekonstruieren.
Der Unterschied zwischen Bytes und einem unsichtbaren Zeichen
TextDecoder("utf-8") lässt eine führende UTF-8-BOM normalerweise weg. Die Option ignoreBOM ist dabei wenig intuitiv: true nimmt die Markierung in die dekodierte Zeichenfolge auf. Unsere Byte-Testdaten EF BB BF 7B 7D wurden mit dem Standardverhalten zu {}. Das ist keine automatische Erkennung der Zeichenkodierung.
Prüfen Sie auch das erzeugende Programm
In einem anderen PowerShell-Bericht lag das Problem am falschen Dekodierungsweg. Out-File und Ausgabeumleitungen in Windows PowerShell können UTF-16LE erzeugen; neuere PowerShell-Versionen verhalten sich anders. Das Entfernen aller Nicht-ASCII-Zeichen kann gültige Namen zerstören, ohne diesen Widerspruch zu beheben. Prüfen Sie den verwendeten Befehl und die Version und dekodieren oder exportieren Sie anschließend korrekt. Der Ablauf aus diesem Nutzerbericht wurde in unserem Test nicht nachgestellt.
RFC 8259 verlangt für JSON außerhalb geschlossener Systeme UTF-8 und untersagt Erzeugern, einer Netzwerkübertragung eine BOM voranzustellen. Korrigieren Sie nach Möglichkeit den Export. Prüfen Sie am Importübergang gewöhnliches JSON, das bestätigte Präfix, fehlerhaftes JSON und nicht englische Werte. Protokollieren Sie nur das diagnostisch relevante Präfix, keine privaten Dokumentinhalte.
Quellen, Beispiele und weiterführende Informationen
- Öffentliche Diskussion: JSON.parse verursacht einen SyntaxError an Position 0
- Ursprüngliche ergänzende Darstellung
- Gespeicherter Nachweis des lokalen Tests
- MDN-Referenz: ignoreBOM
- Öffentliche Diskussion: unerwartetes Token in JSON an Position 0
- Microsoft-Dokumentation: about_character_encoding
- RFC 8259: das JSON-Datenaustauschformat
- Warum gleich aussehende Texte nicht übereinstimmen
- Warum btoa() bei Unicode-Zeichen scheitert