Hvorfor tilsyneladende gyldig JSON fejler ved første tegn
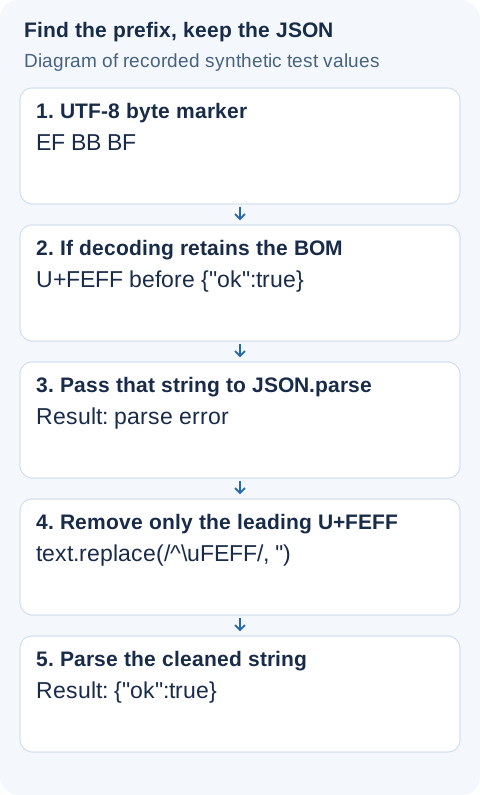
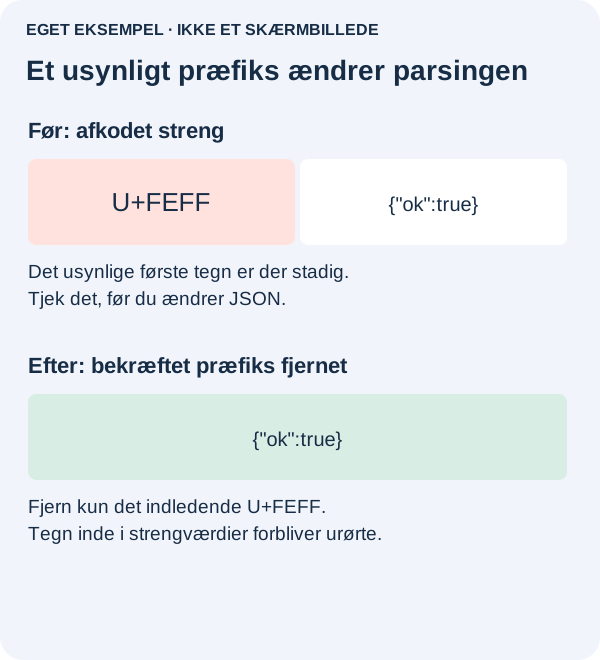
Du kan se et gyldigt JSON-objekt og alligevel få en fejl på position nul. Den indledende krøllede parentes er måske ikke første tegn: Et usynligt U+FEFF kan stå før den. Behold originalen, før du forsøger en reparation. En HTML-loginside, et tomt svar eller en forkert afkodet fil kræver en anden løsning.
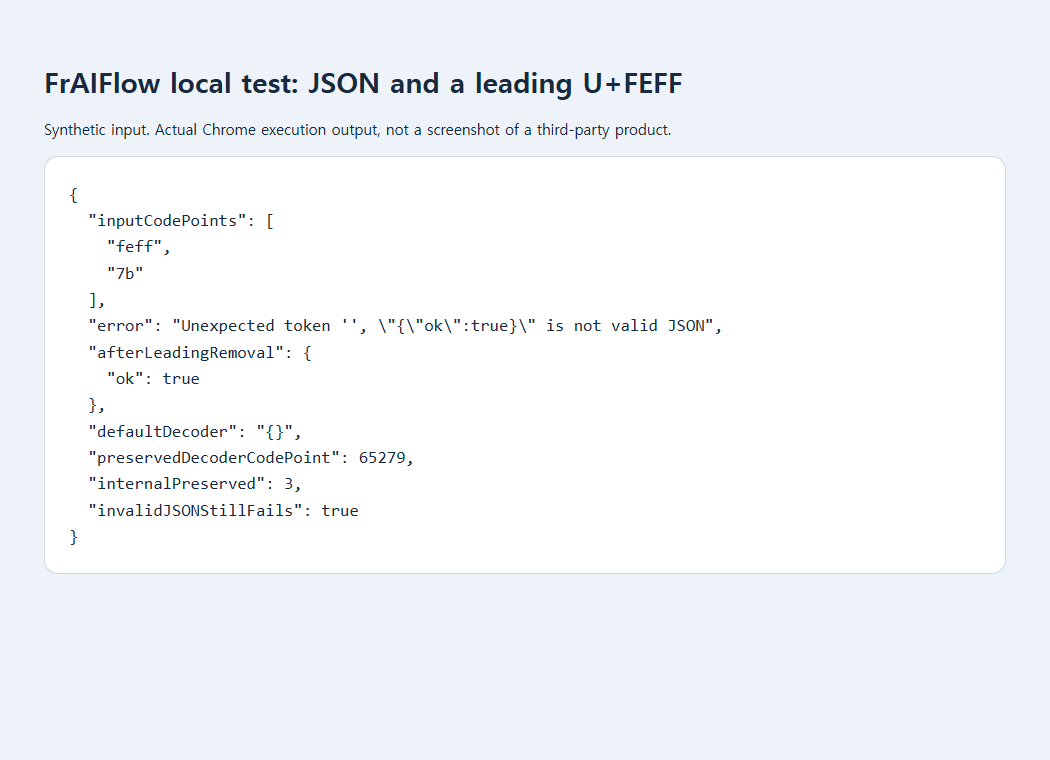
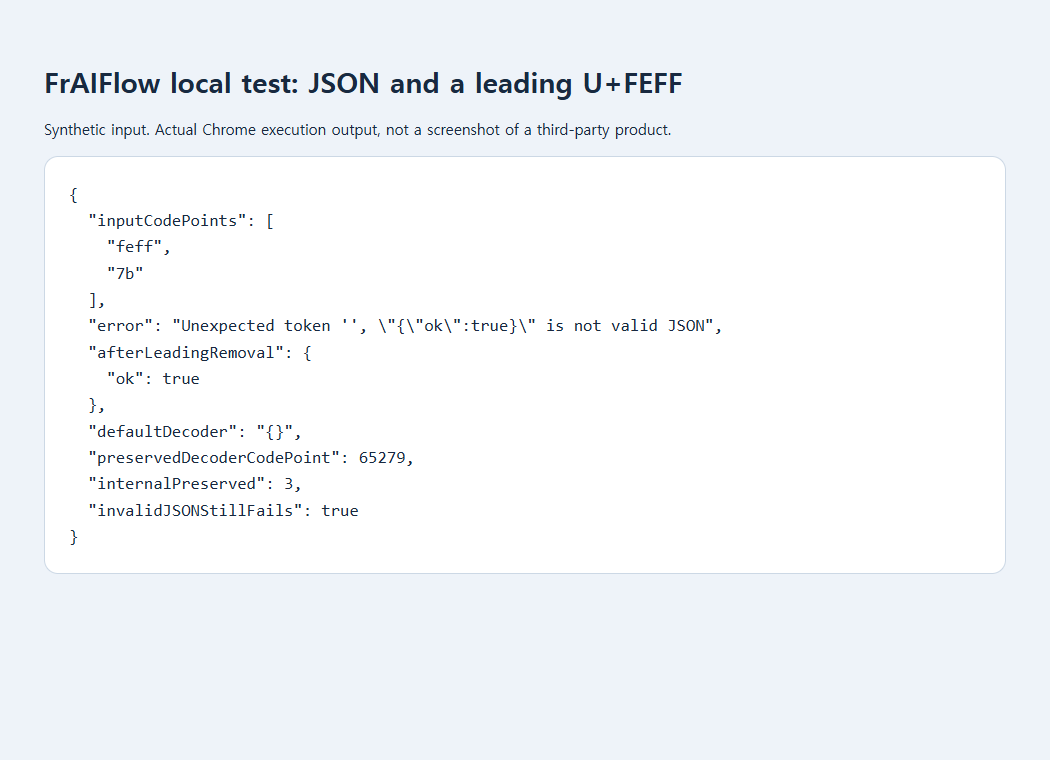
En Stack Overflow-rapport fra 2017 sporede en lignende Node.js-fejl til decimaltallet 65279, altså U+FEFF. En gemt lokal browsertest er særskilt dokumentation: Et syntetisk U+FEFF efterfulgt af {"ok":true} fejlede, men kunne parses, efter at kun præfikset var fjernet. Skærmbilledet viser denne lokale test, ikke fejlrapportørens fil.
En sikker rettelse, du faktisk kan køre
Begynd med en kopi af filen, ikke din eneste eksport. Hvis den kom fra en webanmodning, skal du først kontrollere HTTP-status og indholdstype: En loginside, der starter med <!doctype html>, kræver en rettelse af godkendelsen, ikke JSON-oprydning. Ved en lokal fil skal du bruge en editor, der kan vise tegnkodningen. Gem ikke oven i originalen under undersøgelsen.
Når du har afkodet filen til en JavaScript-streng kaldet text, kan du bruge denne lille hjælpefunktion i dit eget importscript. Den accepterer én kendt indledende markør og lader alt andet være.
function parseJsonText(text) {
  if (typeof text !== "string") throw new TypeError("Expected text");
  const hadBOM = text.charCodeAt(0) === 0xFEFF;
  const cleaned = hadBOM ? text.slice(1) : text;
  return { value: JSON.parse(cleaned), removedLeadingBOM: hadBOM };
}
const sample = '\uFEFF{"ok":true,"name":"한글"}';
const result = parseJsonText(sample);
console.log(result.removedLeadingBOM); // true
console.log(result.value.ok);          // true
console.log(result.value.name);        // 한글
Kontrollen af succes er mere end “fejlen forsvandt”. Bekræft, at de forventede egenskaber findes, og at ikke-engelsk tekst stadig er læsbar. Kør også hjælpefunktionen på almindelig JSON: Den bør parse uden at melde om en fjernet markør. Et tomt input eller et fejlformet objekt skal stadig udløse en fejl. Lad den fejl være synlig for kalderen frem for at returnere et tomt objekt, som kan forveksles med gyldige data.
Hvis første kodepunkt ikke er U+FEFF, skal du stoppe denne reparationsmetode. En fil afkodet med forkert tegnkodning kan f.eks. indeholde erstatningstegn eller skiftende nultegn. Åbn den igen med eksportørens valgte kodning, eller bed om en ny UTF-8-eksport. Fjernelse af tegn kan ikke genskabe bytes, som blev afkodet forkert.
Forskellen mellem bytes og et skjult tegn
TextDecoder("utf-8") udelader normalt en indledende UTF-8-BOM. Indstillingen ignoreBOM er kontraintuitiv: true medtager markøren i den afkodede streng. Vores bytetest EF BB BF 7B 7D blev til {} med standardadfærden. Dette er ikke automatisk genkendelse af tegnkodning.
Kontrollér det program, der fremstillede filen
En særskilt PowerShell-rapport handlede om en forkert afkodningsvej. Windows PowerShell Out-File og omdirigering kan fremstille UTF-16LE; nyere PowerShell-versioner opfører sig anderledes. Fjernelse af ikke-ASCII-tekst kan ødelægge gyldige navne uden at rette uoverensstemmelsen. Kontrollér den anvendte kommando og version, og afkod eller geneksportér derefter korrekt. Den brugers arbejdsgang blev ikke genskabt i vores test.
RFC 8259 kræver UTF-8 for JSON, der udveksles uden for et lukket økosystem, og forbyder afsendere at tilføje en BOM ved netværksoverførsel. Ret eksportøren om muligt. Ved importgrænsen skal du teste almindelig JSON, det bekræftede præfiks, fejlformet JSON og ikke-engelske værdier. Log kun det diagnostiske præfiks, ikke privat dokumentindhold.
Kilder, eksempler og videre læsning
- Offentlig diskussion: JSON.parse giver SyntaxError, unexpected token på position 0
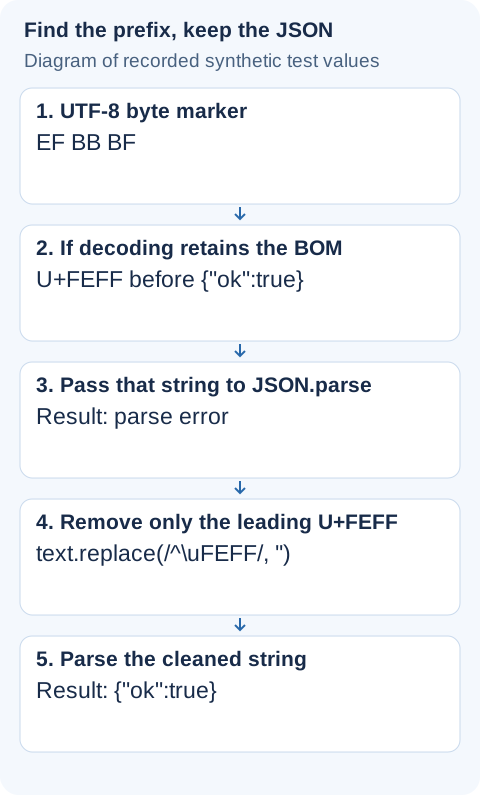
- Oprindeligt supplerende diagram
- Gemt dokumentation fra lokal test
- MDN-reference: ignoreBOM
- Offentlig diskussion: JSON.parse SyntaxError, unexpected token på position 0
- Microsoft-dokumentation: about_character_encoding
- RFC 8259: JSON-formatet til dataudveksling
- Hvorfor tekst, der ser ens ud, ikke matcher
- Hvorfor Base64 giver problemer med ikke-engelsk tekst