Hvorfor Base64 giver problemer med ikke-engelsk tekst
Hvis btoa() håndterer Hello, men fejler med koreansk tekst eller emoji, mangler der typisk et trin til tekstkodning. Base64 repræsenterer bytes. En JavaScript-streng skal først omdannes til bytes efter en aftalt metode, og modtagerprogrammet skal udføre den omvendte omdannelse.
En offentlig fejlrapport handlede om SVG-kode med ikke-latinske tegn; en anden afkodede indhold fra GitHub API, men fik et ødelagt varemærkesymbol. I det første tilfælde opstår fejlen ved kodning, i det andet ved afkodning. Et vellykket atob()-kald returnerer en binær streng, ikke automatisk læsbar UTF-8-tekst.
Brug en fuldstændig UTF-8-kodning og -afkodning
Hvis du vedligeholder koden, der fremstiller Base64, skal du rette overgangen fra tekst til binære data i stedet for at fjerne de tegn, der udløser fejlen. Disse JavaScript-hjælpefunktioner til browseren gør overgangen udtrykkelig. De er beregnet til forholdsvis små tekstmængder, ikke store uploads.
function encodeUtf8Base64(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
function decodeUtf8Base64(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, c => c.charCodeAt(0));
  return new TextDecoder("utf-8", {
    fatal: true, ignoreBOM: true
  }).decode(bytes);
}
const original = "Hello, 한글 ™ 🌍";
const encoded = encodeUtf8Base64(original);
const restored = decodeUtf8Base64(encoded);
console.log(encoded); // SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==
console.log(restored === original); // true
Placér hjælpefunktionerne ved din eksisterende konverteringskode, og prøv eksemplet, før du indsætter rigtigt indhold. Sammenligningen skal give true. Hvis den giver false, skal du sammenligne strengene før kodning og efter afkodning. Vurder ikke kun resultatet ud fra, om det “ligner Base64”. Medtag et bogstav med accent, en emoji og en tom streng i testene.
Hvis du kun modtager data, skal du spørge, hvilke bytes afsenderen kodede. Base64-alfabetet fortæller ikke, om indholdet er UTF-8. Hvis Base64-afkodningen lykkes, men UTF-8-afkodningen fejler, kan indholdet bruge en anden tegnkodning eller være en fil, som ikke er tekst. Ved PNG eller PDF skal de afkodede bytes bevares som binære data i stedet for at blive sendt gennem en tekstdekoder.
I et værktøj til slutbrugere bør du fange fejl ved ugyldige input og lade det oprindelige input blive stående, så brugeren kan rette det. Erstat ikke en mislykket afkodning med et tomt resultat, der vises som en succes. Indsæt aldrig private tokens i en ukendt onlinekonverter: Base64 gør indhold let at overføre, ikke hemmeligt.
Derfor overser test med kun ASCII problemet
To dekoderindstillinger fortjener særlig opmærksomhed: fatal: true afviser ugyldig UTF-8 i stedet for ubemærket at indsætte erstatningstegn; ignoreBOM: true bevarer en indledende tekstmarkør. Et uparret UTF-16-surrogat erstattes af TextEncoder, så omdannelsen er ikke tabsfri for enhver tænkelig JavaScript-streng.
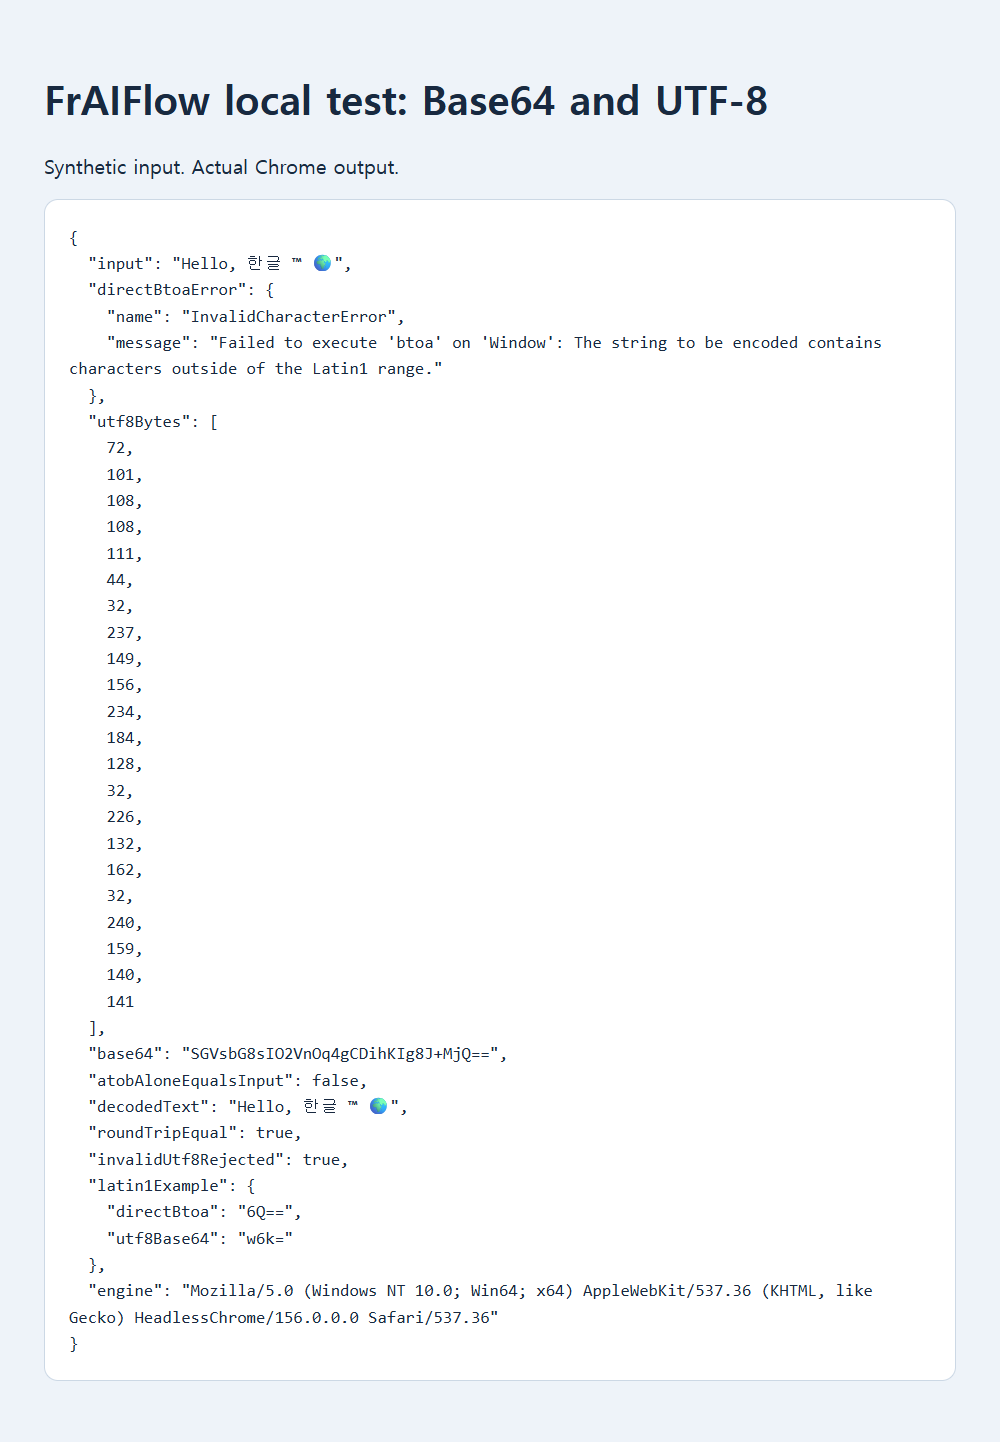
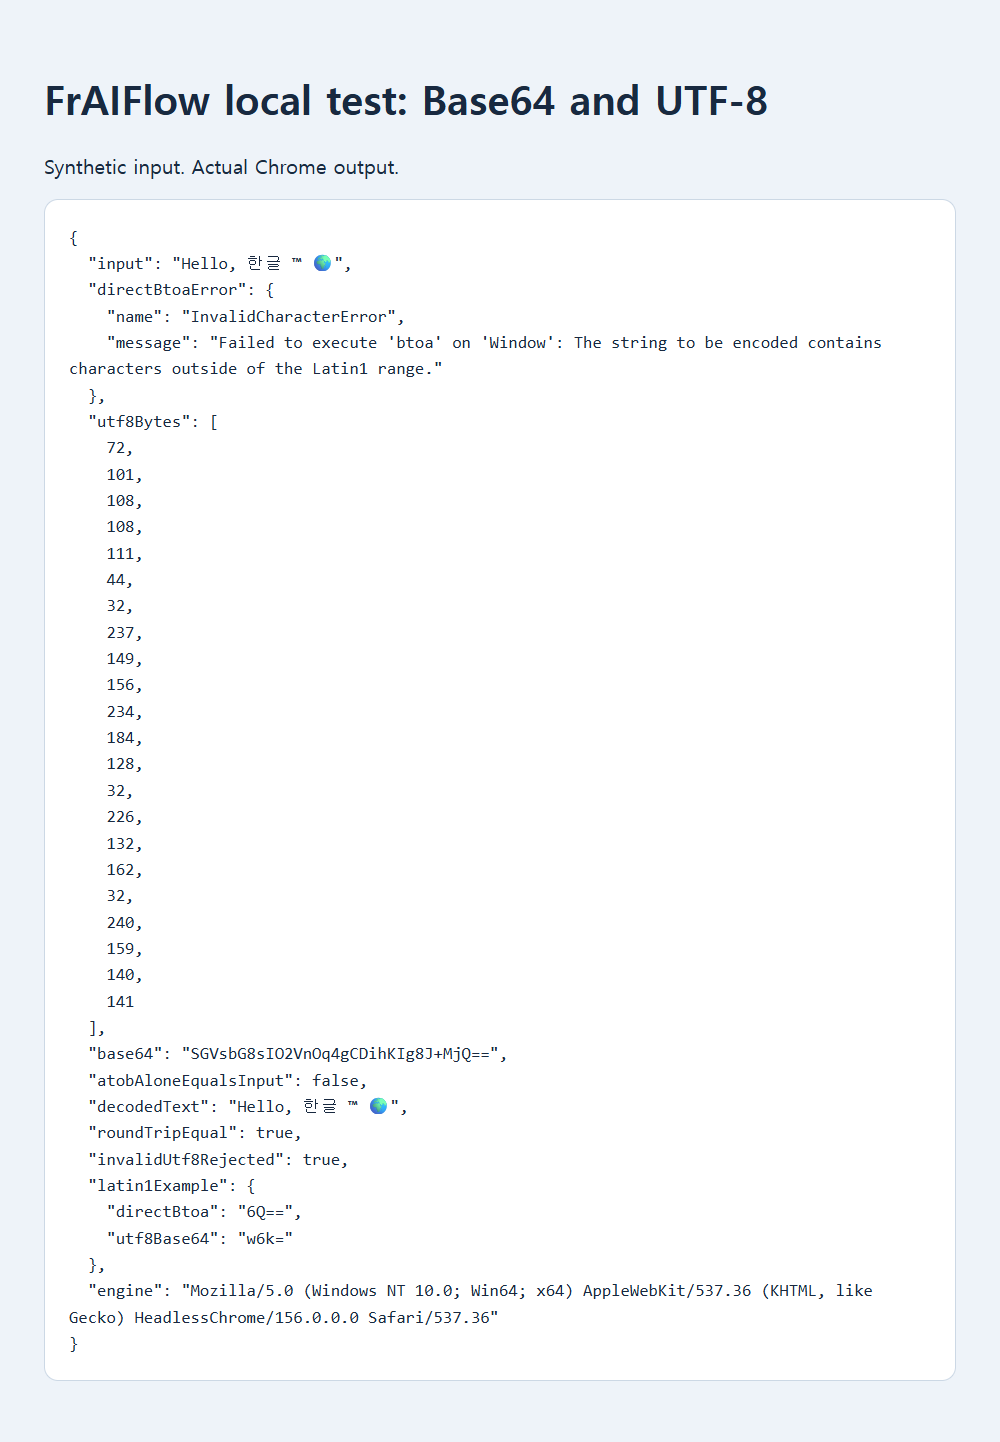
En gemt lokal browsertest brugte Hello, 한글 ™ 🌍. Direkte brug af btoa() udløste InvalidCharacterError. TextEncoder fremstillede 22 UTF-8-bytes, som blev kodet til SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==. Afkodning af disse bytes som UTF-8 genskabte præcis den oprindelige sætning. Dette er en syntetisk lokal test, ikke nogen af fejlrapportørernes programmer.
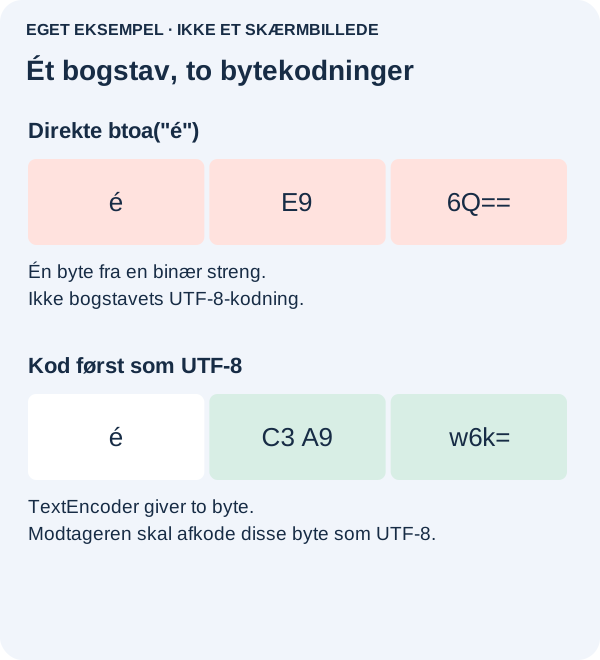
Test med kun ASCII kan skjule en fejl. I eksemplet returnerede btoa("é") værdien 6Q==, mens forudgående UTF-8-kodning gav w6k=. Det første kald udløste ikke en fejl, men dets bytes er forkerte for en modtager, som forventer UTF-8. Base64 indeholder ikke selv en erklæring om tegnkodning.
Afkod, og kontrollér hele forløbet
Base64 er hverken kryptering eller URL-escaping. Et plustegn kan have særlig betydning i query-parametre; se den tilknyttede vejledning. Undgå den forældede omvej med unescape, sæt praktiske størrelsesgrænser, og offentliggør aldrig privat indhold blot for at demonstrere en kodningsfejl.
Kilder, eksempler og videre læsning
- Offentlig diskussion: Base64-kodning fejler med ikke-latinske tegn
- Offentlig diskussion: JavaScripts atob afkoder ikke UTF-8-strenge korrekt fra Base64
- MDN-reference: btoa
- Oprindeligt supplerende diagram
- Gemt dokumentation fra lokal test
- MDN-reference: TextEncoder
- MDN-reference: atob
- MDN-reference: TextDecoder
- MDN-reference: ignoreBOM
- MDN-reference: decode
- MDN-reference: unescape
- Relateret vejledning: Base64 i query-parametre
- Hvorfor tilsyneladende gyldig JSON fejler ved første tegn
- Hvorfor tekst, der ser ens ud, ikke matcher