Pourquoi Base64 pose problème avec les textes non anglais
Si btoa() accepte Hello mais échoue avec du coréen ou un emoji, il manque généralement une étape : l’encodage du texte. Base64 représente des octets. Il faut d’abord convenir d’une façon de convertir la chaîne JavaScript en octets, puis effectuer l’opération inverse dans l’application qui les reçoit.
Un signalement public portait sur du code SVG contenant des caractères non latins ; dans un autre, le décodage d’un contenu de l’API GitHub déformait le symbole de marque commerciale. Ces deux problèmes se situent de part et d’autre de la même frontière. Un appel à atob() qui réussit renvoie une chaîne binaire, pas automatiquement du texte UTF-8 lisible.
Effectuez un aller-retour UTF-8 complet
Si vous maintenez le code qui produit le Base64, corrigez la conversion du texte en données binaires plutôt que de supprimer les caractères qui déclenchent l’erreur. Les fonctions JavaScript pour navigateur ci-dessous rendent cette conversion explicite. Elles conviennent à des textes de taille raisonnable, pas à de gros téléversements.
function encodeUtf8Base64(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
function decodeUtf8Base64(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, c => c.charCodeAt(0));
  return new TextDecoder("utf-8", {
    fatal: true, ignoreBOM: true
  }).decode(bytes);
}
const original = "Hello, 한글 ™ 🌍";
const encoded = encodeUtf8Base64(original);
const restored = decodeUtf8Base64(encoded);
console.log(encoded); // SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==
console.log(restored === original); // true
Placez ces fonctions près de votre code de conversion, puis essayez l’exemple avant d’y substituer un vrai contenu. Le test d’égalité doit renvoyer true. Sinon, comparez la chaîne avant encodage et après décodage : le simple fait que le résultat « ressemble à du Base64 » ne prouve rien. Ajoutez une lettre accentuée, un emoji et une chaîne vide aux cas de test.
Si vous recevez seulement les données, demandez quels octets l’expéditeur a encodés. L’alphabet Base64 ne permet pas de savoir si le texte était en UTF-8. Un décodage Base64 réussi suivi d’une erreur UTF-8 peut signaler un autre encodage de caractères, ou un fichier qui n’est pas du texte. Pour un PNG ou un PDF, conservez les octets décodés sous forme binaire au lieu de leur appliquer un décodeur de texte.
Dans un outil destiné aux utilisateurs, interceptez les erreurs de saisie et laissez le contenu d’origine disponible pour correction. Ne présentez pas un résultat vide comme un décodage réussi. Ne collez jamais de jetons privés dans un convertisseur en ligne inconnu : Base64 rend un contenu transportable, pas secret.
Pourquoi des essais limités à l’ASCII masquent le problème
Deux options du décodeur méritent votre attention : fatal: true rejette les séquences UTF-8 invalides au lieu d’insérer silencieusement des caractères de remplacement ; ignoreBOM: true préserve un marqueur placé au début du texte. TextEncoder remplace une unité UTF-16 qui devrait appartenir à une paire mais apparaît seule (surrogate isolé) : cette méthode ne garantit donc pas un aller-retour sans perte pour toutes les chaînes JavaScript possibles.
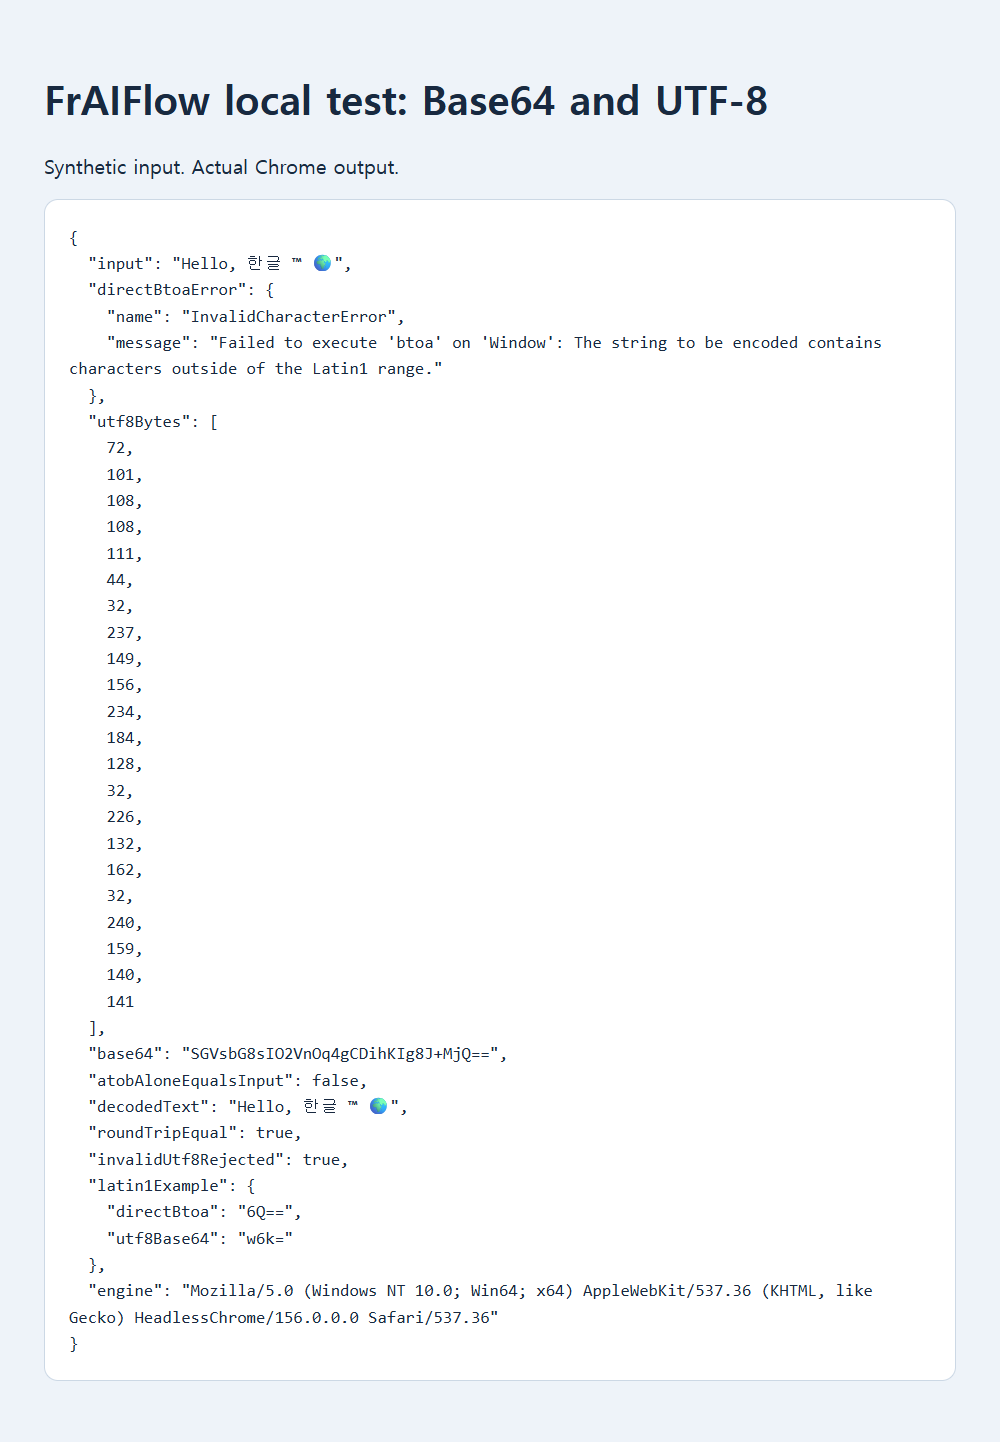
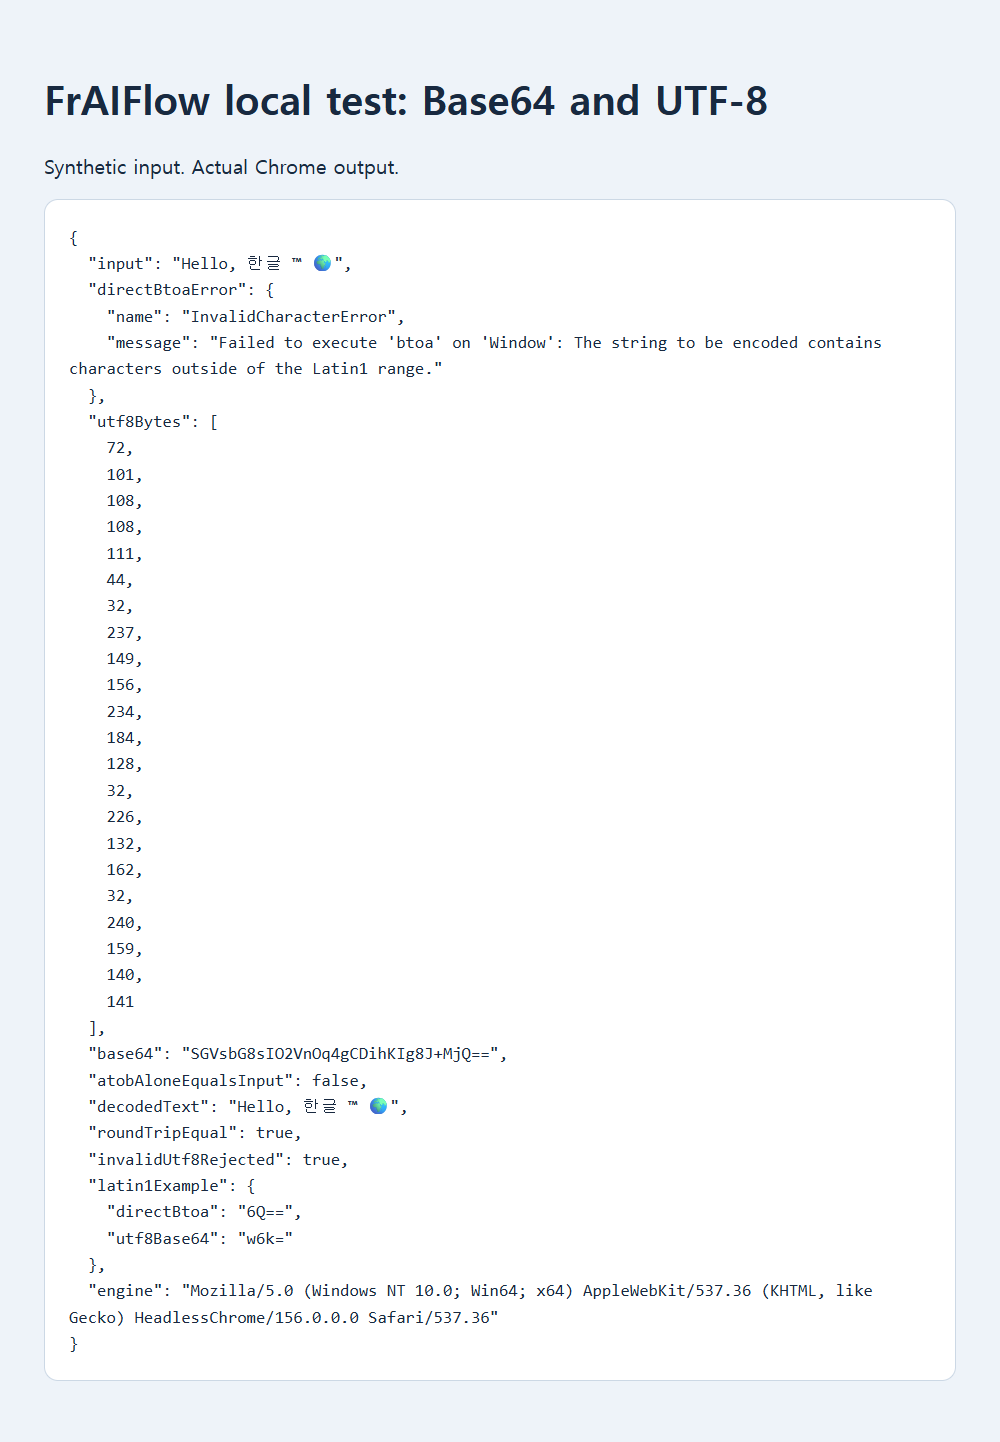
Un essai local conservé, effectué dans un navigateur, utilisait Hello, 한글 ™ 🌍. L’appel direct à btoa() a levé InvalidCharacterError. TextEncoder a produit 22 octets UTF-8, encodés en SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==. Le décodage de ces octets en UTF-8 a restitué exactement la phrase. Il s’agit d’un test local synthétique, pas de l’application de l’un des auteurs des signalements.
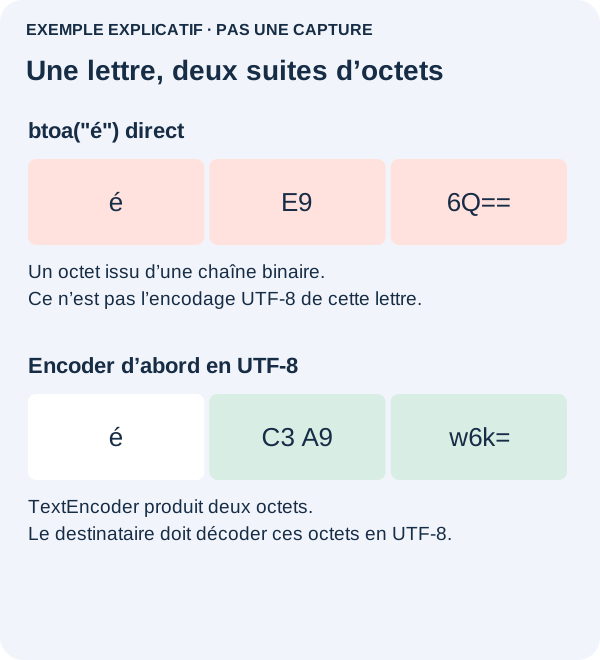
Des essais limités à l’ASCII peuvent cacher un défaut. Dans l’exemple, btoa("é") a renvoyé 6Q==, alors qu’un encodage UTF-8 préalable a donné w6k=. Le premier appel n’a pas levé d’erreur, mais ses octets ne conviennent pas à un destinataire qui attend de l’UTF-8. Base64 ne transporte aucune déclaration d’encodage de caractères.
Décodez, puis vérifiez l’aller-retour
Base64 n’est ni un chiffrement ni un échappement d’URL. Le signe plus peut être interprété de façon particulière dans les paramètres d’une URL ; consultez le guide associé. Évitez l’ancienne solution fondée sur unescape, désormais déconseillée, fixez des limites de taille réalistes et n’exposez jamais de contenu privé pour illustrer une erreur d’encodage.
Sources, exemples et lectures complémentaires
- Discussion publique : échec de l’encodage Base64 avec des caractères non latins
- Discussion publique : atob ne décode pas correctement des chaînes UTF-8
- Référence MDN : btoa
- Schéma explicatif d’origine
- Preuve conservée du test local
- Référence MDN : TextEncoder
- Référence MDN : atob
- Référence MDN : TextDecoder
- Référence MDN : ignoreBOM
- Référence MDN : decode
- Référence MDN : unescape
- Guide associé : Base64 dans un paramètre d’URL
- Pourquoi un JSON apparemment valide échoue dès le premier caractère
- Pourquoi deux textes visuellement identiques ne correspondent pas