Miksi Base64 rikkoo muunkielisen tekstin
Jos btoa() käsittelee sanan Hello mutta epäonnistuu koreankielisen tekstin tai emojin kohdalla, välistä puuttuu yleensä tekstin koodaus. Base64 esittää tavuja. JavaScript-merkkijono on ensin muunnettava tavuiksi sovitulla tavalla, ja vastaanottavan sovelluksen on tehtävä käänteinen muunnos.
Yhdessä julkisessa tapauksessa SVG-merkintäkieli sisälsi muita kuin latinalaisia merkkejä. Toisessa GitHub API:n sisällön purkaminen sotki tavaramerkkimerkin. Ongelmat ovat saman muunnosrajan eri päissä. Onnistunut atob()-kutsu palauttaa binäärimerkkijonon, ei automaattisesti luettavaa UTF-8-tekstiä.
Käytä täydellistä UTF-8-edestakaismuunnosta
Jos ylläpidät Base64:n muodostavaa koodia, korjaa tekstin ja binääritavujen välinen muunnos sen sijaan, että poistaisit virheen aiheuttavat merkit. Nämä selaimen JavaScript-apufunktiot tekevät muunnoksen selvästi näkyväksi. Ne on tarkoitettu kohtuullisen pienille tekstimäärille, eivät suurille tiedostolatauksille.
function encodeUtf8Base64(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
function decodeUtf8Base64(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, c => c.charCodeAt(0));
  return new TextDecoder("utf-8", {
    fatal: true, ignoreBOM: true
  }).decode(bytes);
}
const original = "Hello, 한글 ™ 🌍";
const encoded = encodeUtf8Base64(original);
const restored = decodeUtf8Base64(encoded);
console.log(encoded); // SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==
console.log(restored === original); // true
Lisää apufunktiot nykyisen muunnoskoodisi yhteyteen ja kokeile esimerkkiä ennen oikean sisällön käyttöä. Yhtäsuuruustarkistuksen tuloksen pitäisi olla true. Jos tulos on false, vertaa merkkijonoa ennen koodausta ja purkamisen jälkeen. Pelkkä Base64:ltä näyttävä tulos ei todista onnistumista. Testaa myös aksentillinen kirjain, emoji ja tyhjä merkkijono.
Jos vain vastaanotat tietoja, selvitä, mitkä tavut lähettäjä koodasi. Base64-aakkosto ei kerro, onko sisältö UTF-8:aa. Onnistuneen Base64-purkamisen jälkeinen UTF-8-virhe voi merkitä toista tekstikoodausta tai muuta kuin tekstitiedostoa. Säilytä PNG:n tai PDF:n puretut tavut binäärimuodossa äläkä syötä niitä tekstidekooderille.
Käyttäjälle tarkoitetussa työkalussa käsittele virheellisen syötteen poikkeukset ja jätä alkuperäinen syöte muokattavaksi. Älä esitä epäonnistunutta purkua tyhjänä onnistumistuloksena. Älä koskaan liitä yksityisiä tunnisteita tuntemattomaan verkkomuuntimeen: Base64 helpottaa sisällön siirtämistä mutta ei salaa sitä.
Miksi pelkkä ASCII-testi ei paljasta ongelmaa
Kahteen dekooderin asetukseen kannattaa kiinnittää huomiota: fatal: true hylkää virheellisen UTF-8:n sen sijaan, että vaihtaisi virheet hiljaisesti korvausmerkkeihin; ignoreBOM: true säilyttää tekstin alussa olevan merkin. TextEncoder korvaa parittoman UTF-16-surrogaatin, joten muunnos ei ole häviötön kaikille mahdollisille JavaScript-merkkijonoille.
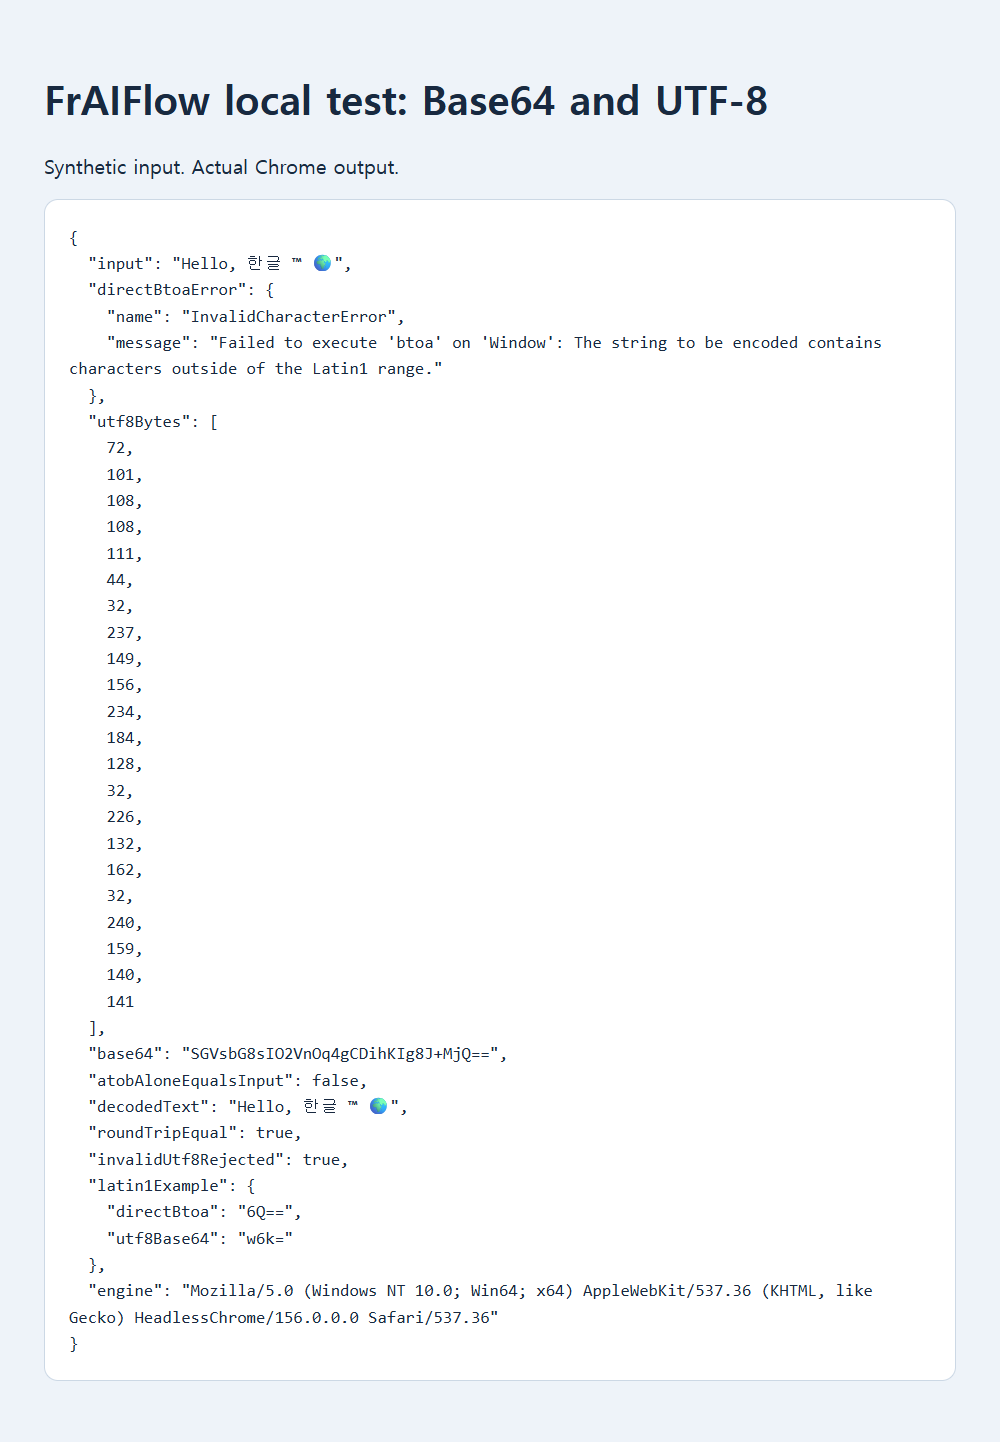
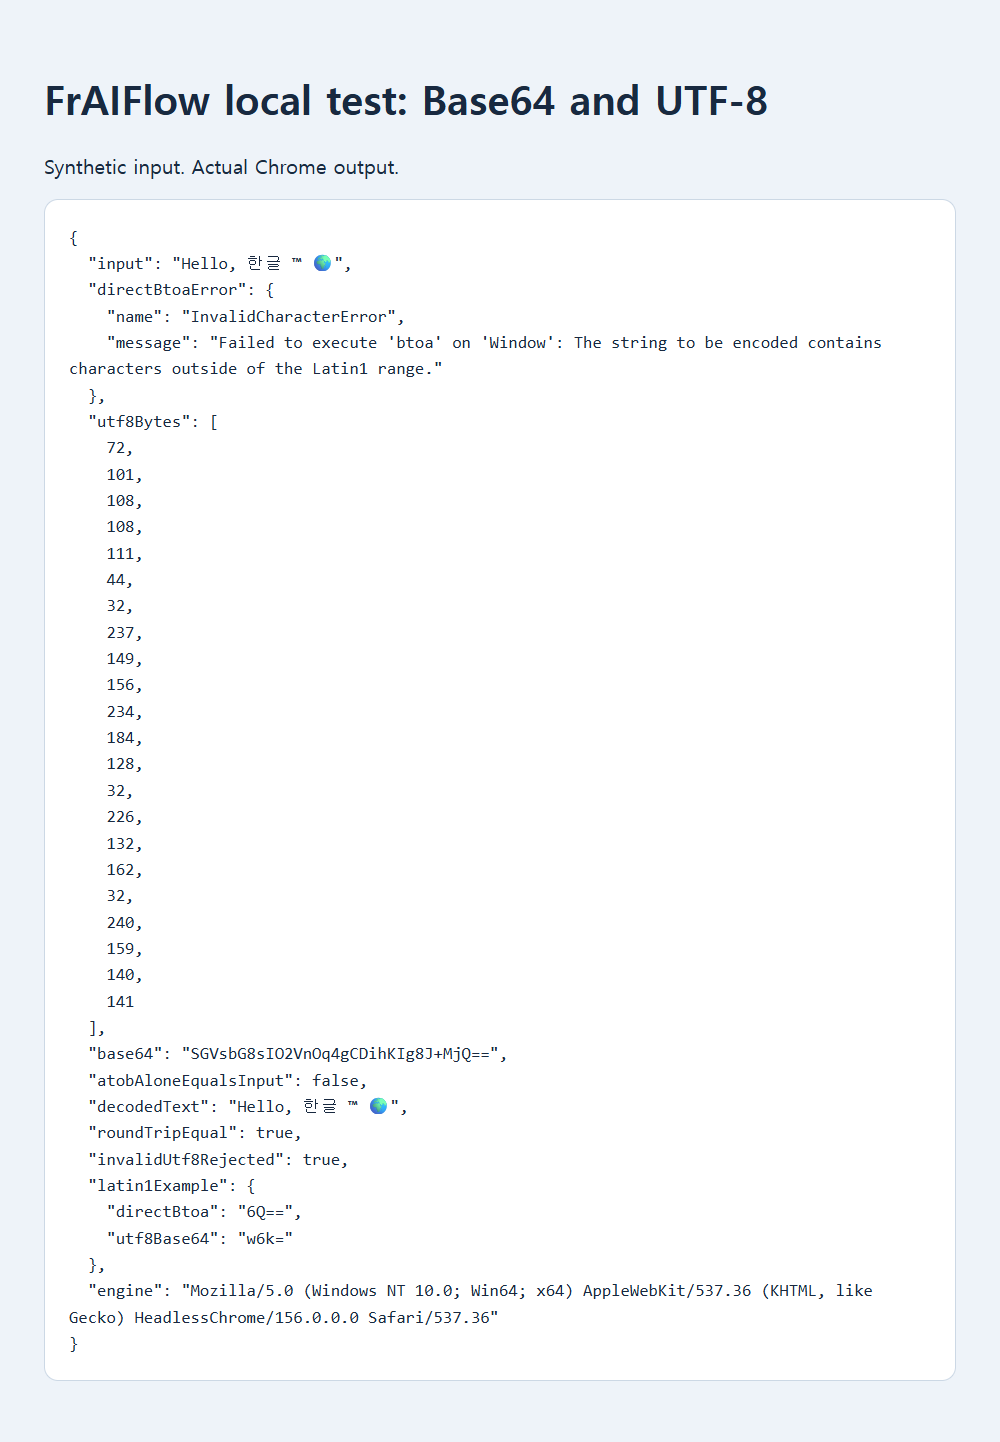
Tallennetussa paikallisessa selaintestissä käytettiin tekstiä Hello, 한글 ™ 🌍. Suora btoa()-kutsu aiheutti InvalidCharacterError-virheen. TextEncoder tuotti 22 UTF-8-tavua, joiden Base64-esitys oli SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==. Tavujen purkaminen UTF-8:na palautti täsmälleen alkuperäisen lauseen. Kyse on synteettisestä paikallistestistä, ei kummankaan ilmoittajan sovelluksesta.
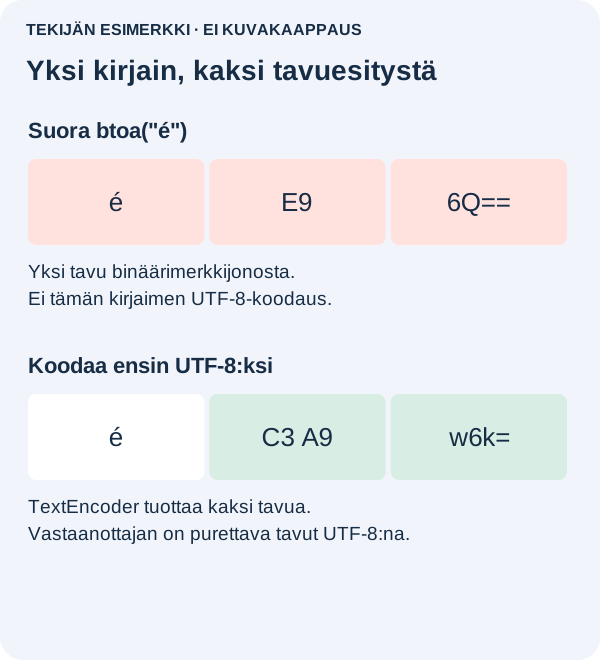
Vain ASCII:ta käyttävä testi voi peittää virheen. Esimerkissä btoa("é") palautti 6Q==, kun ensin tehty UTF-8-koodaus tuotti w6k=. Ensimmäinen kutsu ei aiheuttanut poikkeusta, mutta sen tavut ovat vääriä UTF-8:aa odottavalle vastaanottajalle. Base64 ei itsessään ilmoita merkistökoodausta.
Pura ja tarkista edestakaismuunnos
Base64 ei ole salausta eikä URL-koodausta. Plusmerkkiä voidaan käsitellä erikoismerkkinä kyselyparametreissa; katso linkitetty parametriohje. Vältä vanhentunutta unescape-kiertotapaa, aseta järkevät kokorajat äläkä paljasta yksityistä sisältöä vain koodausvirheen havainnollistamiseksi.
Lähteet, esimerkit ja lisälukeminen
- Julkinen keskustelu: Base64-koodaus epäonnistuu muilla kuin latinalaisilla merkeillä
- Julkinen keskustelu: JavaScriptin atob ei pura UTF-8-merkkijonoja oikein
- MDN: btoa
- Alkuperäinen täydentävä kaavio
- Tallennettu paikallinen testiaineisto
- MDN: TextEncoder
- MDN: atob
- MDN: TextDecoder
- MDN: ignoreBOM
- MDN: decode
- MDN: unescape
- Aiheeseen liittyvä opas: Base64 kyselyparametrissa
- Miksi kelvolliselta näyttävä JSON epäonnistuu ensimmäiseen merkkiin
- Miksi samalta näyttävät tekstit eivät täsmää