Base64で日本語や絵文字が文字化けする理由
btoa()ではHelloを変換できるのに、韓国語や絵文字で失敗する。その場合、たいてい抜けているのは文字コードの変換です。Base64が表すのはバイト列です。JavaScriptの文字列は、まず送信側と受信側で決めた方式でバイト列に変換し、受信時に逆の処理をする必要があります。
公開されている相談には、非ラテン文字を含むSVGの変換に失敗した例や、GitHub APIの内容を復号したら商標記号が文字化けした例があります。入口と出口は異なりますが、どちらも文字列とバイト列の境界の問題です。atob()が成功して返すのはバイナリ文字列であり、そのまま読めるUTF-8の文章になるとは限りません。
UTF-8への変換と復元をひと組にする
Base64を生成するコードを管理しているなら、エラーになる文字を削除するのではなく、文字列をバイト列に変換する部分を直しましょう。以下のブラウザー向けJavaScriptでは、その境界を明示しています。比較的小さなテキスト用であり、大容量アップロード向けではありません。
function encodeUtf8Base64(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
function decodeUtf8Base64(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, c => c.charCodeAt(0));
  return new TextDecoder("utf-8", {
    fatal: true, ignoreBOM: true
  }).decode(bytes);
}
const original = "Hello, 한글 ™ 🌍";
const encoded = encodeUtf8Base64(original);
const restored = decodeUtf8Base64(encoded);
console.log(encoded); // SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==
console.log(restored === original); // true
既存の変換処理のそばにこの関数を置き、実データに置き換える前にサンプルを試してください。一致判定がtrueになれば、元の文字列に戻っています。falseなら、変換前と復号後の文字列を比較します。出力が「Base64らしく見える」だけで成功と判断しないでください。アクセント付き文字、絵文字、空文字列も試験に含めましょう。
受信だけを担当している場合は、送信側が何のバイト列を符号化したのか確認してください。Base64の文字だけではUTF-8かどうかは分かりません。Base64の復号には成功してもUTF-8の解釈で失敗するなら、別の文字コードやテキスト以外のファイルかもしれません。PNGやPDFは、文字列に変換せずバイナリのまま保持します。
利用者向けのツールでは不正入力のエラーを捕捉し、元の入力を編集できる状態で残してください。復号失敗を空の正常結果に置き換えてはいけません。また、秘密のトークンを知らないオンライン変換サイトへ貼り付けないでください。Base64はデータを扱いやすくする形式であって、秘密にする仕組みではありません。
ASCIIだけのテストでは見落とす理由
デコーダーの二つの設定にも注意してください。fatal: trueは、不正なUTF-8を代替文字に黙って置き換えず、エラーとして拒否します。一方、ignoreBOM: trueは先頭の文字マーカーを保持します。なお、対応する相手のないUTF-16サロゲートはTextEncoderで置換されるため、この処理があらゆるJavaScript文字列を完全に保持するわけではありません。
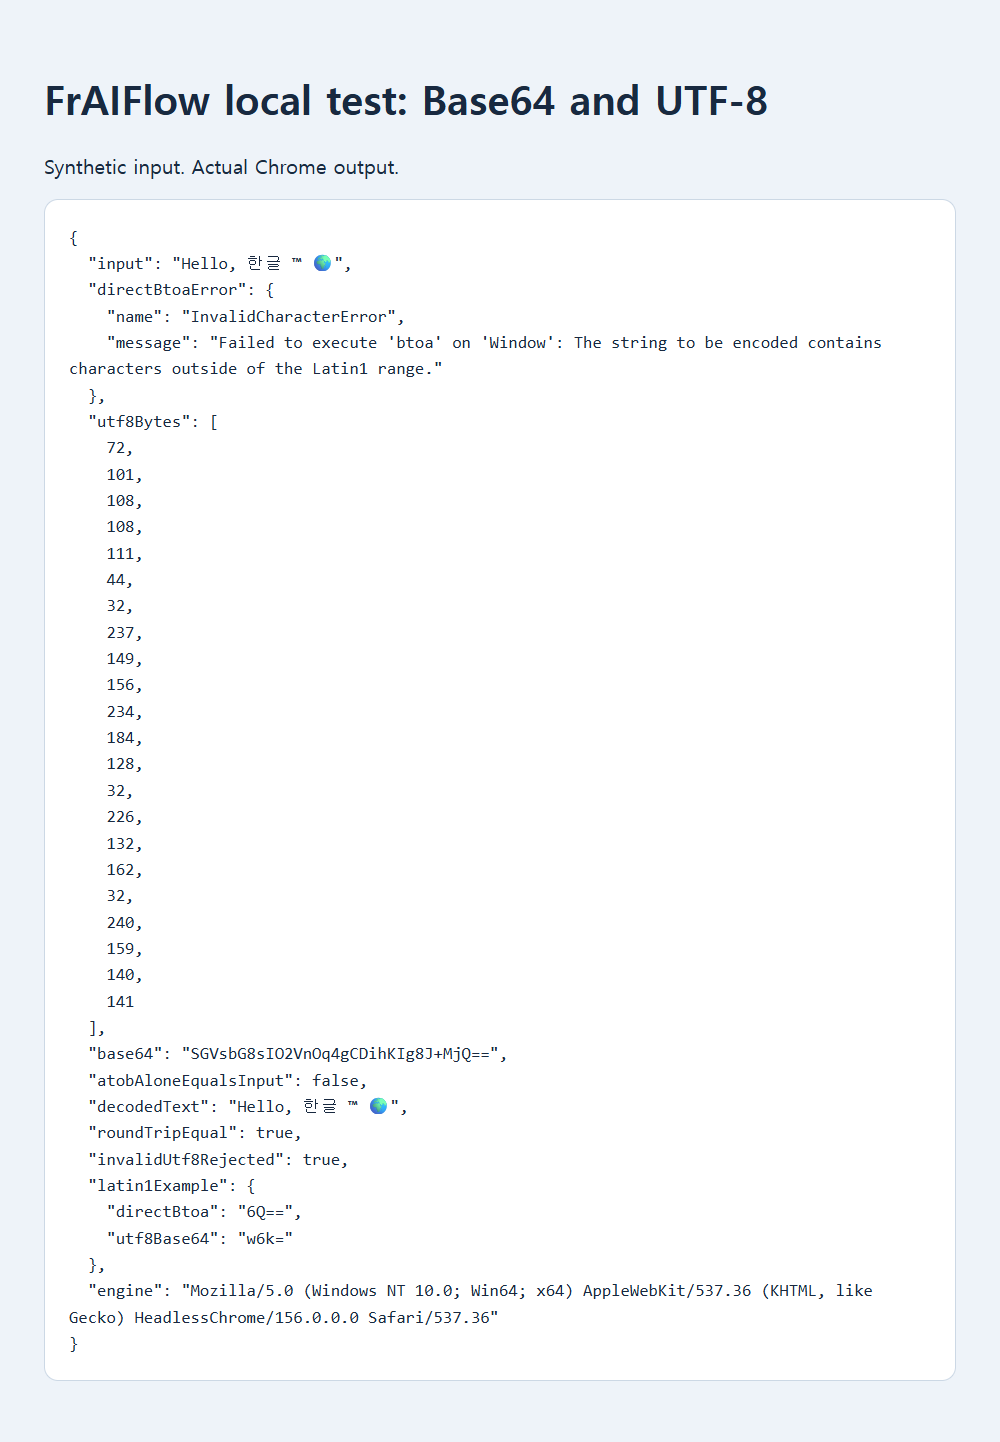
保存済みのローカルブラウザーテストでは、Hello, 한글 ™ 🌍を使用しました。直接btoa()に渡すとInvalidCharacterErrorになり、TextEncoderではUTF-8の22バイトになりました。そのBase64はSGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==です。UTF-8として復号すると元の文に完全一致しました。これは手元で作った試験データによるテストであり、相談者のアプリケーションを検証したものではありません。
ASCIIだけのテストでは不具合が隠れることがあります。この例ではbtoa("é")の結果は6Q==でしたが、先にUTF-8へ変換するとw6k=になりました。前者は例外を出しませんが、UTF-8を期待する受信側には誤ったバイト列です。Base64自体には文字コードの宣言がありません。
復号して、元に戻ったことまで確認する
Base64は暗号化でもURLエスケープでもありません。クエリーパラメーターではプラス記号が特別に解釈されることがあるので、リンク先の解説も確認してください。非推奨のunescapeを使う回避策は避け、現実的な入力サイズ上限を設けましょう。文字コードの問題を説明するためだけに機密データを公開してはいけません。