為什麼 Base64 處理非英文文字會出錯?
如果 btoa() 可以處理 Hello,卻遇到韓文或 emoji 就失敗,通常是少了文字編碼這一步。Base64 表示的是位元組。JavaScript 字串必須先依雙方約定的方式轉成位元組,接收端也要以對應方式轉回文字。
一則公開討論涉及含有非拉丁字元的 SVG 標記;另一則則是解碼 GitHub API 內容後,商標符號變成亂碼。兩者分別發生在同一個轉換邊界的兩端。atob() 成功回傳的是二進位字串,不會自動變成可閱讀的 UTF-8 文字。
完成一次完整的 UTF-8 往返轉換
如果產生 Base64 的程式由你維護,應修正文字與二進位之間的轉換,而不是刪除引發錯誤的字元。下列瀏覽器 JavaScript 函式將這個邊界寫清楚。它們適用於合理大小的文字資料,不是大型檔案上傳方案。
function encodeUtf8Base64(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
function decodeUtf8Base64(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, c => c.charCodeAt(0));
  return new TextDecoder("utf-8", {
    fatal: true, ignoreBOM: true
  }).decode(bytes);
}
const original = "Hello, 한글 ™ 🌍";
const encoded = encodeUtf8Base64(original);
const restored = decodeUtf8Base64(encoded);
console.log(encoded); // SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==
console.log(restored === original); // true
將這些函式放在既有的轉換程式旁,先用範例測試,再換成實際內容。相等性檢查應得到 true。如果是 false,請比對編碼前與解碼後的字串,不要只憑輸出「看起來像 Base64」就判定成功。測試資料也應包含帶重音字母、emoji 與空字串。
如果你只負責接收資料,請確認傳送端究竟編碼了什麼位元組。Base64 的字母表不會告訴你它是不是 UTF-8。Base64 解碼成功,接著 UTF-8 解碼失敗,可能表示原本使用其他文字編碼,或內容根本不是文字。PNG 與 PDF 應保留解碼後的二進位位元組,不要再用文字解碼器處理。
提供給使用者的工具應捕捉格式錯誤例外,並保留原始輸入讓使用者修改。不要把解碼失敗變成空白的「成功結果」。私人權杖也不要貼進來路不明的線上轉換器:Base64 讓內容方便傳遞,並不會讓內容保密。
為什麼只測 ASCII 會漏掉問題?
有兩個解碼選項值得注意:fatal: true 會拒絕無效 UTF-8,而不是默默換成替代字元;ignoreBOM: true 則會保留開頭的文字標記。未成對的 UTF-16 代理碼會被 TextEncoder 替換,所以這套流程並不能對每一種可能的 JavaScript 字串都保證無損。
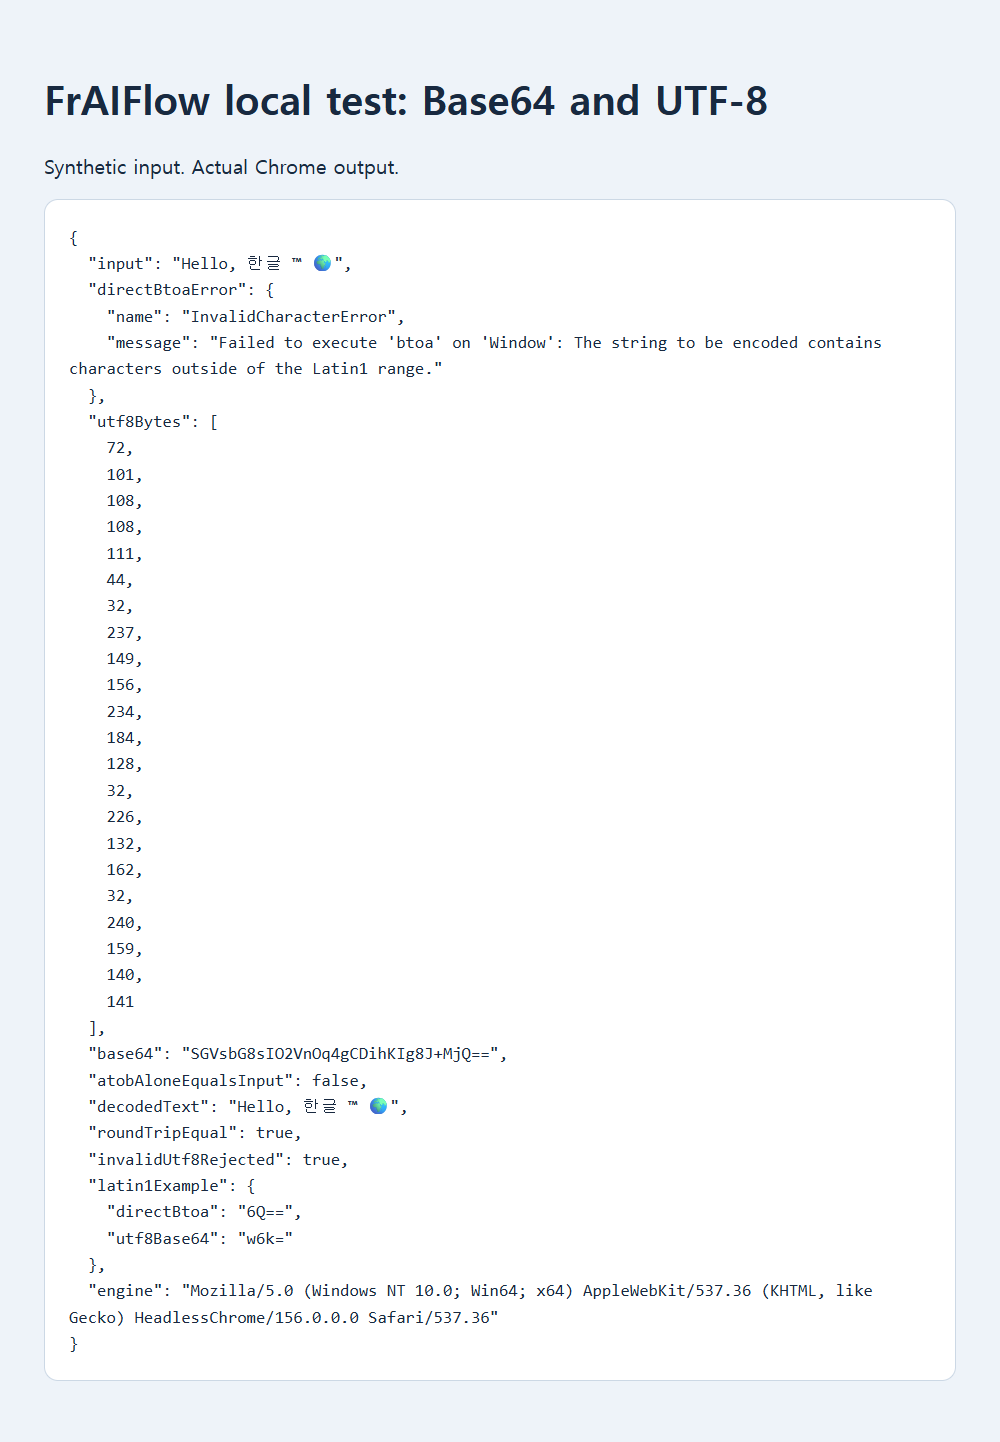
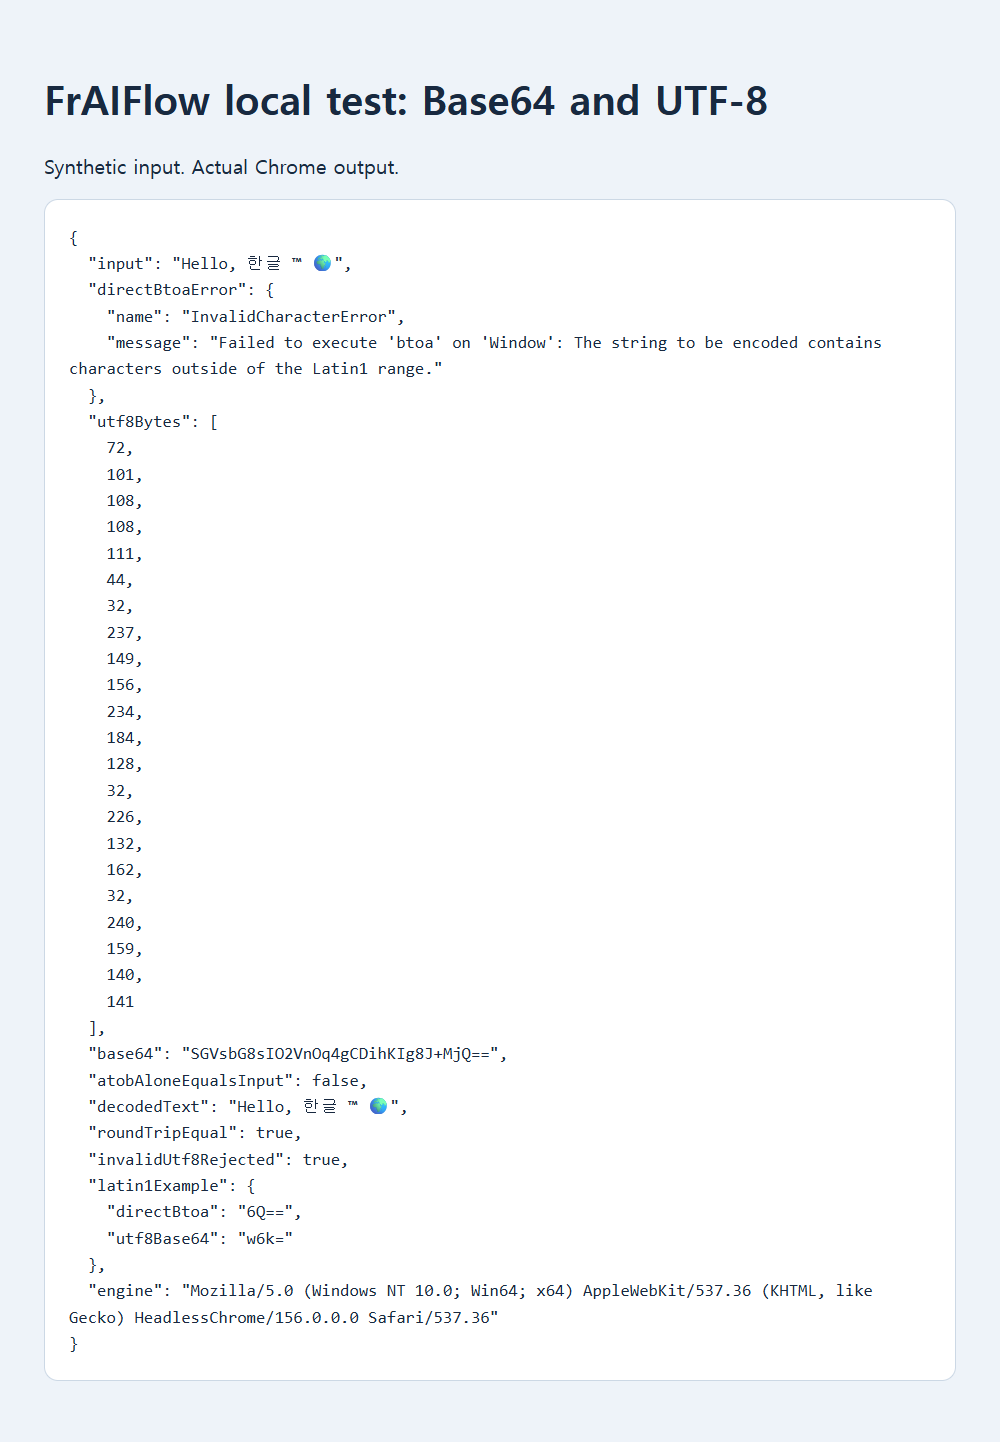
保存的本機瀏覽器測試使用 Hello, 한글 ™ 🌍。直接呼叫 btoa() 會拋出 InvalidCharacterError。TextEncoder 產生 22 個 UTF-8 位元組,再編碼為 SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==。將這些位元組以 UTF-8 解碼後,可完整還原原句。這是人工測試資料的本機測試,並非上述兩位發問者的應用程式。
只測 ASCII 容易掩蓋錯誤。範例中,btoa("é") 得到 6Q==,先轉為 UTF-8 再編碼則得到 w6k=。前者沒有拋出錯誤,但對預期 UTF-8 的接收端來說,位元組仍然是錯的。Base64 本身不包含字元編碼宣告。
解碼後務必確認是否還原原文
Base64 既不是加密,也不是 URL 跳脫。加號在查詢參數中可能被特殊解讀,請參考連結的查詢參數指南。避免使用已淘汰的 unescape 變通寫法,設定合理的資料大小上限,也不要為了示範編碼錯誤而公開私人內容。