看起來一樣的文字,為什麼比對不相等?
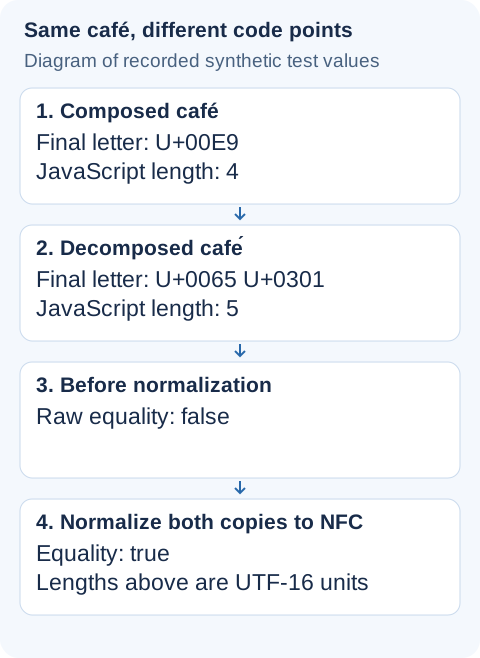
兩個 café 看起來完全一樣,比對結果卻可能是不相等。一個可能以 U+00E9 結尾,另一個則以 U+0065 加上組合字元 U+0301 結尾。重音符號並沒有打錯;差別在於儲存的 Unicode 序列不同,比對規則必須能處理這種差異。
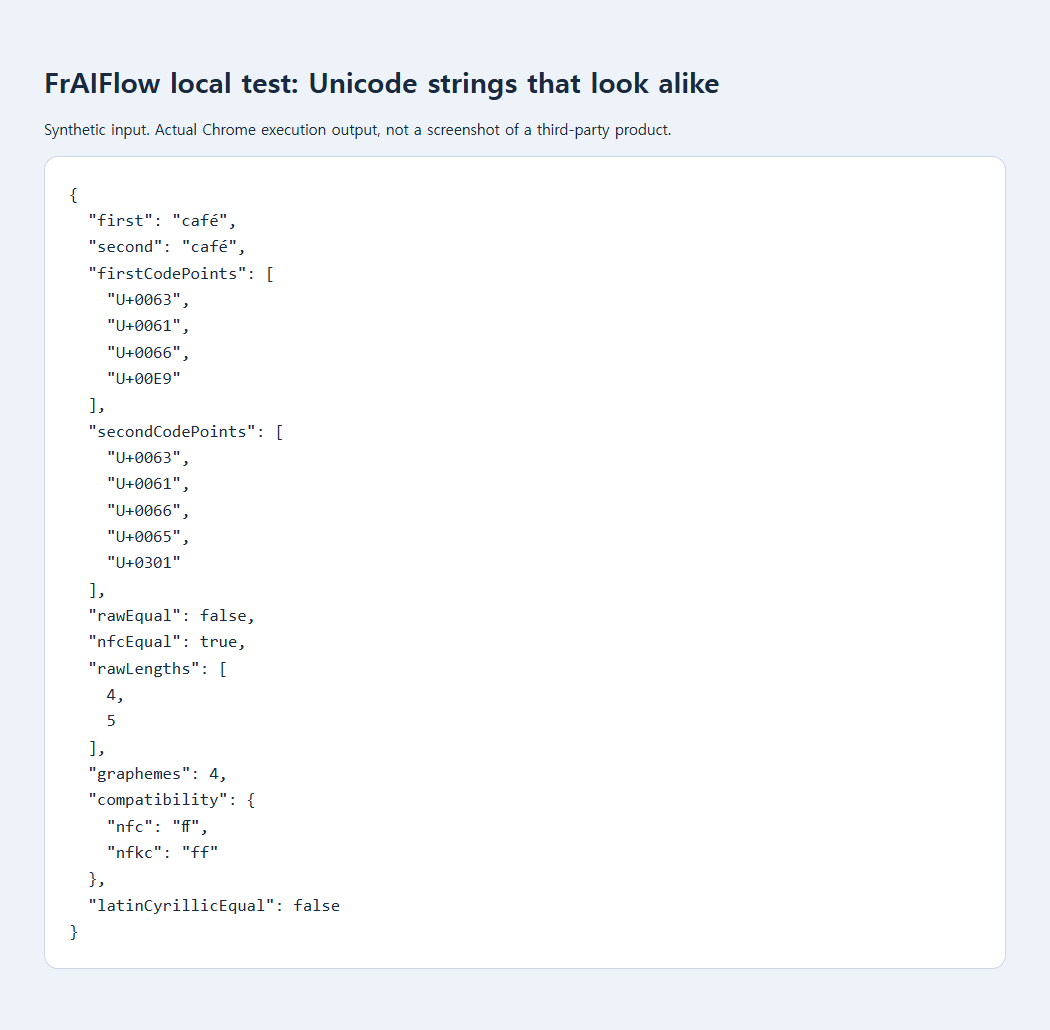
2019 年一則 Stack Overflow 問題提到,外觀看來相同的越南文無法通過相等性檢查,回答採用了共同的正規化形式。本文保存的瀏覽器測試使用另一組人工建立的 café 字串:直接比較得到 false,將兩邊都轉為 NFC 後則得到 true。這不是對發問者應用程式的重現。
先處理一組比對失敗的文字
不要一開始就修改整份試算表或資料庫。先將理應相同的兩個值複製到小型本機程式中;如果內容可識別客戶,請改用無敏感資訊的範例。把碼位並排看清楚,比反覆重打重音符號有效得多。
const typed = "caf\u00E9";
const pasted = "cafe\u0301";
const points = s => Array.from(s, c =>
  "U+" + c.codePointAt(0).toString(16).toUpperCase().padStart(4, "0")
).join(" ");
console.log(points(typed));  // U+0063 U+0061 U+0066 U+00E9
console.log(points(pasted)); // U+0063 U+0061 U+0066 U+0065 U+0301
console.log(typed === pasted); // false
const matches = typed.normalize("NFC") === pasted.normalize("NFC");
console.log(matches); // true
從左到右比較兩個序列。這個範例的前三個字母相同,只有最後一個帶重音字母的表示方式不同,正好是 NFC 適合處理的情況。下方圖解將兩種儲存形式呈現出來:多出來的標記是組合重音符號,不是應該刪除的多餘字母。
用於搜尋或匯入比對時,請另外建立正規化的比對鍵,並保留原始值供畫面顯示。比對雙方都要正規化,包括資料庫既有的值。如果只處理新輸入,舊資料仍會不一致。全面套用前,先測試幾組應相等,以及幾組必須保持不同的文字。
如果結果仍是 false,請檢查結尾空白、不換行空白,或不同字母系統的字元。不要因此就把所有重音與標點全部刪掉。這些屬於另一套比對政策,可能把不同姓名合併。若疑似重複的資料涉及帳號、付款或身分,應交由人工確認,而不是把外觀相似視為證明。
文字比對相同,不代表身分相同
NFC 比對相等並不能證明兩個帳號屬於同一個人。請先預覽疑似重複的資料群組,並明確定義這份資料的「相同」代表什麼。不要順手對密碼、簽章或不透明權杖加入正規化清理:這些系統可能要求位元組或字元完全一致。
為什麼不全部使用 NFKC?
NFKC 還會進行相容性對應。在保存的測試中,連字 U+FB00 經 NFC 後不變,經 NFKC 後則變成 ff。對刻意放寬的搜尋鍵來說可能有幫助,但也可能失去原文必須保留的差異。應先決定比對政策,再選擇轉換方式。
正規化也不會解決形似字問題:範例中的拉丁字母 a 與西里爾字母 U+0430 仍不相等。它也不會替網站定義字數上限。兩種 café 在 JavaScript 中的長度分別為 4 與 5 個 UTF-16 碼元;將分解形式依字素分段,則得到讀者看到的 4 組字元。這些是不同的測量方式。