Pourquoi deux textes visuellement identiques ne correspondent pas
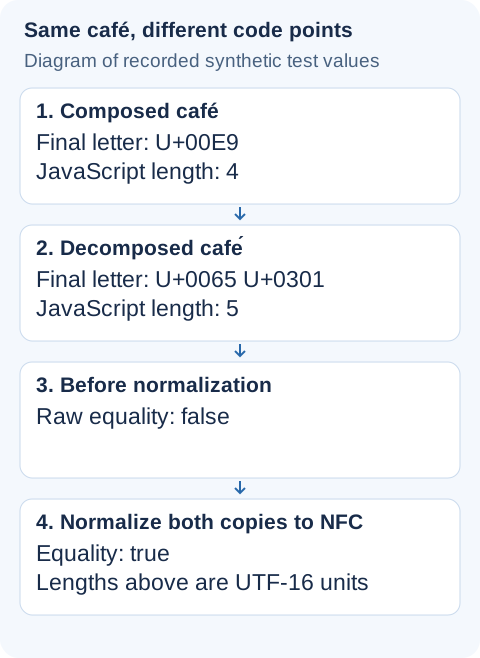
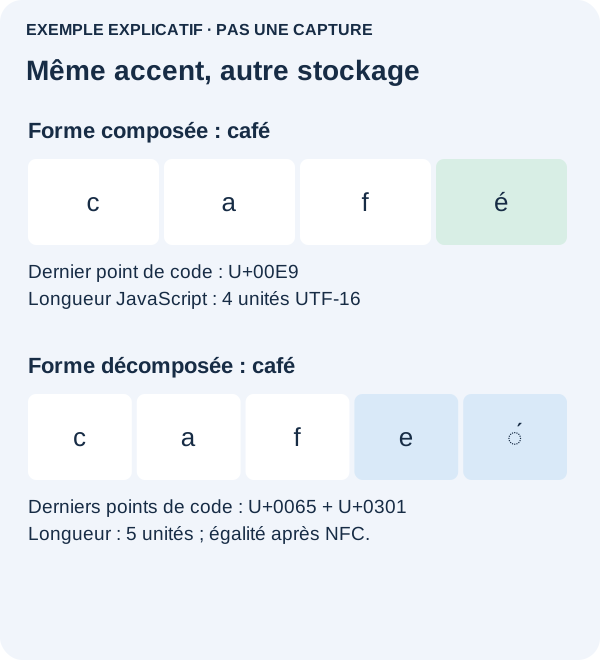
Deux exemplaires du mot café peuvent sembler identiques sans être égaux lors d’une comparaison. L’un peut se terminer par U+00E9 ; l’autre par U+0065 suivi de l’accent combinant U+0301. L’accent n’est pas incorrect. Ce sont les séquences Unicode enregistrées qui diffèrent, et la règle de comparaison doit en tenir compte.
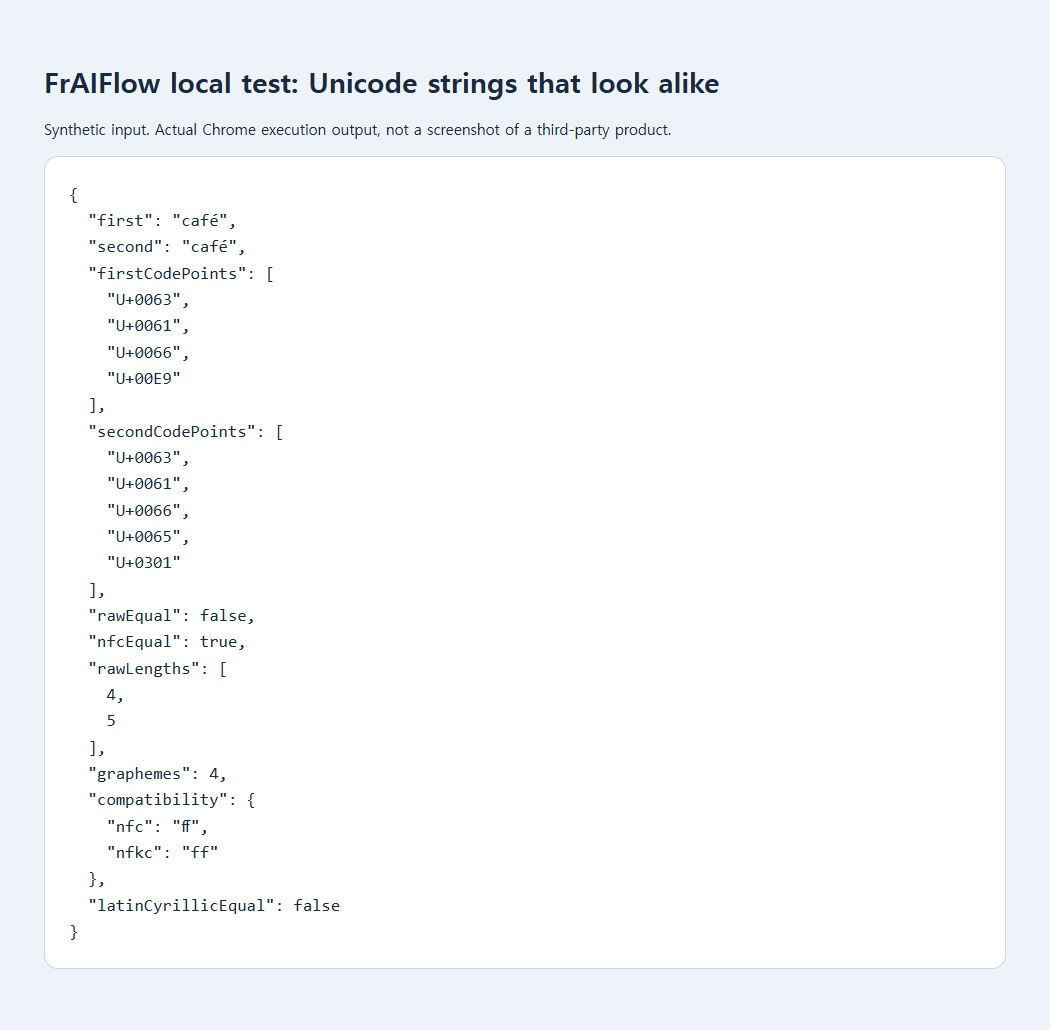
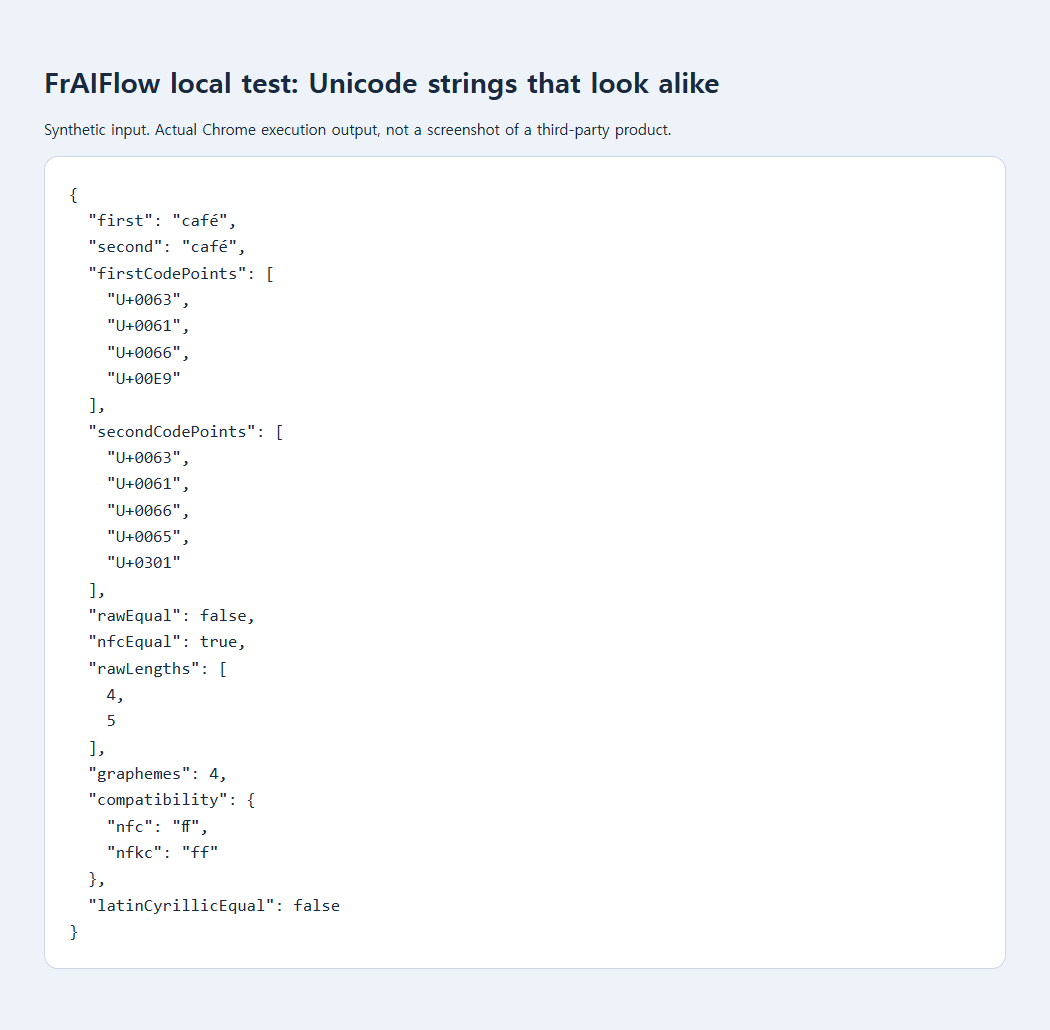
Une question publiée sur Stack Overflow en 2019 décrivait des textes vietnamiens d’apparence similaire qui échouaient aux tests d’égalité. La réponse proposait une forme de normalisation commune. Notre test enregistré dans un navigateur utilise une autre paire, synthétique, fondée sur café : l’égalité directe était false, tandis que la comparaison des deux formes NFC renvoyait true. Il ne reproduit pas l’application de l’auteur de la question.
Commencez par une seule paire qui ne correspond pas
Avant de modifier tout un tableur ou une base de données, copiez seulement les deux valeurs censées correspondre dans un petit script local. Utilisez un exemple sans données sensibles si les vraies valeurs identifient des clients. Comparer les points de code côte à côte est bien plus instructif que de ressaisir plusieurs fois un accent.
const typed = "caf\u00E9";
const pasted = "cafe\u0301";
const points = s => Array.from(s, c =>
  "U+" + c.codePointAt(0).toString(16).toUpperCase().padStart(4, "0")
).join(" ");
console.log(points(typed));  // U+0063 U+0061 U+0066 U+00E9
console.log(points(pasted)); // U+0063 U+0061 U+0066 U+0065 U+0301
console.log(typed === pasted); // false
const matches = typed.normalize("NFC") === pasted.normalize("NFC");
console.log(matches); // true
Lisez les deux séquences de gauche à droite. Ici, les trois premières lettres correspondent ; seule la représentation de la dernière lettre accentuée diffère. C’est précisément le cas que NFC est conçu pour traiter. L’illustration ci-dessous rend visibles les deux formes de stockage : le signe supplémentaire est un accent combinant, pas une lettre indésirable.
Pour comparer des valeurs lors d’une recherche ou d’un import, créez une clé normalisée distincte et gardez la valeur originale pour l’affichage. Normalisez les deux côtés de la comparaison, y compris les valeurs déjà présentes dans votre base. Normaliser seulement les nouvelles saisies laisserait les anciens enregistrements incohérents. Avant d’appliquer la règle partout, vérifiez quelques paires qui doivent correspondre et quelques autres qui doivent rester différentes.
Si le résultat reste false, recherchez une espace finale, une espace insécable ou un caractère d’un autre alphabet. Ne supprimez pas tous les accents et signes de ponctuation pour contourner le problème. Ce sont d’autres règles de rapprochement, susceptibles de fusionner des noms différents. Si un groupe de doublons supposés concerne des comptes, des paiements ou l’identité, soumettez-le à une vérification plutôt que de considérer la ressemblance visuelle comme une preuve.
Ne confondez pas correspondance et identité
Une correspondance après normalisation NFC ne prouve pas que deux comptes appartiennent à la même personne. Examinez les groupes de doublons proposés et définissez ce que signifie une correspondance pour vos données. N’ajoutez pas de normalisation aux mots de passe, signatures ou jetons opaques comme simple nettoyage : ces systèmes peuvent exiger une correspondance exacte des octets ou des caractères.
Pourquoi ne pas utiliser NFKC partout ?
NFKC ajoute des transformations de compatibilité. Dans le test enregistré, la ligature U+FB00 restait inchangée avec NFC, mais devenait ff avec NFKC. Cela peut servir pour une clé de recherche volontairement tolérante, tout en supprimant une distinction nécessaire dans le texte original. Choisissez la règle métier avant la transformation.
La normalisation ne résout pas non plus les ressemblances entre alphabets : le a latin et le caractère cyrillique U+0430 restaient différents dans l’exemple. Elle ne définit pas davantage la limite de caractères d’un site. Les deux formes de café mesuraient 4 et 5 unités de code UTF-16 en JavaScript ; la segmentation en graphèmes du mot décomposé produisait 4 groupes perçus par le lecteur. Il s’agit de mesures différentes.
Sources, exemples et lectures complémentaires
- Discussion publique : des textes identiques en apparence ne sont pas égaux
- Schéma explicatif d’origine
- Preuve conservée du test local
- Référence MDN : normalize
- Spécification de la normalisation Unicode
- Référence MDN : length
- Discussion publique : compter correctement une chaîne contenant des emojis en JavaScript
- Pourquoi un JSON apparemment valide échoue dès le premier caractère
- Pourquoi Base64 pose problème avec les textes non anglais