Miksi samalta näyttävät tekstit eivät täsmää
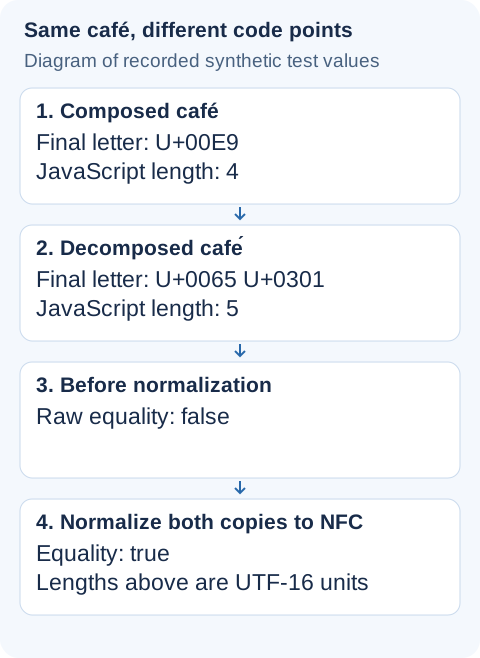
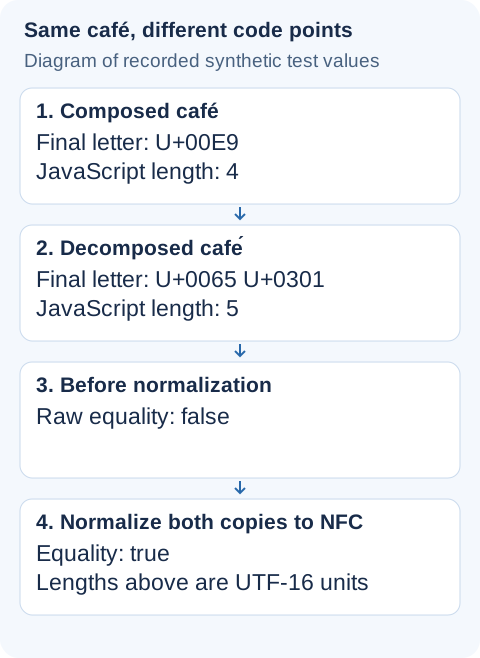
Kaksi café-sanaa voivat näyttää samoilta mutta olla vertailussa erisuuria. Toinen voi päättyä merkkiin U+00E9, toinen merkkeihin U+0065 ja yhdistävä U+0301. Aksentti ei ole väärä. Tallennetut Unicode-jonot poikkeavat toisistaan, ja vertailusäännön pitää huomioida tämä ero.
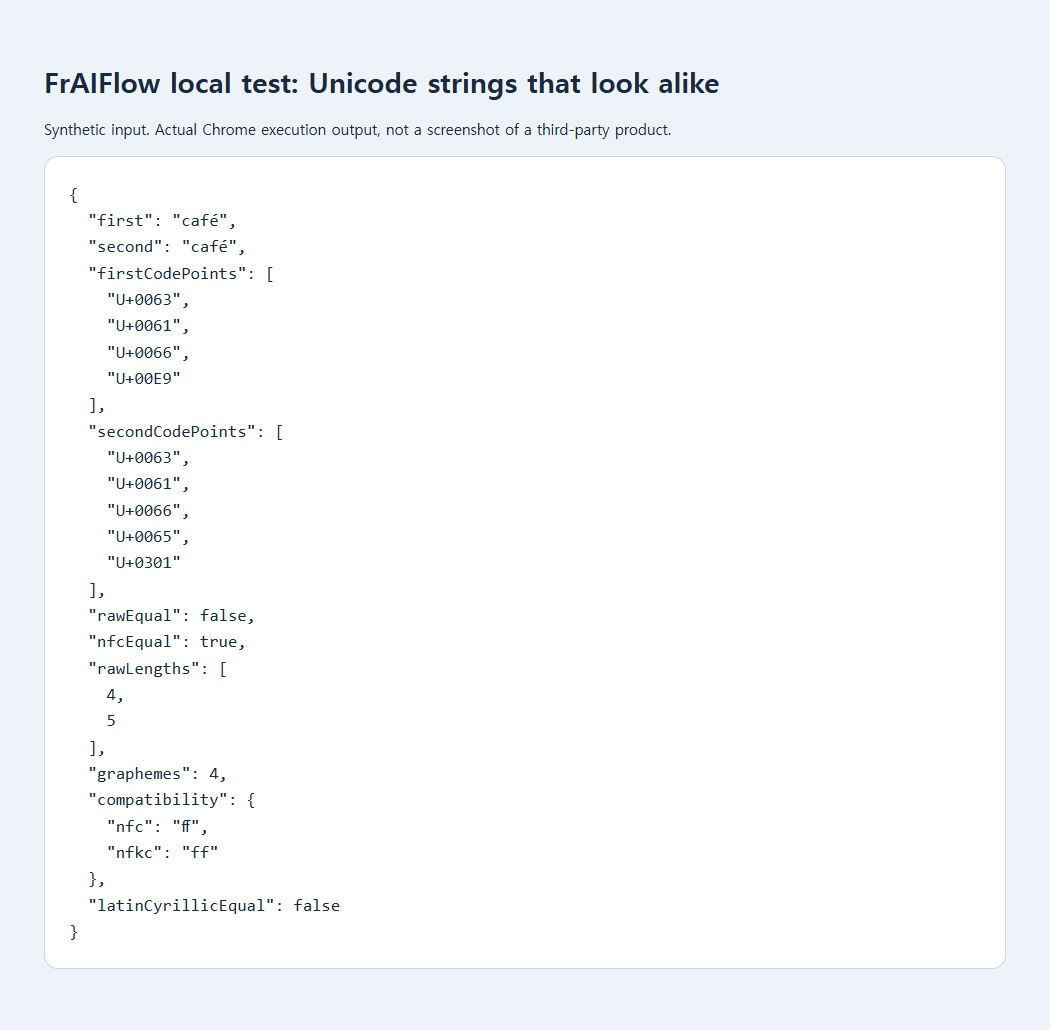
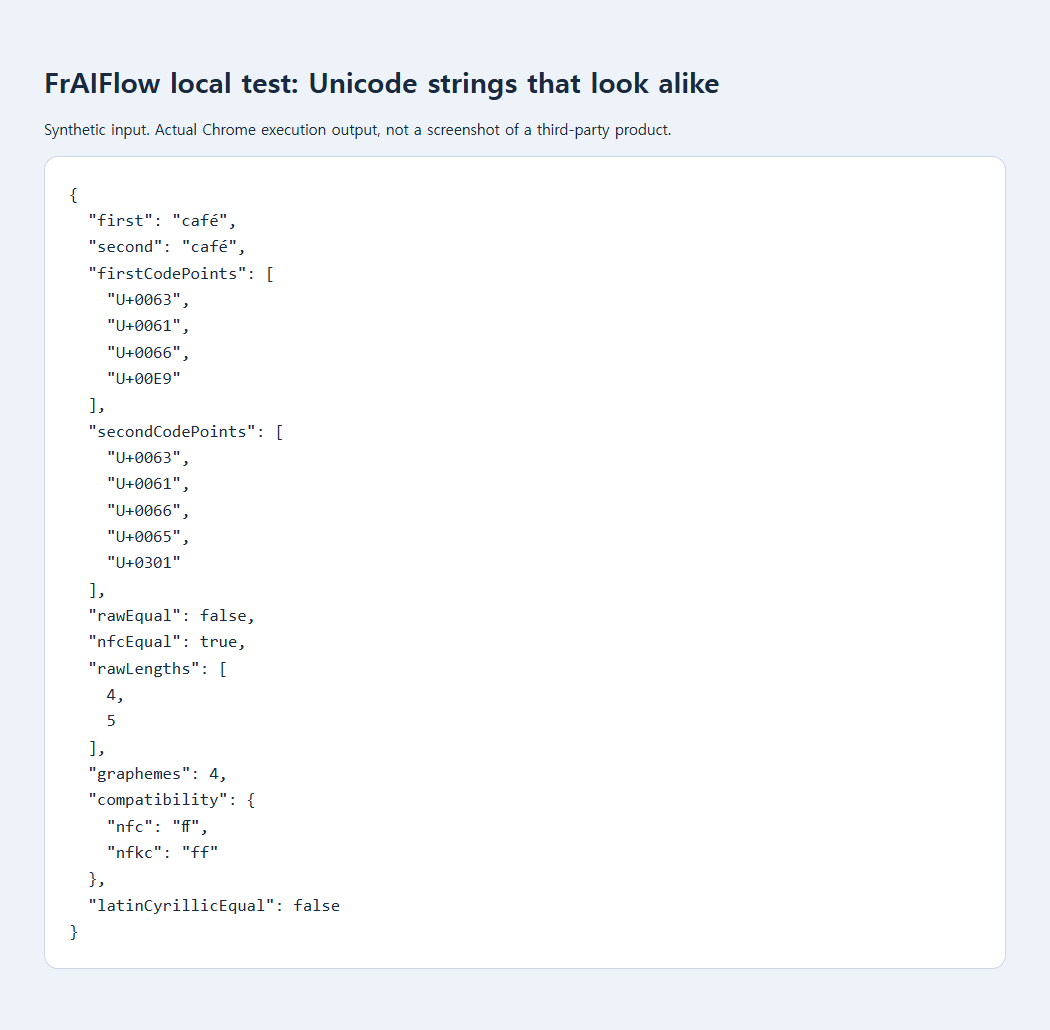
Vuoden 2019 Stack Overflow -kysymyksessä ulkoisesti samankaltainen vietnaminkielinen teksti ei läpäissyt yhtäsuuruusvertailua. Vastauksessa käytettiin yhteistä normalisointimuotoa. Tallennettu selaintestimme käyttää erillistä synteettistä café-paria: suora vertailu antoi false, molempien NFC-muotojen vertailu true. Se ei toista ilmoittajan sovellusta.
Tutki ensin yksi poikkeava pari
Ennen koko laskentataulukon tai tietokannan muuttamista kopioi vain kaksi toisiaan vastaavaa arvoa pieneen paikalliseen skriptiin. Käytä vaaratonta esimerkkitekstiä, jos oikeat arvot tunnistavat asiakkaita. Koodipisteiden rinnakkainen tarkastelu auttaa paljon enemmän kuin aksentin toistuva kirjoittaminen uudelleen.
const typed = "caf\u00E9";
const pasted = "cafe\u0301";
const points = s => Array.from(s, c =>
  "U+" + c.codePointAt(0).toString(16).toUpperCase().padStart(4, "0")
).join(" ");
console.log(points(typed));  // U+0063 U+0061 U+0066 U+00E9
console.log(points(pasted)); // U+0063 U+0061 U+0066 U+0065 U+0301
console.log(typed === pasted); // false
const matches = typed.normalize("NFC") === pasted.normalize("NFC");
console.log(matches); // true
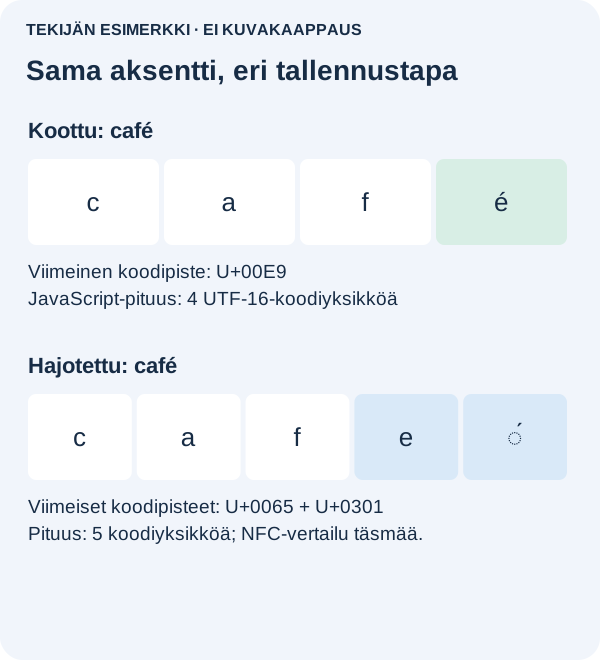
Lue molemmat jonot vasemmalta oikealle. Tässä kolme ensimmäistä kirjainta vastaavat toisiaan; vain viimeisen aksentillisen kirjaimen esitystapa eroaa. Juuri tähän NFC on tarkoitettu. Alla oleva kuva näyttää molemmat tallennusmuodot: ylimääräinen merkki on yhdistävä aksentti, ei tarpeeton lisäkirjain.
Luo haku- tai tuontivertailua varten erillinen normalisoitu avain ja säilytä alkuperäinen näyttöarvo. Normalisoi vertailun molemmat puolet, myös tietokannassa jo olevat arvot. Pelkän uuden syötteen normalisointi jättää vanhat tietueet epäyhtenäisiksi. Testaa ennen laajaa käyttöönottoa pareja, joiden pitää täsmätä, sekä pareja, joiden pitää pysyä erillisinä.
Jos tulos on edelleen false, etsi lopusta välilyöntiä, sitovaa välilyöntiä tai eri aakkoston merkkiä. Älä poista tämän vuoksi kaikkia aksentteja tai välimerkkejä. Ne ovat erillisiä vastaavuussääntöjä ja voivat yhdistää eri nimiä. Jos ehdotettu kaksoiskappaleryhmä koskee tilejä, maksuja tai henkilöllisyyttä, näytä se tarkistettavaksi äläkä pidä ulkoista samankaltaisuutta todisteena.
Älä muuta tunnisteita pelkän vertailun vuoksi
NFC-vastaavuus ei todista kahden tilin kuuluvan samalle henkilölle. Esikatsele ehdotetut kaksoiskappaleryhmät ja määritä, mitä vastaavuus tarkoittaa aineistossasi. Älä lisää normalisointia salasanoihin, allekirjoituksiin tai läpinäkymättömiin tunnisteisiin sivuvaikutuksena: ne voivat vaatia täsmällistä tavu- tai merkkivastaavuutta.
Miksi NFKC:tä ei käytetä kaikkialla?
NFKC lisää yhteensopivuusmuunnoksia. Tallennetussa testissä ligatuuri U+FB00 säilyi NFC:ssä mutta muuttui NFKC:ssä muotoon ff. Tästä voi olla hyötyä tarkoituksella väljässä hakuavaimessa, mutta samalla voi kadota alkuperäisessä kirjoituksessa tarvittava ero. Valitse vastaavuussääntö ennen muunnosta.
Normalisointi ei ratkaise samannäköisiä eri merkkejä: latinalainen a ja kyrillinen U+0430 pysyivät esimerkissä erisuurina. Se ei myöskään määritä sivuston merkkirajaa. Café-muotojen JavaScript-pituudet olivat 4 ja 5 UTF-16-koodiyksikköä; hajotetun sanan grafeemijako tuotti 4 lukijan hahmottamaa ryhmää. Nämä ovat eri mittauksia.
Lähteet, esimerkit ja lisälukeminen
- Julkinen keskustelu: sama teksti ei ole yhtäsuuri ja muuntaminen samaan koodaukseen
- Alkuperäinen täydentävä kaavio
- Tallennettu paikallinen testiaineisto
- MDN: normalize
- Unicoden normalisointimääritys
- MDN: length
- Julkinen keskustelu: emojimerkkijonon oikean pituuden laskeminen JavaScriptissä
- Miksi kelvolliselta näyttävä JSON epäonnistuu ensimmäiseen merkkiin
- Miksi Base64 rikkoo muunkielisen tekstin