Hvorfor tekst, der ser ens ud, ikke matcher
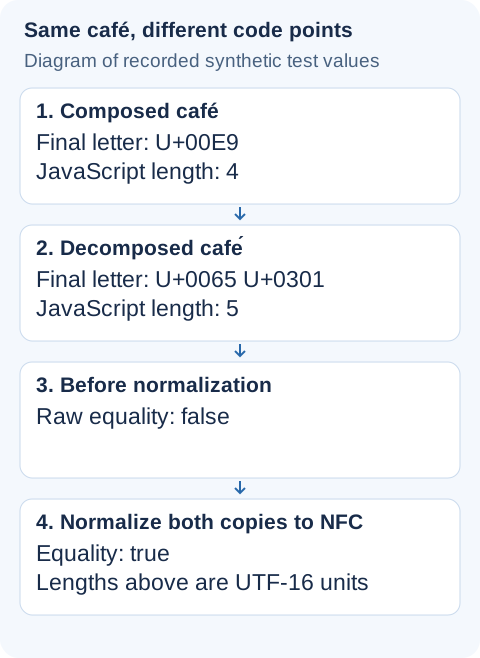
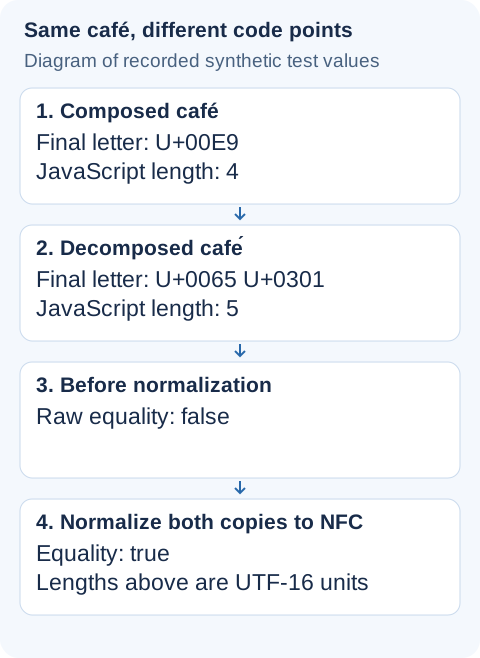
To kopier af café kan se identiske ud og alligevel være forskellige ved sammenligning. Den ene kan slutte med U+00E9; den anden med U+0065 efterfulgt af det kombinerende U+0301. Accenten er ikke forkert. De lagrede Unicode-sekvenser er forskellige, og sammenligningsreglen skal tage højde for den forskel.
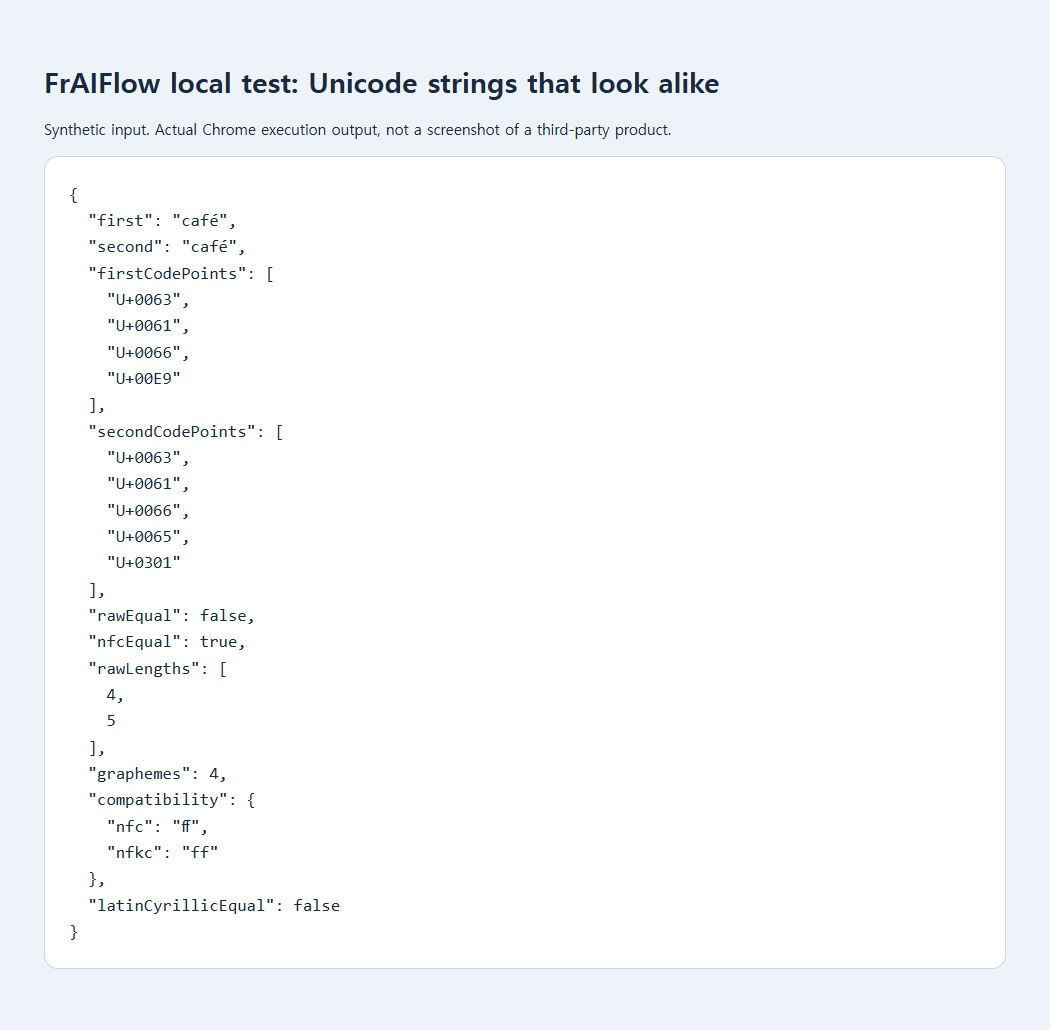
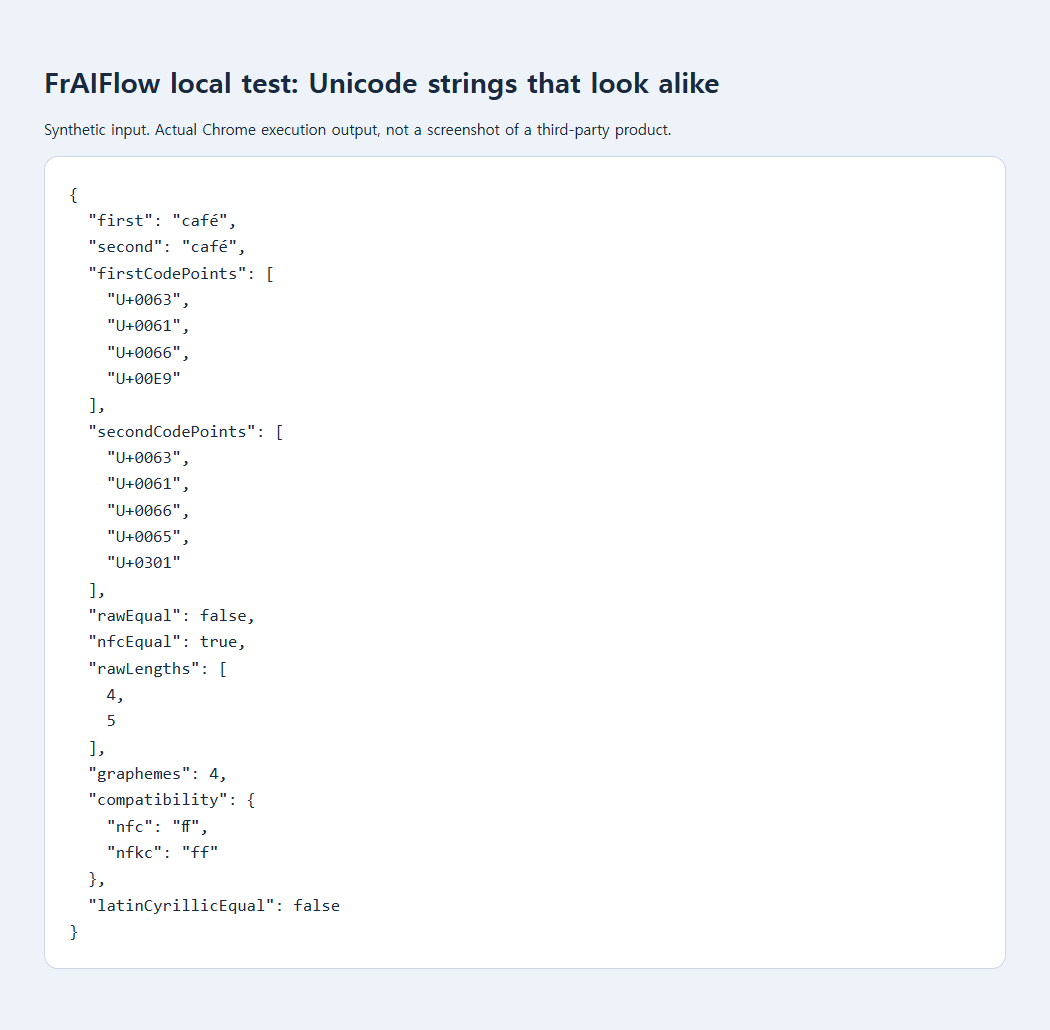
Et Stack Overflow-spørgsmål fra 2019 beskrev vietnamesisk tekst, der så ens ud, men ikke bestod lighedstjek. Svaret brugte en fælles normaliseringsform. Vores gemte browsertest bruger et andet, syntetisk café-par: Direkte lighed var false, mens sammenligning af begge NFC-former gav true. Det er ikke en genskabelse af fejlrapportørens program.
Gennemgå først ét par, der ikke matcher
Før du ændrer et helt regneark eller en database, bør du kopiere netop de to værdier, som burde matche, til et lille lokalt script. Brug harmløs eksempeltekst, hvis de rigtige værdier identificerer kunder. Det er langt mere nyttigt at se kodepunkterne side om side end at skrive accenten igen og igen.
const typed = "caf\u00E9";
const pasted = "cafe\u0301";
const points = s => Array.from(s, c =>
  "U+" + c.codePointAt(0).toString(16).toUpperCase().padStart(4, "0")
).join(" ");
console.log(points(typed));  // U+0063 U+0061 U+0066 U+00E9
console.log(points(pasted)); // U+0063 U+0061 U+0066 U+0065 U+0301
console.log(typed === pasted); // false
const matches = typed.normalize("NFC") === pasted.normalize("NFC");
console.log(matches); // true
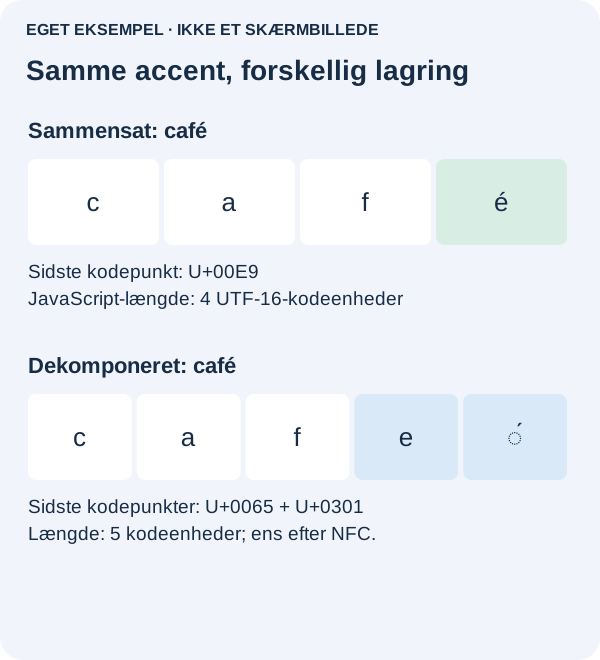
Læs de to sekvenser fra venstre mod højre. Her er de første tre bogstaver ens; kun repræsentationen af det sidste bogstav med accent er forskellig. Det er den situation, NFC er beregnet til. Illustrationen nedenfor gør de to lagringsformer synlige; det ekstra tegn er en kombinerende accent, ikke et uønsket ekstra bogstav.
Ved søgning eller importsammenligning skal du oprette en særskilt normaliseret nøgle og beholde originalværdien til visning. Normalisér begge sider af sammenligningen, også værdier, der allerede ligger i databasen. Hvis du kun normaliserer nyt input, forbliver gamle poster uensartede. Før du anvender reglen på alle poster, bør du kontrollere nogle par, som skal matche, og nogle, som skal forblive forskellige.
Hvis resultatet stadig er false, skal du undersøge afsluttende mellemrum, hårde mellemrum eller et andet alfabet. Reagér ikke ved at fjerne alle accenter eller tegnsætning. Det er yderligere matchregler, som kan slå forskellige navne sammen. Hvis en foreslået dubletgruppe vedrører konti, betalinger eller identitet, skal den vises til gennemgang i stedet for at behandle visuel lighed som bevis.
Undgå at ændre ID’er blot for at sammenligne tekst
Et NFC-match beviser ikke, at to konti tilhører samme person. Gennemse foreslåede dubletgrupper, og afgør, hvad et match betyder for dataene. Tilføj ikke normalisering til adgangskoder, signaturer eller uigennemsigtige tokens som tilfældig oprydning: Disse systemer kan kræve præcise aftaler om bytes eller tegn.
Hvorfor ikke bruge NFKC overalt?
NFKC tilføjer kompatibilitetsafbildninger. I den registrerede test var ligaturen U+FB00 uændret under NFC, men blev til ff under NFKC. Det kan hjælpe en bevidst tolerant søgenøgle, men samtidig fjerne en forskel, som skal bevares i originalteksten. Vælg reglen, før du vælger transformationen.
Normalisering løser heller ikke problemet med tegn, der ligner hinanden: Latinsk a og kyrillisk U+0430 forblev forskellige i eksemplet. Den definerer heller ikke en hjemmesides tegngrænse. De to café-former målte 4 og 5 JavaScript UTF-16-kodeenheder; grafemsegmentering af det dekomponerede ord gav 4 grupper for læseren. Det er forskellige målinger.
Kilder, eksempler og videre læsning
- Offentlig diskussion: samme tekst er ikke lig hinanden, hvordan bruges samme kodning?
- Oprindeligt supplerende diagram
- Gemt dokumentation fra lokal test
- MDN-reference: normalize
- Unicode-specifikationen for normalisering
- MDN-reference: length
- Offentlig diskussion: korrekt optælling af længden af en streng med emoji i JavaScript
- Hvorfor tilsyneladende gyldig JSON fejler ved første tegn
- Hvorfor Base64 giver problemer med ikke-engelsk tekst