똑같아 보이는 글자가 일치하지 않는 이유
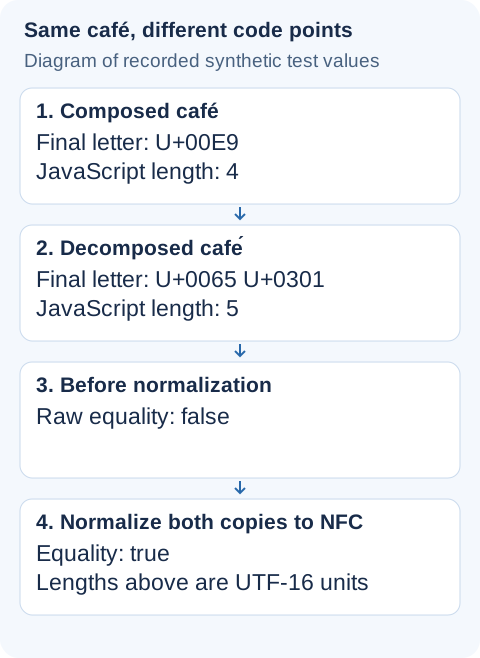
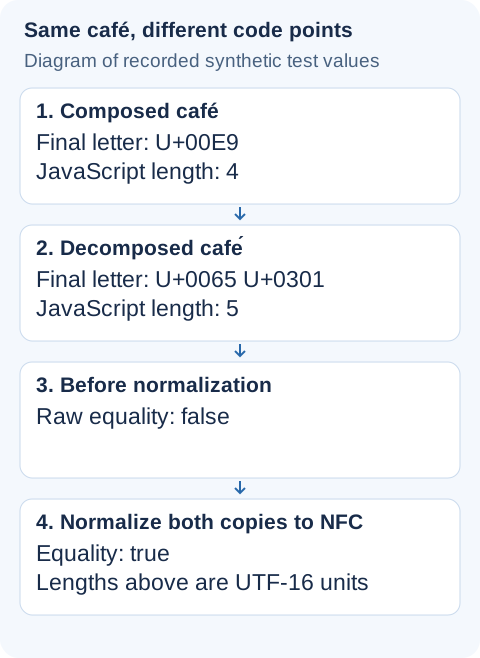
café라는 두 문자열은 화면에서 같아 보여도 비교 결과가 다를 수 있습니다. 하나는 U+00E9로 끝나고, 다른 하나는 U+0065 뒤에 결합 문자 U+0301이 붙어 있을 수 있습니다. 악센트 자체가 잘못된 것이 아닙니다. 저장된 Unicode 배열이 다르므로 비교 규칙에서 이 차이를 다뤄야 합니다.
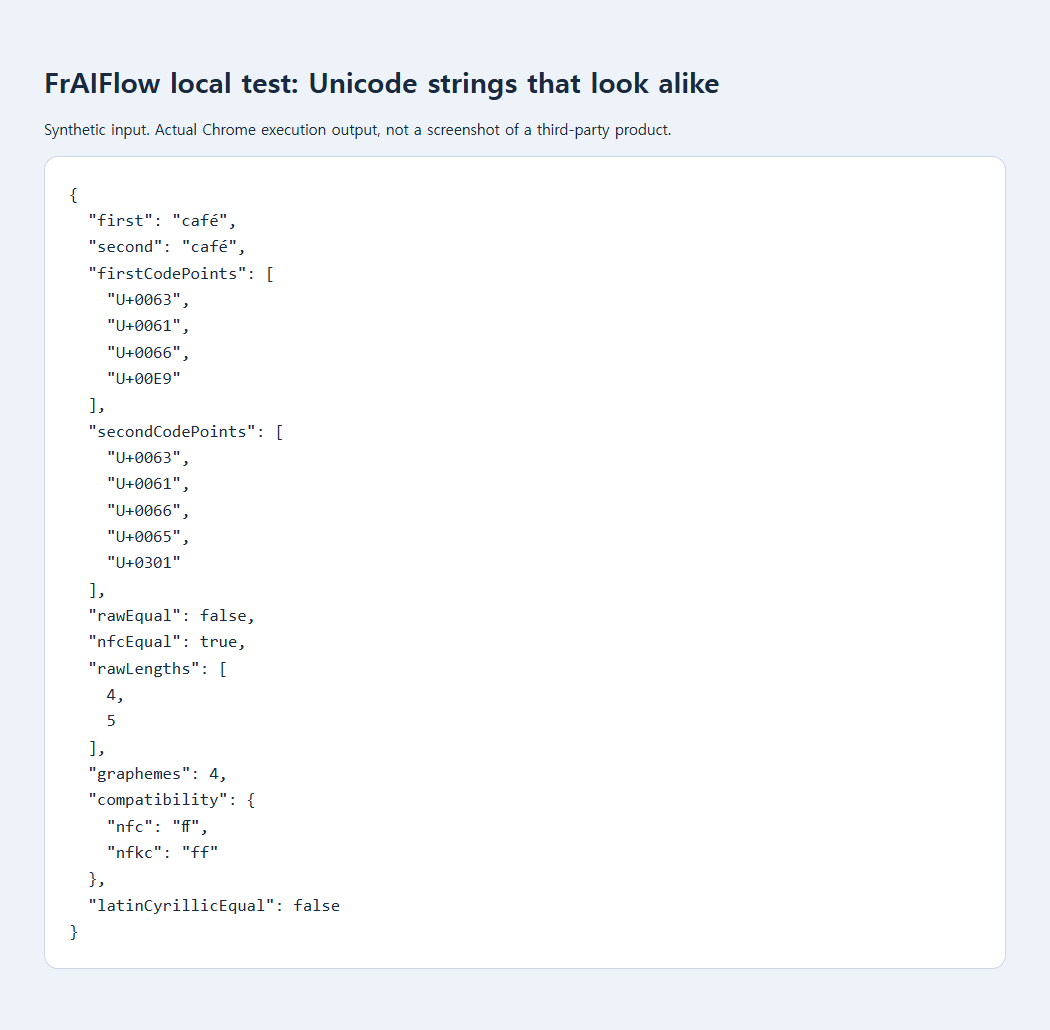
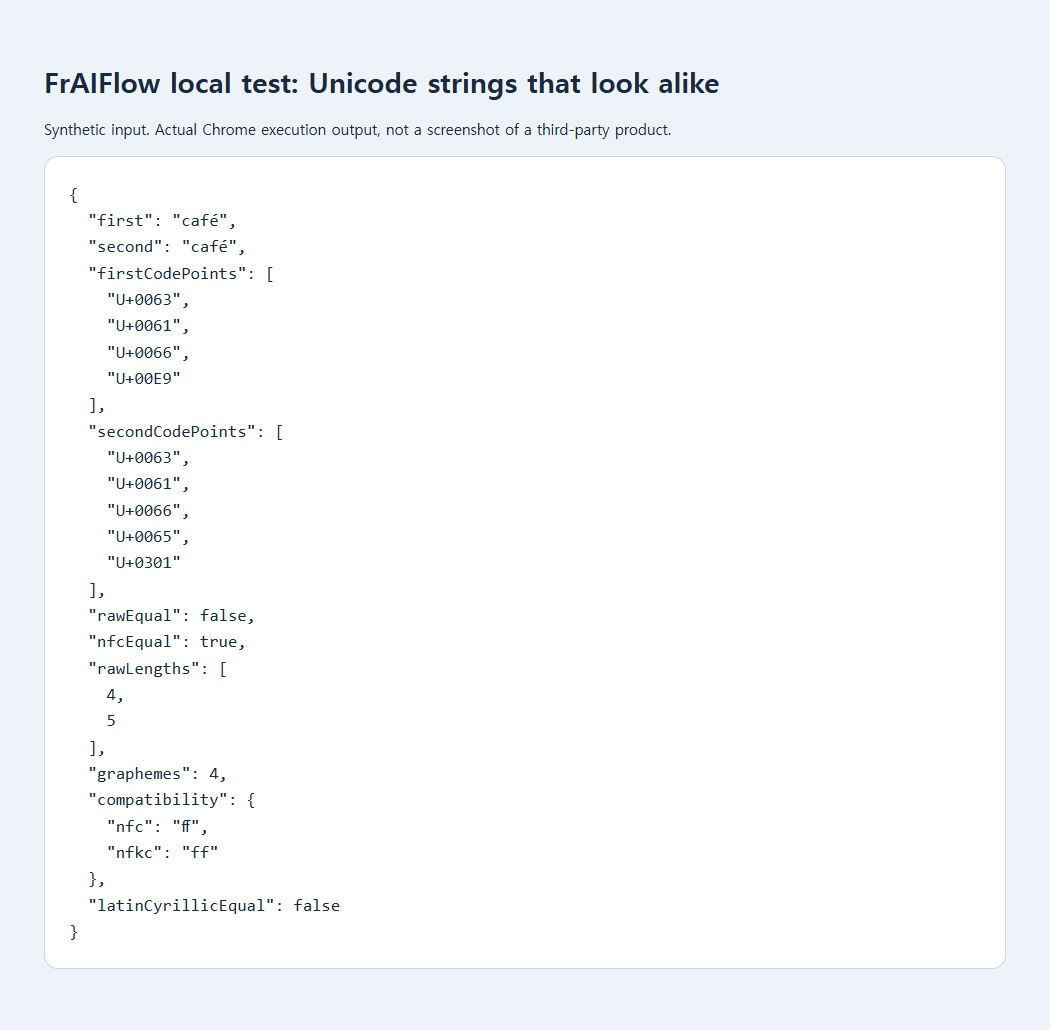
2019년 Stack Overflow에는 비슷하게 보이는 베트남어 문자열의 동등성 비교가 실패한 사례가 올라왔습니다. 답변에서는 같은 정규화 형식을 적용했습니다. 이 글의 브라우저 시험은 별도로 만든 café 문자열 쌍을 사용합니다. 직접 비교는 false였지만 양쪽을 NFC로 정규화한 뒤 비교하면 true였습니다. 사례 작성자의 프로그램을 재현한 결과는 아닙니다.
일치해야 하는 문자열 한 쌍부터 살펴보세요
전체 스프레드시트나 데이터베이스를 바꾸기 전에, 같아야 하는 값 두 개만 작은 로컬 스크립트로 복사하세요. 고객을 식별하는 정보라면 무해한 예시 문자열을 대신 사용합니다. 악센트를 반복해서 다시 입력하는 것보다 코드 포인트를 나란히 확인하는 편이 훨씬 정확합니다.
const typed = "caf\u00E9";
const pasted = "cafe\u0301";
const points = s => Array.from(s, c =>
  "U+" + c.codePointAt(0).toString(16).toUpperCase().padStart(4, "0")
).join(" ");
console.log(points(typed));  // U+0063 U+0061 U+0066 U+00E9
console.log(points(pasted)); // U+0063 U+0061 U+0066 U+0065 U+0301
console.log(typed === pasted); // false
const matches = typed.normalize("NFC") === pasted.normalize("NFC");
console.log(matches); // true
두 배열을 왼쪽부터 비교해 보세요. 여기서는 처음 세 글자는 같고, 마지막 악센트 글자를 저장한 방식만 다릅니다. 바로 NFC가 처리하려는 상황입니다. 아래 그림은 두 저장 방식을 눈에 보이게 표현합니다. 추가 표식은 지워야 할 불필요한 글자가 아니라 앞 글자에 붙는 결합 악센트입니다.
검색이나 가져오기 비교에는 별도의 정규화 키를 만들고, 화면 표시용 원래 값은 보관하세요. 이미 데이터베이스에 있던 값까지 포함해 비교하는 양쪽에 같은 규칙을 적용해야 합니다. 새 입력만 정규화하면 기존 기록과 규칙이 달라집니다. 전체 적용 전에는 같아야 하는 쌍과 반드시 달라야 하는 쌍을 모두 시험하세요.
여전히 false라면 끝 공백, 줄바꿈 없는 공백 또는 다른 문자 체계의 글자가 섞였는지 살펴보세요. 악센트와 구두점을 전부 제거하는 방식으로 대응하지 마세요. 그것은 별도의 일치 정책이며 서로 다른 이름을 합칠 수 있습니다. 계정·결제·신원과 관련된 중복 후보는 검토 대상으로 제시하고, 겉모양이 비슷하다는 이유만으로 동일인으로 처리하지 마세요.
문자열 비교와 신원 확인은 구분해야 합니다
NFC 비교가 일치한다고 두 계정이 같은 사람의 것이라는 뜻은 아닙니다. 합쳐질 후보 그룹을 미리 보고 그 데이터에서 일치가 무엇을 의미하는지 정하세요. 비밀번호·서명·의미를 해석하지 않는 토큰에 정규화를 단순 정리 작업으로 추가하면 안 됩니다. 이런 시스템에는 바이트나 문자가 정확히 같아야 한다는 계약이 있을 수 있습니다.
NFKC를 모든 곳에 쓰면 안 될까요?
NFKC는 호환성 매핑도 적용합니다. 기록된 시험에서는 합자 U+FB00이 NFC에서는 그대로 남고 NFKC에서는 ff로 바뀌었습니다. 일부러 폭넓게 일치시키는 검색 키에는 유용할 수 있지만 원문에서 필요한 차이를 잃을 수도 있습니다. 변환 함수를 고르기 전에 일치 정책부터 정하세요.
정규화는 닮은 문자 문제도 해결하지 않습니다. 예시의 라틴 문자 a와 키릴 문자 U+0430은 여전히 달랐습니다. 웹사이트의 글자 수 제한도 정규화가 정해 주지 않습니다. 두 café 표현은 JavaScript UTF-16 코드 단위로 각각 4와 5였지만, 분해된 표현을 사용자가 읽는 글자 단위로 나누면 4그룹이었습니다. 서로 다른 측정 기준입니다.