Base64 변환에서 한글과 이모지가 깨지는 이유
btoa()가 Hello는 처리하지만 한글이나 이모지에서 실패한다면, 대개 빠진 단계는 문자 인코딩입니다. Base64는 바이트를 표현합니다. JavaScript 문자열을 먼저 약속한 방식으로 바이트로 변환하고, 받는 프로그램도 그 과정을 반대로 수행해야 합니다.
공개 사례 중 하나는 비라틴 문자가 들어간 SVG 마크업을 다뤘고, 다른 사례는 GitHub API 콘텐츠를 디코딩한 뒤 상표 기호가 깨지는 문제였습니다. 하나는 문자를 바이트로 바꾸는 과정에서, 다른 하나는 바이트를 문자로 되돌리는 과정에서 생긴 문제입니다. atob() 호출이 성공해도 결과는 바이너리 문자열일 뿐, 곧바로 읽을 수 있는 UTF-8 텍스트는 아닙니다.
UTF-8 왕복 변환을 완성하세요
Base64를 만드는 코드를 관리한다면 오류를 일으킨 문자를 지우지 말고 텍스트와 바이트가 만나는 부분을 수정하세요. 아래 브라우저 JavaScript 함수는 이 경계를 분명하게 처리합니다. 비교적 작은 텍스트용이며 대용량 업로드를 위한 구현은 아닙니다.
function encodeUtf8Base64(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
function decodeUtf8Base64(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, c => c.charCodeAt(0));
  return new TextDecoder("utf-8", {
    fatal: true, ignoreBOM: true
  }).decode(bytes);
}
const original = "Hello, 한글 ™ 🌍";
const encoded = encodeUtf8Base64(original);
const restored = decodeUtf8Base64(encoded);
console.log(encoded); // SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==
console.log(restored === original); // true
기존 변환 코드 옆에 함수를 두고 실제 콘텐츠를 넣기 전에 예시부터 시험하세요. 동등성 비교 결과가 true여야 합니다. false라면 인코딩 전 문자열과 디코딩 후 문자열을 비교하세요. 출력이 Base64처럼 보인다는 사실만으로 성공을 판단하지 마세요. 악센트 글자, 이모지, 빈 문자열도 시험에 포함합니다.
받기만 하는 입장이라면 보내는 쪽에서 어떤 바이트를 인코딩했는지 확인하세요. Base64 문자만으로 UTF-8인지 알아낼 수 없습니다. Base64 디코딩은 성공했지만 UTF-8에서 오류가 난다면 다른 문자 인코딩이거나 텍스트가 아닌 파일일 수 있습니다. PNG나 PDF라면 텍스트 디코더를 적용하지 말고 디코딩된 바이트를 바이너리로 보존하세요.
사용자용 도구에서는 잘못된 입력 오류를 잡아 설명하고 원래 입력을 수정할 수 있게 남겨 두세요. 실패한 디코딩을 빈 결과의 성공으로 바꾸면 안 됩니다. 비공개 토큰은 모르는 온라인 변환기에 붙여 넣지 마세요. Base64는 내용을 옮기기 쉽게 할 뿐 비밀로 만들어 주지 않습니다.
ASCII만 시험하면 놓치는 문제
디코더 옵션 두 가지에 주의하세요. fatal: true는 잘못된 UTF-8을 대체 문자로 조용히 바꾸지 않고 거부합니다. ignoreBOM: true는 맨 앞 텍스트 표식을 유지합니다. TextEncoder는 짝이 없는 UTF-16 서로게이트를 대체하므로, 가능한 모든 JavaScript 문자열에 대해 무손실인 변환은 아닙니다.
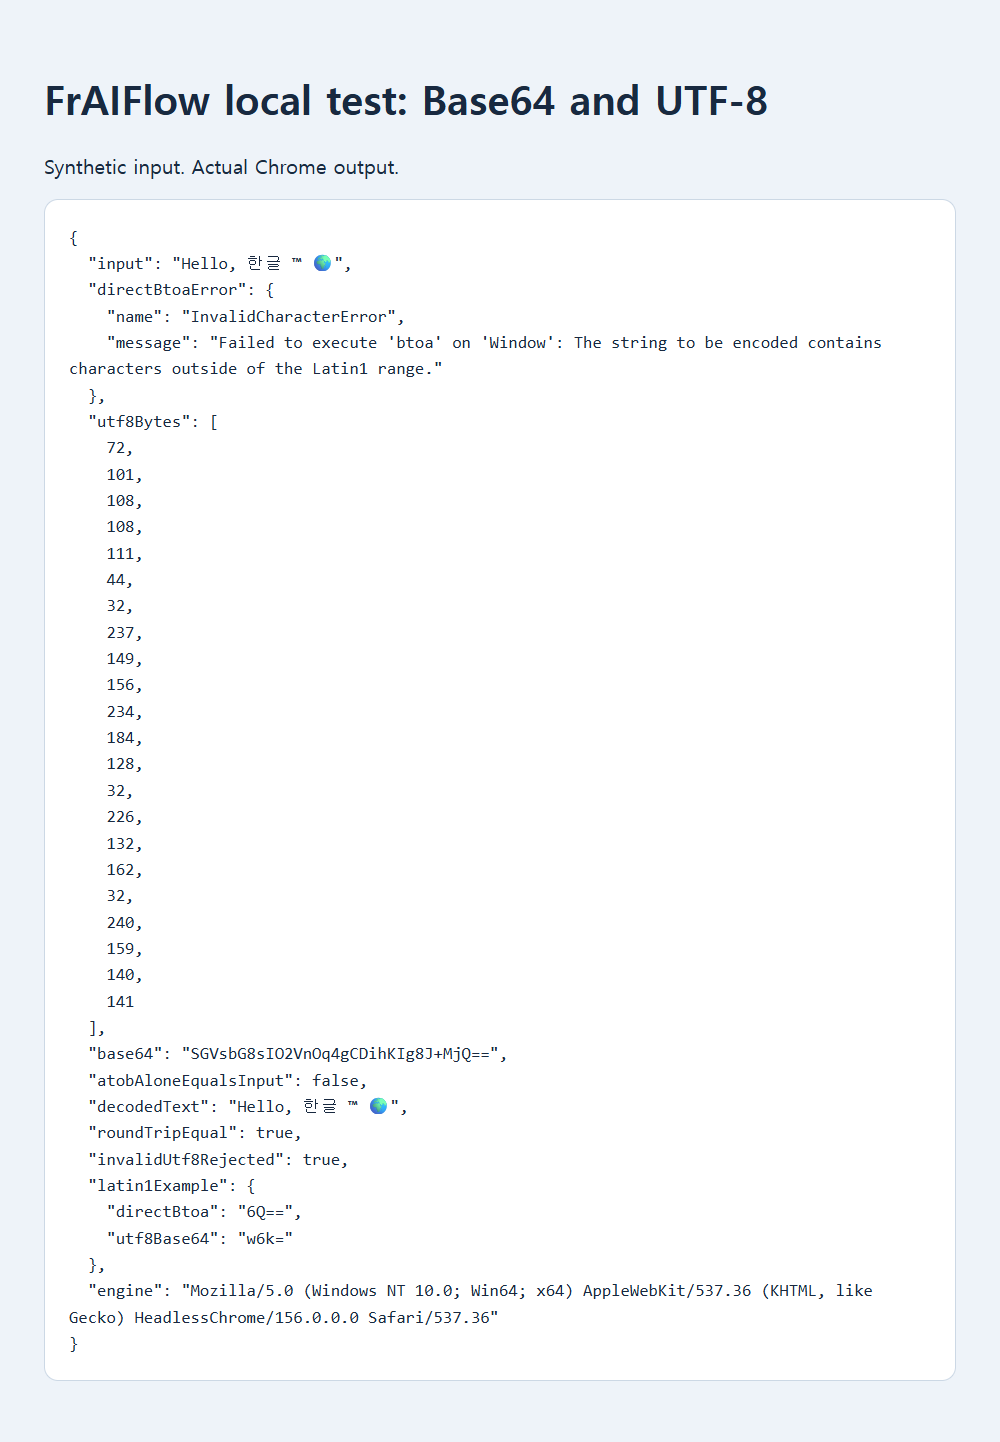
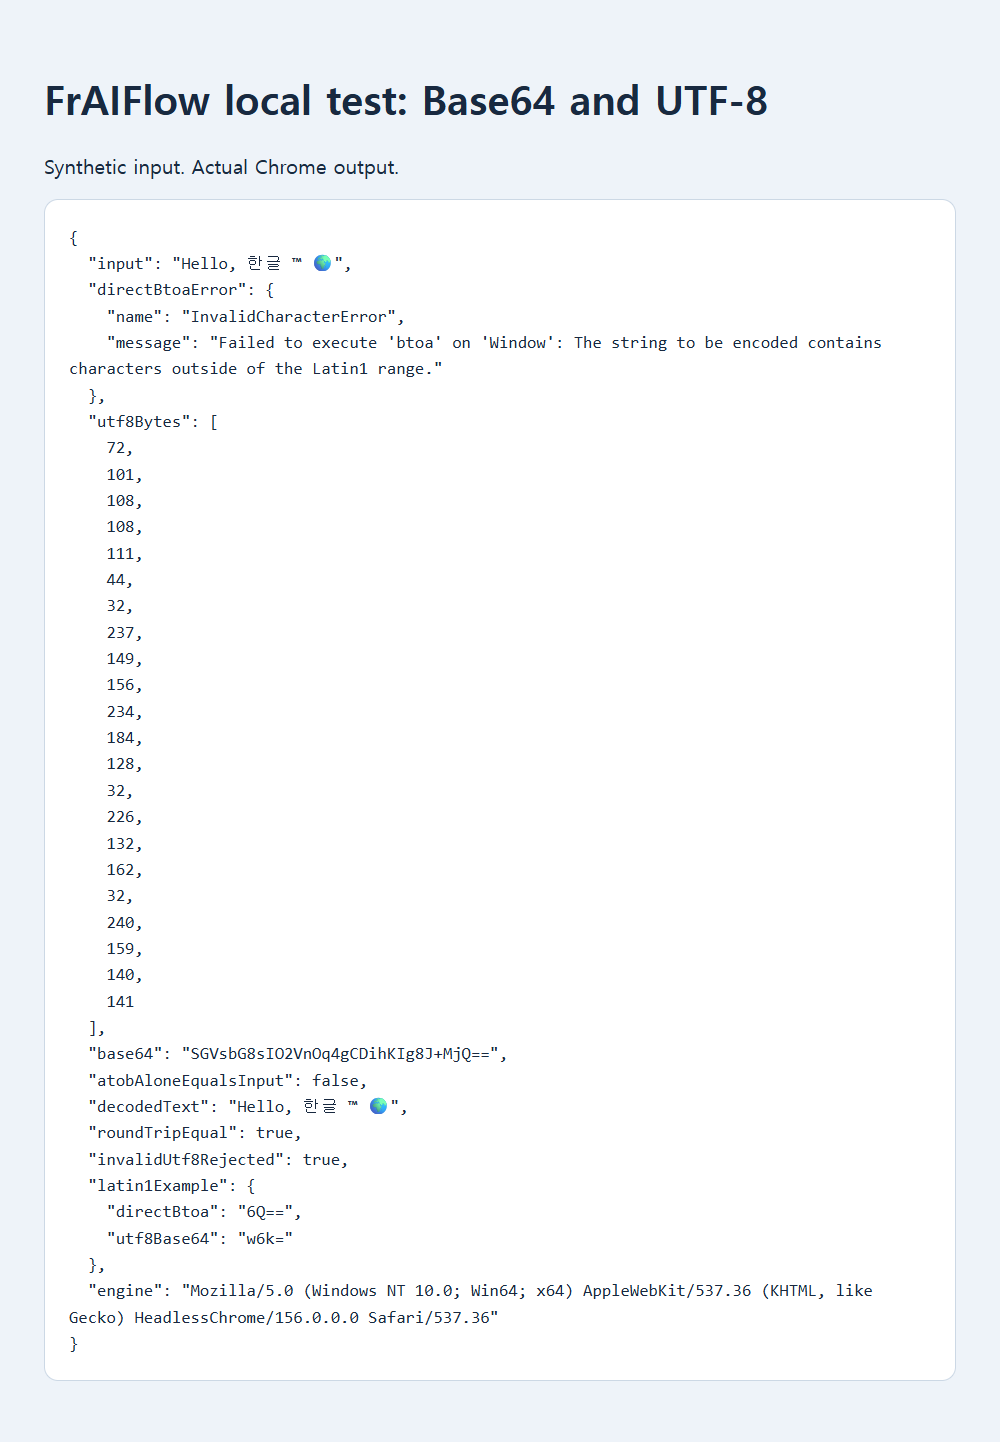
저장된 로컬 브라우저 시험에는 Hello, 한글 ™ 🌍를 사용했습니다. btoa()를 직접 호출하면 InvalidCharacterError가 발생했습니다. TextEncoder는 UTF-8 22바이트를 만들었고, 이를 Base64로 변환한 결과는 SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==였습니다. 바이트를 UTF-8로 다시 읽자 문장이 정확히 복원됐습니다. 별도로 만든 로컬 시험이며 앞서 소개한 사용자의 프로그램을 시험한 것은 아닙니다.
ASCII만 시험하면 버그가 드러나지 않을 수 있습니다. 예시에서 btoa("é")는 6Q==를 반환했지만, UTF-8 인코딩을 먼저 하면 w6k=였습니다. 첫 호출도 오류는 없었으나 UTF-8을 기대하는 수신자에게는 잘못된 바이트입니다. Base64 자체에는 문자 인코딩 선언이 들어 있지 않습니다.
디코딩한 뒤 원문과 비교하세요
Base64는 암호화도 URL 이스케이프도 아닙니다. 쿼리 매개변수에서 더하기 기호는 특별한 의미로 처리될 수 있으므로 연결된 쿼리 매개변수 안내를 확인하세요. 폐기된 unescape 우회법은 피하고, 현실적인 입력 크기 제한을 두세요. 인코딩 오류를 보여주기 위해 비공개 콘텐츠를 공개할 필요는 없습니다.