Por qué Base64 falla con texto no inglés
Si btoa() admite Hello, pero falla con texto coreano o emojis, normalmente falta un paso: codificar el texto. Base64 representa bytes. Primero hay que acordar cómo convertir una cadena de JavaScript en bytes; después, la aplicación receptora debe deshacer esa conversión.
En una consulta pública, el problema aparecía en código SVG con caracteres no latinos; en otra, al decodificar contenido de la API de GitHub, el símbolo de marca comercial salía ilegible. Son dos caras del mismo problema. Que atob() termine sin errores solo significa que ha devuelto una cadena binaria, no necesariamente texto UTF-8 legible.
Complete el recorrido de ida y vuelta con UTF-8
Si mantiene el código que genera el Base64, corrija la conversión entre texto y bytes en lugar de borrar los caracteres que provocan el error. Estas funciones para JavaScript en el navegador hacen explícita esa separación. Están pensadas para textos de tamaño moderado, no para subir archivos grandes.
function encodeUtf8Base64(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
function decodeUtf8Base64(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, c => c.charCodeAt(0));
  return new TextDecoder("utf-8", {
    fatal: true, ignoreBOM: true
  }).decode(bytes);
}
const original = "Hello, 한글 ™ 🌍";
const encoded = encodeUtf8Base64(original);
const restored = decodeUtf8Base64(encoded);
console.log(encoded); // SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==
console.log(restored === original); // true
Coloque estas funciones junto al código de conversión existente y pruebe el ejemplo antes de usar contenido real. La comparación de igualdad debe devolver true. Si devuelve false, compare la cadena anterior a la codificación con la obtenida al decodificar: no basta con que el resultado «parezca Base64». Incluya en las pruebas una letra acentuada, un emoji y una cadena vacía.
Si solo recibe los datos, averigüe qué bytes codificó el emisor. El alfabeto Base64 no permite deducir que se utilizó UTF-8. Si Base64 se decodifica correctamente, pero falla la interpretación como UTF-8, puede tratarse de otra codificación o de un archivo que no contiene texto. Para un PNG o un PDF, conserve los bytes como datos binarios en lugar de pasarlos por un decodificador de texto.
En una herramienta para usuarios, capture los errores de entrada mal formada y conserve el contenido original para que pueda corregirse. No presente una salida vacía como si la conversión hubiera funcionado. Tampoco pegue tokens privados en un conversor desconocido: Base64 facilita transportar contenido, pero no lo mantiene secreto.
Por qué las pruebas solo con ASCII no detectan el problema
Conviene prestar atención a dos opciones del decodificador: fatal: true rechaza UTF-8 no válido en lugar de sustituir silenciosamente los caracteres defectuosos; ignoreBOM: true conserva un marcador inicial de texto. TextEncoder sustituye las unidades UTF-16 que deberían formar una pareja pero aparecen solas (surrogates sin pareja), de modo que esta conversión no preserva sin pérdidas todas las cadenas posibles de JavaScript.
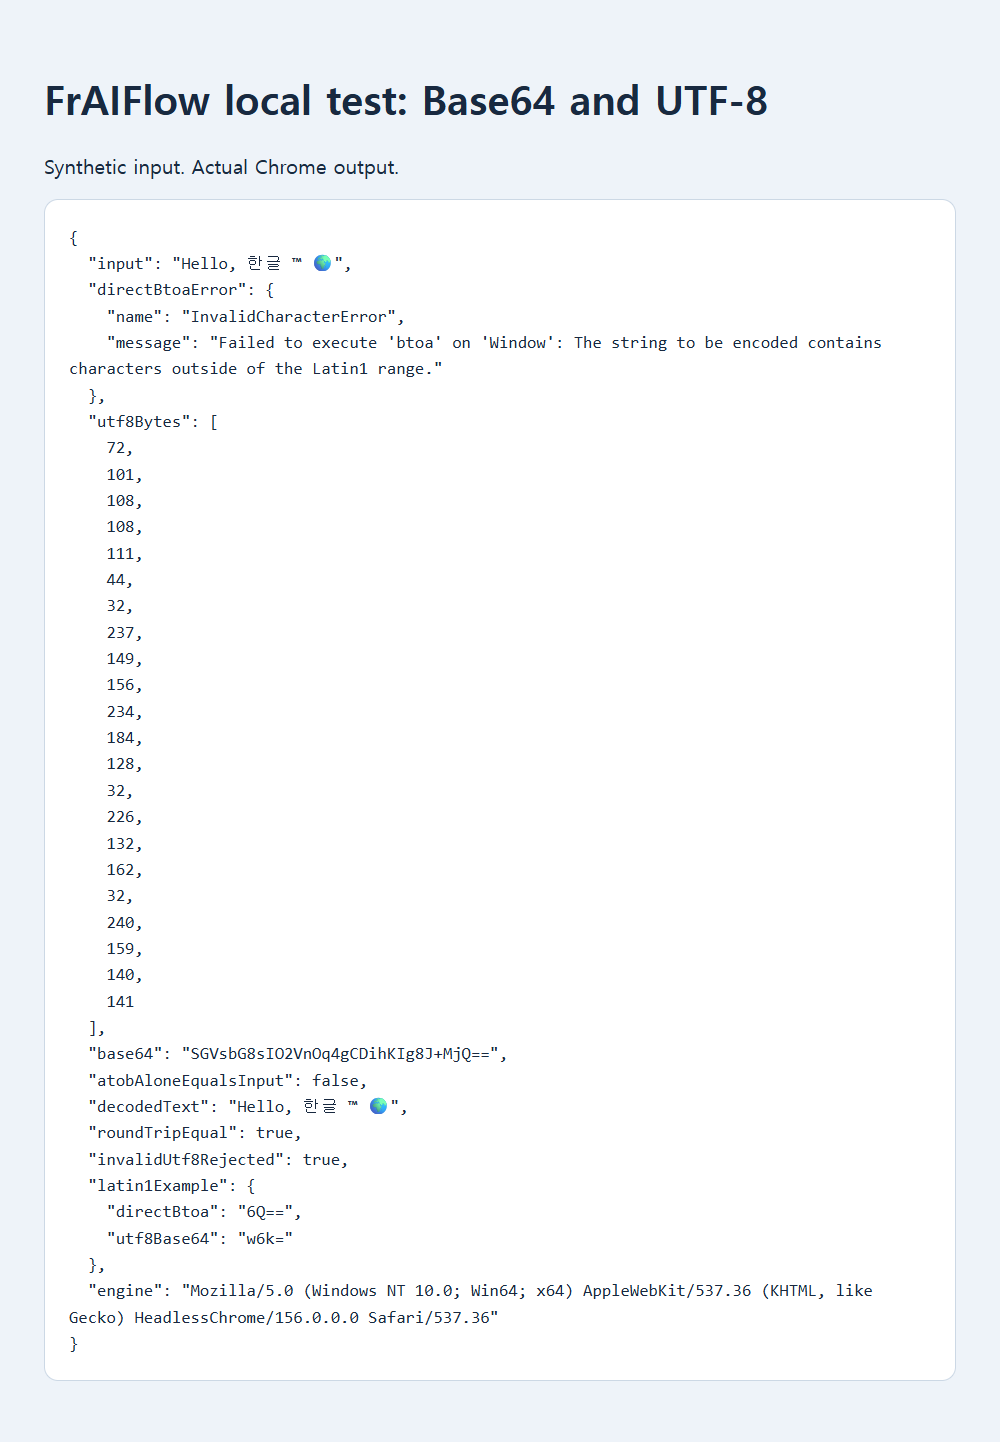
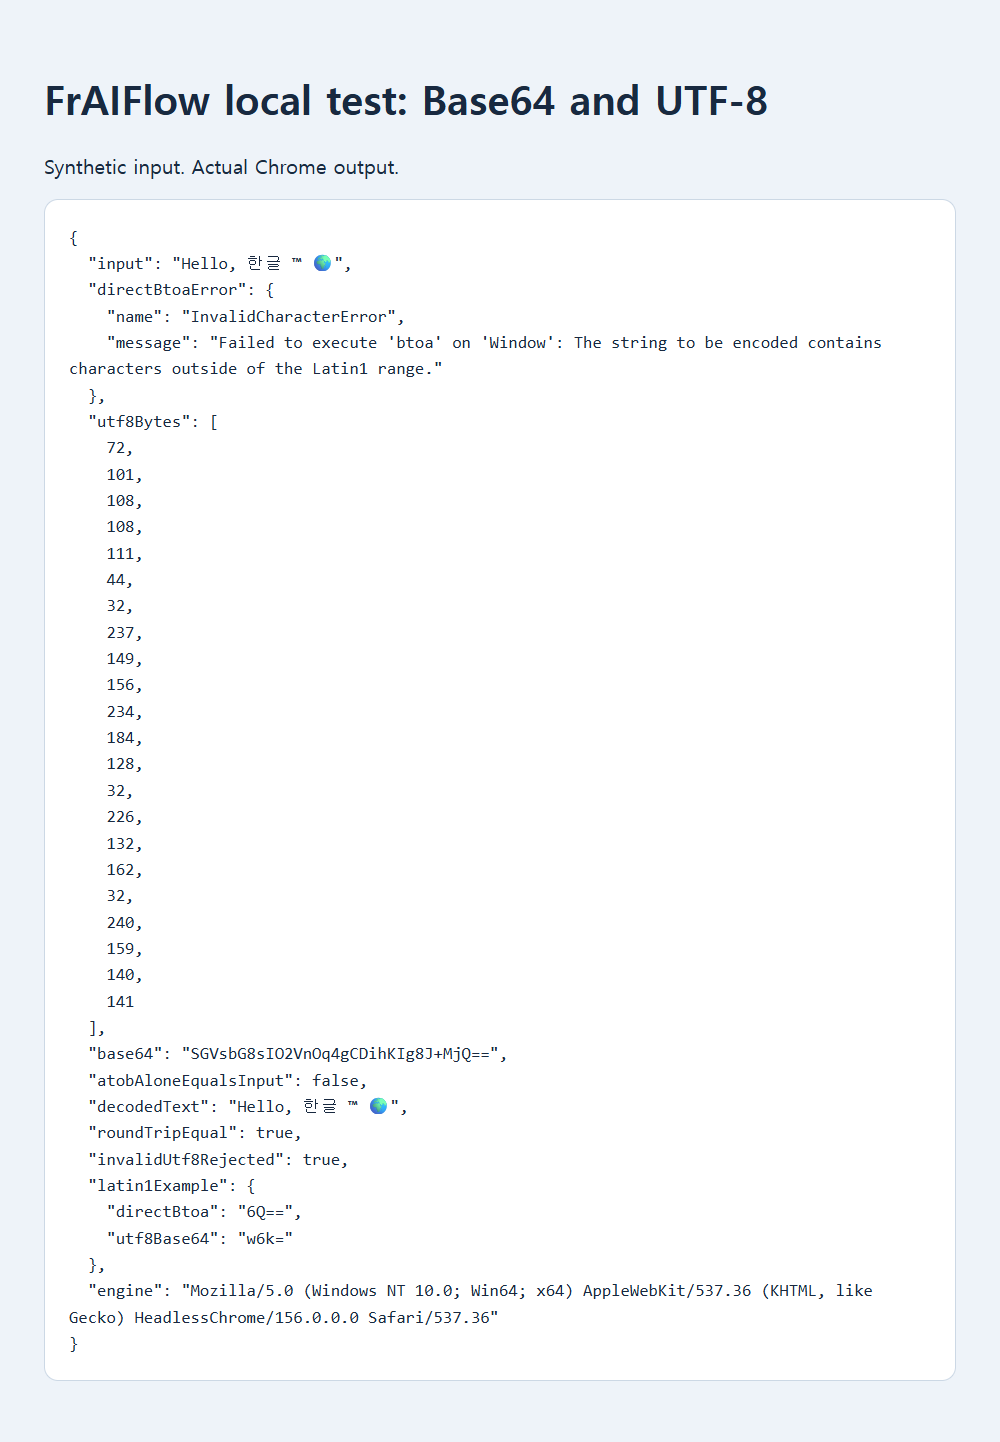
En una prueba local de navegador guardada se usó Hello, 한글 ™ 🌍. La llamada directa a btoa() lanzó InvalidCharacterError. TextEncoder produjo 22 bytes UTF-8, que se codificaron como SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==. Al interpretar de nuevo esos bytes como UTF-8, se recuperó la frase exacta. Es una prueba local con datos sintéticos, no la aplicación de ninguna de las personas que publicaron las consultas.
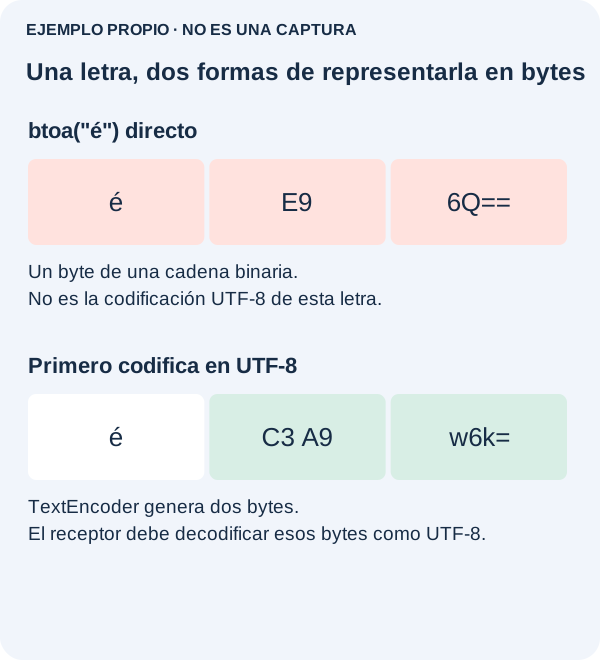
Probar solo con ASCII puede ocultar el fallo. En el ejemplo, btoa("é") devolvió 6Q==, mientras que codificar primero en UTF-8 produjo w6k=. La primera llamada no lanzó ninguna excepción, pero sus bytes no son correctos para un receptor que espera UTF-8. Base64 no incluye una declaración de codificación de caracteres.
Decodifique y compruebe que recupera el original
Base64 no es cifrado ni escape de URL. El signo más puede tener un significado especial en los parámetros de consulta; consulte la guía enlazada sobre este caso. Evite el recurso obsoleto a unescape, establezca límites razonables de tamaño y nunca exponga contenido privado solo para demostrar un error de codificación.
Fuentes, ejemplos y lecturas relacionadas
- Consulta pública: la codificación Base64 falla con caracteres no latinos
- Consulta pública: atob de JavaScript no decodifica correctamente cadenas UTF-8
- Referencia de MDN: btoa
- Diagrama explicativo original
- Evidencia guardada de la prueba local
- Referencia de MDN: TextEncoder
- Referencia de MDN: atob
- Referencia de MDN: TextDecoder
- Referencia de MDN: ignoreBOM
- Referencia de MDN: decode
- Referencia de MDN: unescape
- Guía relacionada: Base64 en parámetros de consulta
- Por qué un JSON aparentemente válido falla en el primer carácter
- Por qué dos textos visualmente idénticos no coinciden