Hvorfor Base64 skaper problemer for tekst som ikke er engelsk
Hvis btoa() håndterer Hello, men feiler på koreansk tekst eller emoji, mangler som regel et steg for tegnkoding. Base64 representerer byte. En JavaScript-streng må først konverteres til byte på en avtalt måte, og mottakerprogrammet må gjøre den motsatte konverteringen.
En offentlig feilrapport handlet om SVG-kode med ikke-latinske tegn. En annen gjaldt GitHub API-innhold der et varemerkesymbol ble feil etter dekoding. Dette er to sider av den samme overgangen. Et vellykket atob()-kall returnerer en binær streng, ikke automatisk lesbar UTF-8-tekst.
Kod teksten som UTF-8 og kontroller at den kan gjenopprettes
Hvis du vedlikeholder koden som lager Base64-verdien, retter du overgangen fra tekst til binærdata i stedet for å fjerne tegnene som utløser feilen. Disse JavaScript-hjelpefunksjonene for nettleseren gjør overgangen tydelig. De er beregnet på forholdsvis små tekstmengder, ikke store opplastinger.
function encodeUtf8Base64(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
function decodeUtf8Base64(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, c => c.charCodeAt(0));
  return new TextDecoder("utf-8", {
    fatal: true, ignoreBOM: true
  }).decode(bytes);
}
const original = "Hello, 한글 ™ 🌍";
const encoded = encodeUtf8Base64(original);
const restored = decodeUtf8Base64(encoded);
console.log(encoded); // SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==
console.log(restored === original); // true
Plasser hjelpefunksjonene ved den eksisterende konverteringskoden, og test eksemplet før du setter inn virkelig innhold. Likhetskontrollen skal være true. Er den false, sammenligner du strengene før koding og etter dekoding. Ikke vurder resultatet bare ut fra om det «ser ut som Base64». Ta med en bokstav med aksent, en emoji og en tom streng i testene.
Hvis du bare mottar data, må du spørre hvilke byte avsenderen kodet. Base64-alfabetet kan ikke fortelle deg at teksten er UTF-8. Vellykket Base64-dekoding etterfulgt av en UTF-8-feil kan bety at en annen tegnkoding er brukt, eller at filen ikke er tekst. For PNG eller PDF skal de dekodede bytene bevares som binærdata, ikke kjøres gjennom en tekstdekoder.
I et brukerverktøy bør feil ved ugyldig inndata fanges opp, og originalteksten bør fortsatt kunne redigeres. Ikke erstatt en mislykket dekoding med et tomt resultat merket som vellykket. Lim aldri inn private token i en ukjent nettjeneste for konvertering. Base64 gjør innhold lettere å overføre, ikke hemmelig.
Derfor overser tester med bare ASCII problemet
To dekodervalg fortjener oppmerksomhet: fatal: true avviser ugyldig UTF-8 i stedet for å sette inn erstatningstegn uten varsel; ignoreBOM: true bevarer en innledende tekstmarkør. TextEncoder erstatter et uparet UTF-16-surrogat, så dette er ikke en tapsfri omforming av alle mulige JavaScript-strenger.
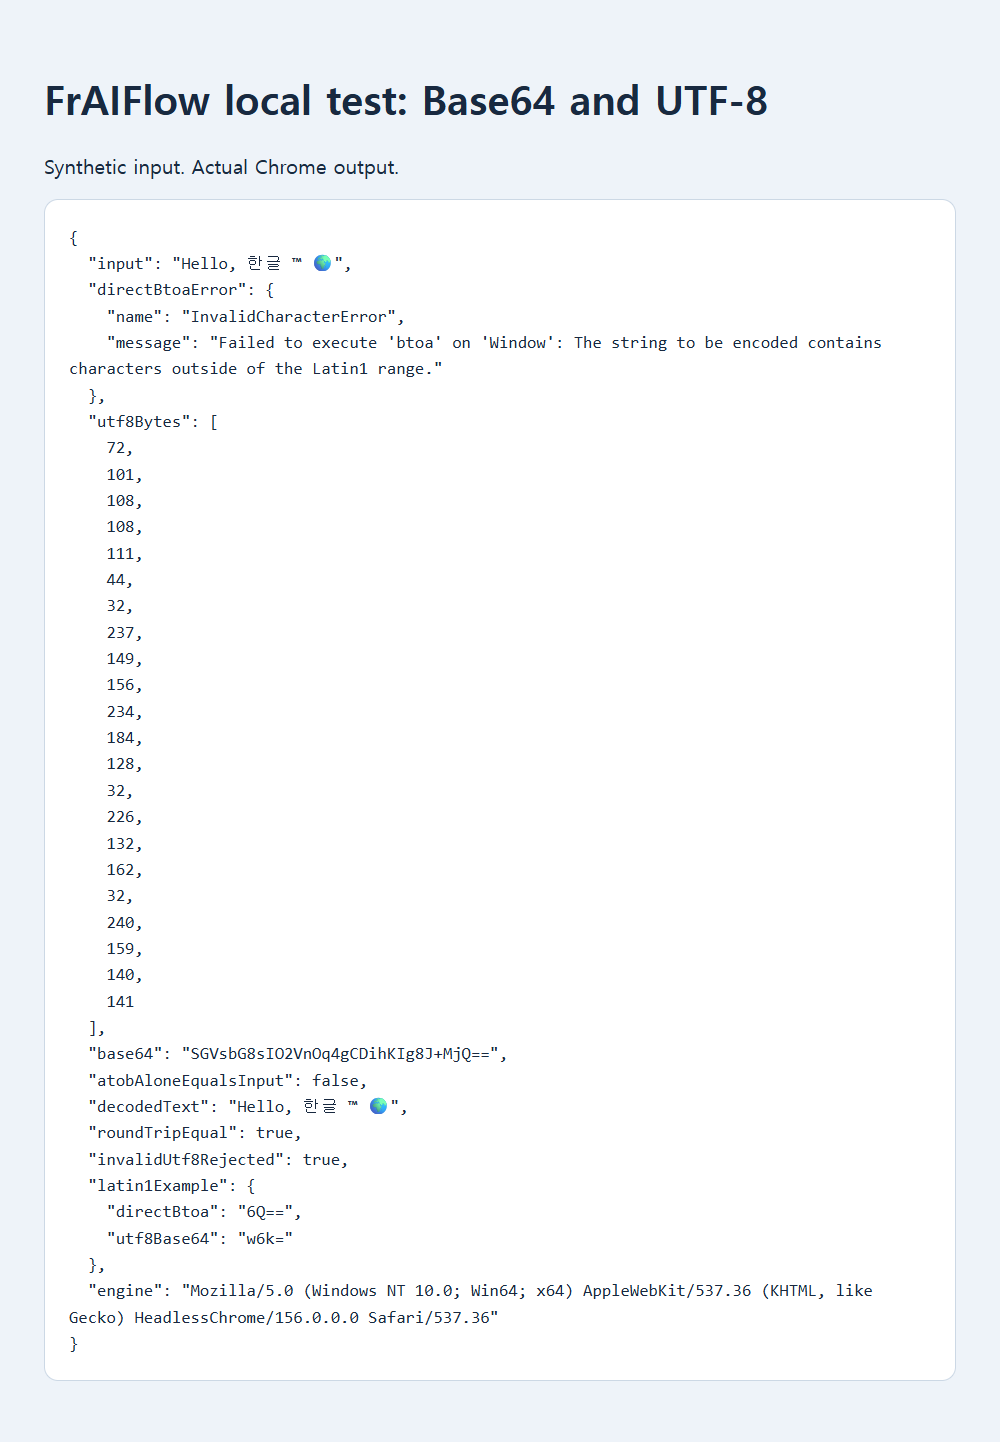
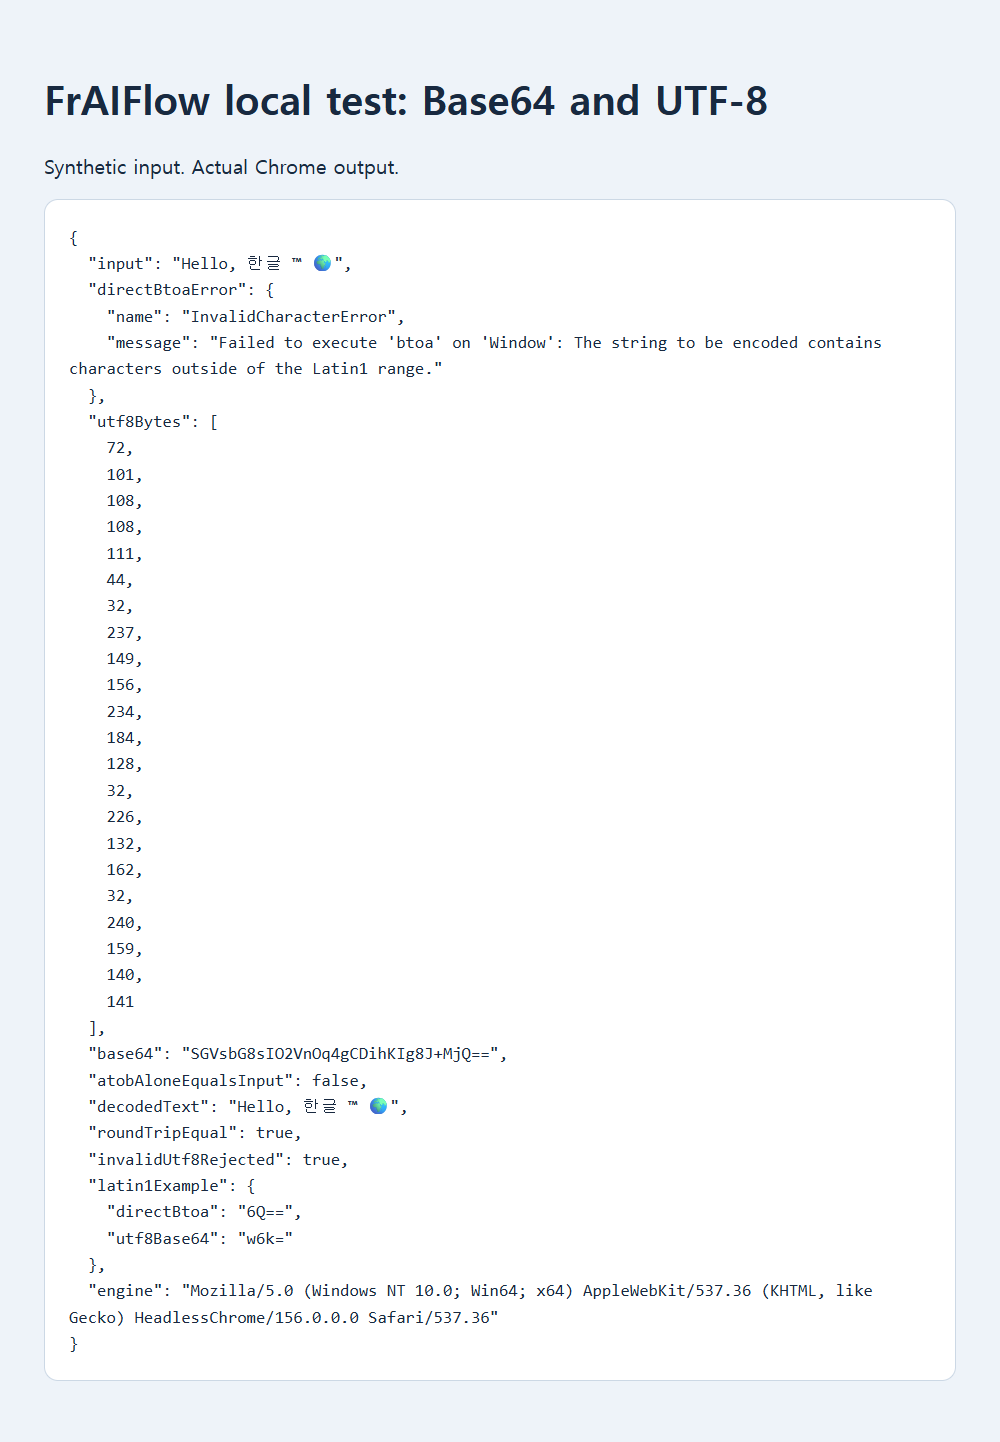
En lagret lokal nettlesertest brukte Hello, 한글 ™ 🌍. Direkte btoa() kastet InvalidCharacterError. TextEncoder produserte 22 UTF-8-byte, som ble kodet til SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==. Da bytene ble dekodet som UTF-8, kom nøyaktig samme setning tilbake. Dette er en syntetisk lokal test, ikke programmet til noen av de to personene som rapporterte problemet.
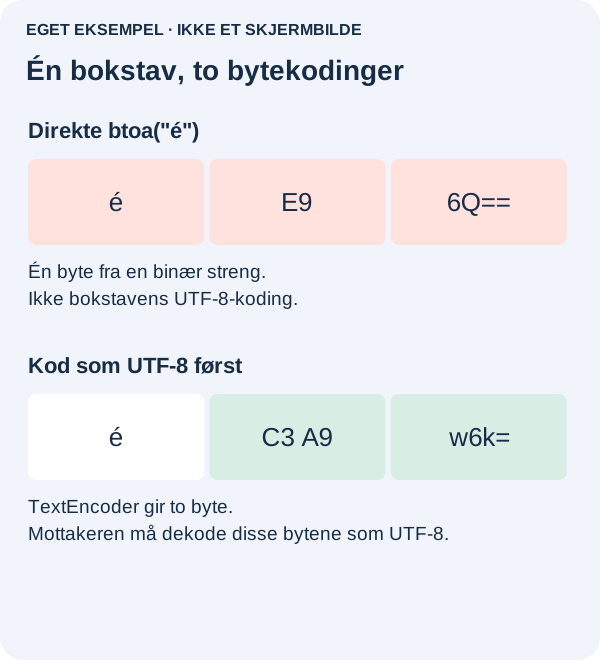
Testing med bare ASCII kan skjule en feil. I eksemplet returnerte btoa("é") verdien 6Q==, mens UTF-8-koding først ga w6k=. Det første kallet kastet ingen feil, men bytene er feil for en mottaker som forventer UTF-8. Base64 inneholder ingen erklæring om tegnkoding.
Dekod og kontroller at teksten kommer uendret tilbake
Base64 er verken kryptering eller URL-escaping. Et plusstegn kan tolkes spesielt i URL-parametere. Følg veiledningen om søkeparametere som er lenket nedenfor. Unngå den foreldede unescape-omveien, sett fornuftige størrelsesgrenser, og ikke eksponer privat innhold bare for å vise en tegnkodingsfeil.
Kilder, eksempler og videre lesning
- Offentlig diskusjon: Base64-koding feiler for ikke-latinske tegn
- Offentlig diskusjon: JavaScripts atob dekoder ikke UTF-8-strenger riktig
- MDN-referanse: btoa
- Opprinnelig støttediagram
- Lagret dokumentasjon fra lokal test
- MDN-referanse: TextEncoder
- MDN-referanse: atob
- MDN-referanse: TextDecoder
- MDN-referanse: ignoreBOM
- MDN-referanse: decode
- MDN-referanse: unescape
- Relatert veiledning: Base64 i en URL-parameter
- Hvorfor JSON som ser gyldig ut, feiler på første tegn
- Hvorfor tekst som ser lik ut, ikke samsvarer