Warum btoa() bei Unicode-Zeichen scheitert
Verarbeitet btoa() das Wort Hello, scheitert aber an koreanischem Text oder Emojis, fehlt meist der Schritt der Zeichenkodierung. Base64 stellt Bytes dar. Eine JavaScript-Zeichenfolge muss zuerst nach einer vereinbarten Kodierung in Bytes umgewandelt werden. Die empfangende Anwendung muss diesen Schritt wieder umkehren.
Ein öffentlicher Bericht betraf SVG-Markup mit nicht lateinischen Zeichen. In einem anderen wurde Inhalt aus der GitHub-API dekodiert, wobei ein Markenzeichen verstümmelt erschien. In beiden Fällen liegt das Problem bei der Umwandlung zwischen Text und Bytes. Ein erfolgreicher atob()-Aufruf liefert eine binäre Zeichenfolge, nicht automatisch lesbaren UTF-8-Text.
Prüfen Sie den vollständigen Weg über UTF-8 und zurück
Wenn Sie den Code pflegen, der Base64 erzeugt, korrigieren Sie die Umwandlung von Text in Bytes, statt die Zeichen zu entfernen, die den Fehler auslösen. Die folgenden JavaScript-Hilfsfunktionen für den Browser machen diesen Übergang ausdrücklich sichtbar. Sie sind für überschaubare Textmengen gedacht, nicht für große Uploads.
function encodeUtf8Base64(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = "";
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
function decodeUtf8Base64(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, c => c.charCodeAt(0));
  return new TextDecoder("utf-8", {
    fatal: true, ignoreBOM: true
  }).decode(bytes);
}
const original = "Hello, 한글 ™ 🌍";
const encoded = encodeUtf8Base64(original);
const restored = decodeUtf8Base64(encoded);
console.log(encoded); // SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ==
console.log(restored === original); // true
Fügen Sie die Hilfsfunktionen neben Ihrem bisherigen Konvertierungscode ein und testen Sie zunächst das Beispiel, bevor Sie echte Inhalte einsetzen. Die Gleichheitsprüfung sollte true ergeben. Falls nicht, vergleichen Sie die Zeichenfolgen vor dem Kodieren und nach dem Dekodieren. Beurteilen Sie den Erfolg nicht nur danach, ob die Ausgabe „nach Base64 aussieht“. Nehmen Sie einen Buchstaben mit Akzent, ein Emoji und eine leere Zeichenfolge in Ihre Tests auf.
Wenn Sie Daten nur empfangen, klären Sie, welche Bytes der Absender kodiert hat. Das Base64-Alphabet verrät Ihnen nicht, ob UTF-8 verwendet wurde. Gelingt die Base64-Dekodierung, während die UTF-8-Dekodierung scheitert, kann eine andere Textkodierung oder eine Binärdatei vorliegen. Bei PNG oder PDF behalten Sie die dekodierten Bytes als Binärdaten, statt sie durch einen Textdecoder zu schicken.
Fangen Sie in einem Werkzeug für Endnutzer Fehler durch ungültige Eingaben ab und lassen Sie die ursprüngliche Eingabe zur Bearbeitung stehen. Ersetzen Sie einen fehlgeschlagenen Dekodierungsversuch nicht durch ein leeres, scheinbar erfolgreiches Ergebnis. Fügen Sie niemals private Tokens in unbekannte Online-Konverter ein: Base64 macht Inhalte übertragbar, nicht geheim.
Warum reine ASCII-Tests das Problem übersehen
Zwei Decoder-Optionen verdienen Aufmerksamkeit: fatal: true weist ungültiges UTF-8 zurück, statt unbemerkt Ersatzzeichen einzusetzen; ignoreBOM: true erhält eine führende Textmarkierung. Einen einzelnen, ungepaarten UTF-16-Surrogatwert ersetzt TextEncoder. Für jede denkbare JavaScript-Zeichenfolge ist dies deshalb keine verlustfreie Umwandlung.
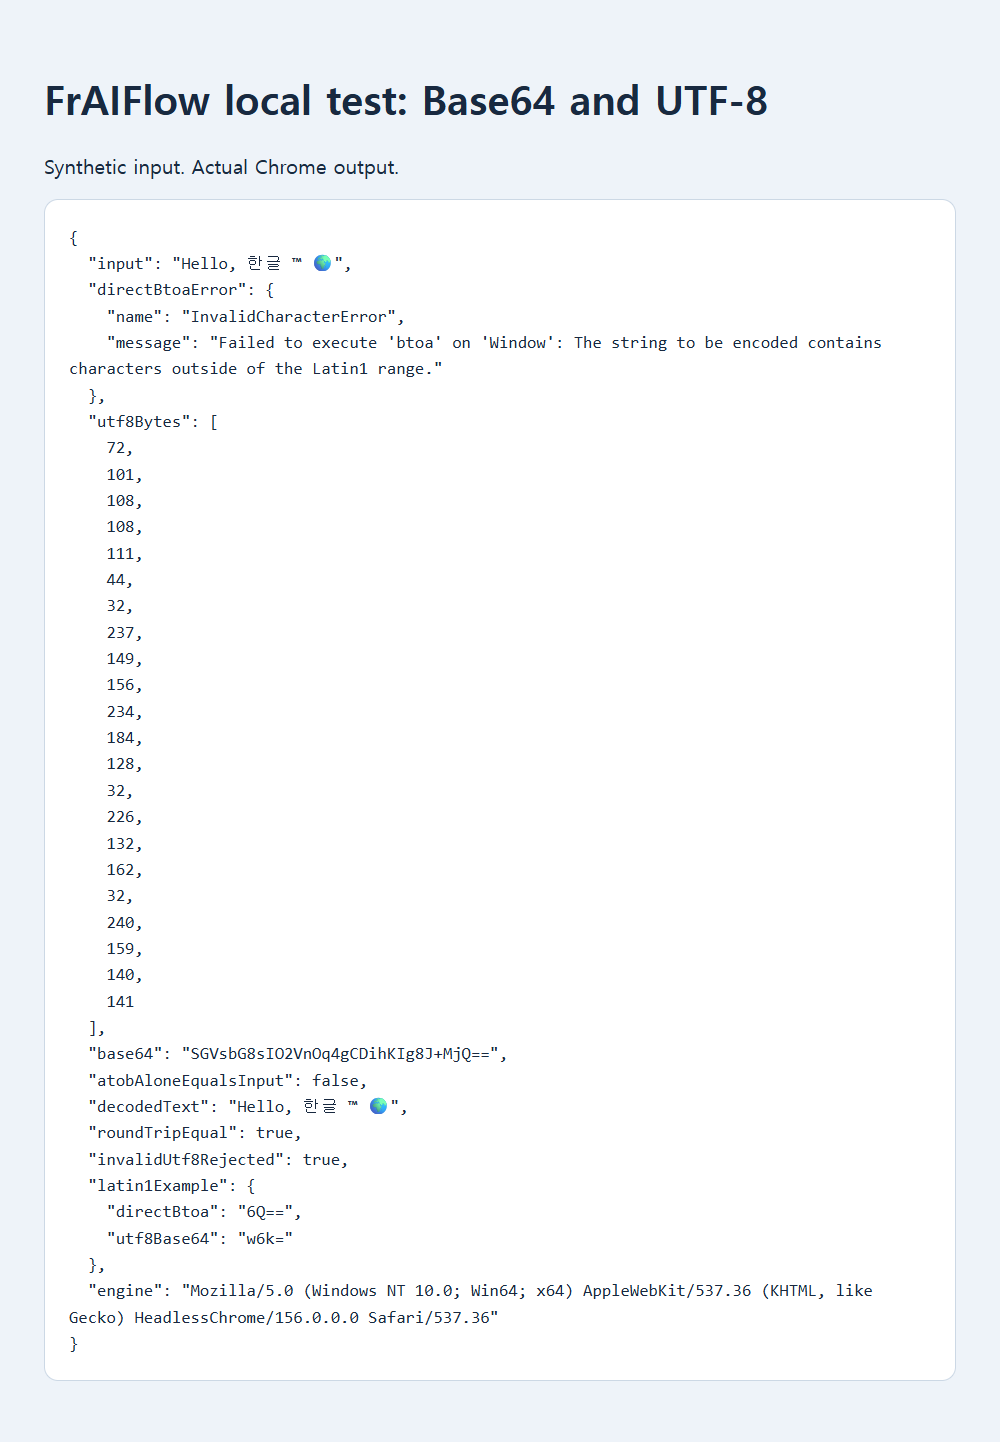
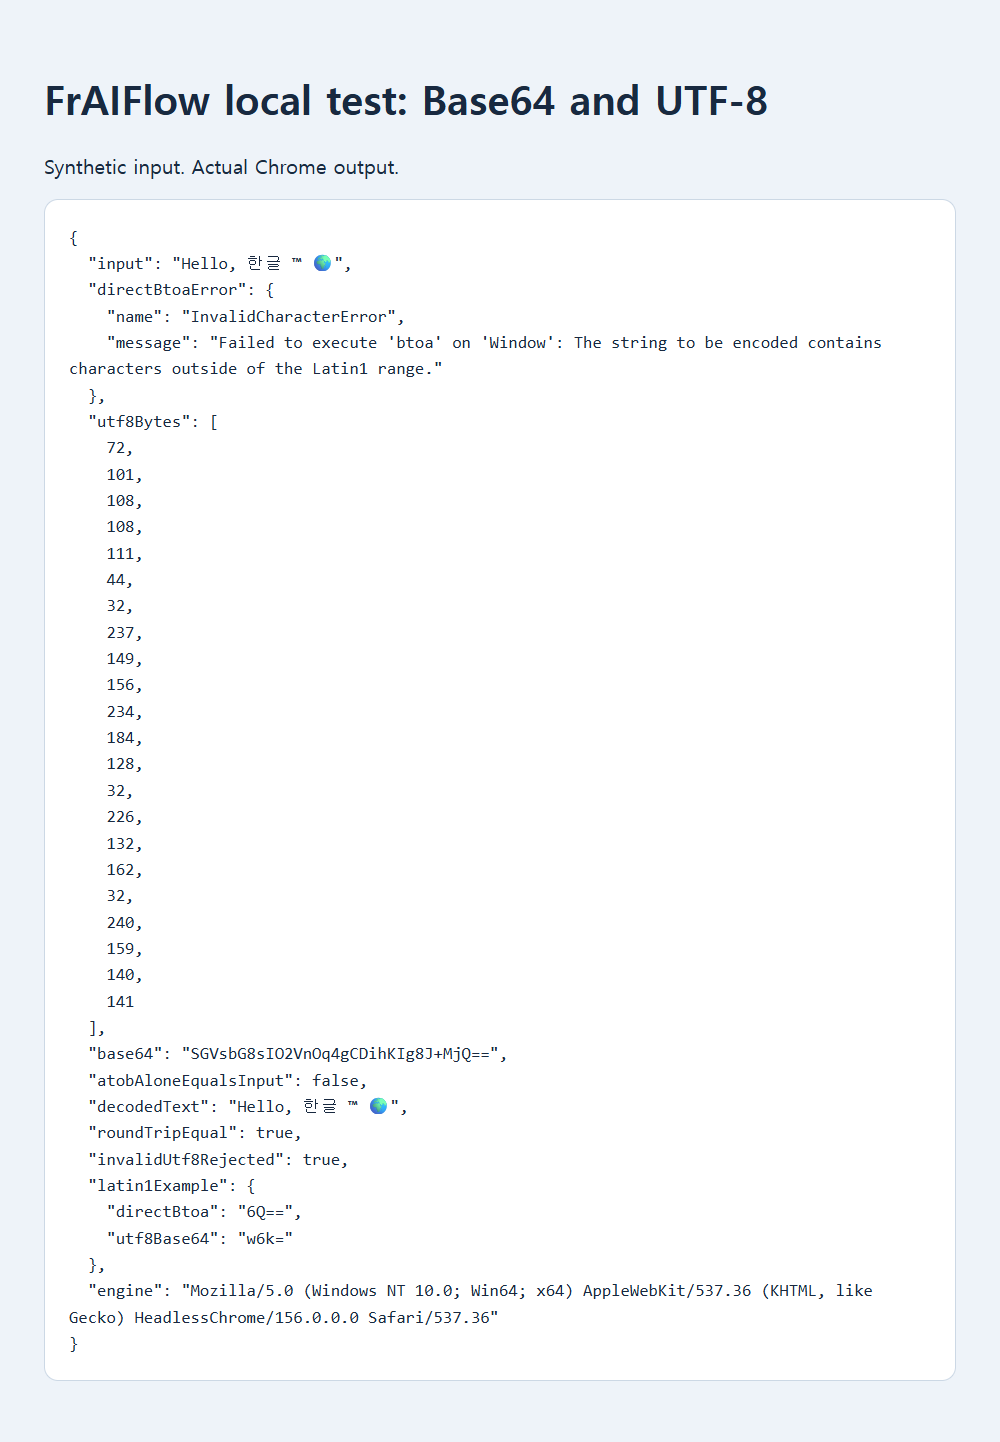
Ein gespeicherter lokaler Browsertest verwendete Hello, 한글 ™ 🌍. Der direkte btoa()-Aufruf löste einen InvalidCharacterError aus. TextEncoder erzeugte 22 UTF-8-Bytes, die als SGVsbG8sIO2VnOq4gCDihKIg8J+MjQ== kodiert wurden. Das Dekodieren dieser Bytes als UTF-8 stellte den Satz exakt wieder her. Dies ist ein künstlicher lokaler Test, keine der Anwendungen aus den Nutzerberichten.
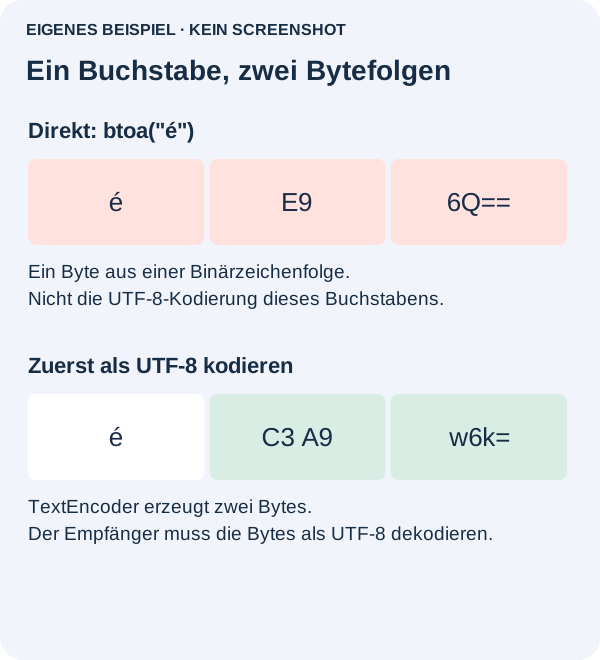
Tests mit ausschließlich ASCII können einen Fehler verbergen. Im Beispiel lieferte btoa("é") den Wert 6Q==; mit vorgeschalteter UTF-8-Kodierung entstand dagegen w6k=. Der erste Aufruf warf keinen Fehler, lieferte aber für einen Empfänger, der UTF-8 erwartet, die falschen Bytes. Base64 selbst enthält keine Angabe zur Zeichenkodierung.
Prüfen Sie, ob beim Dekodieren der ursprüngliche Text zurückkommt
Base64 ist weder Verschlüsselung noch URL-Escaping. Ein Pluszeichen kann in Abfrageparametern eine besondere Bedeutung haben; beachten Sie die verlinkte Anleitung zu Query-Parametern. Vermeiden Sie den veralteten Umweg über unescape, begrenzen Sie die Datenmenge sinnvoll und veröffentlichen Sie keine privaten Inhalte, nur um einen Kodierungsfehler vorzuführen.
Quellen, Beispiele und weiterführende Informationen
- Öffentliche Diskussion: Base64-Kodierung scheitert bei nicht lateinischen Zeichen
- Öffentliche Diskussion: atob dekodiert Base64, aber nicht korrekt zu UTF-8-Text
- MDN-Referenz: btoa
- Ursprüngliche ergänzende Darstellung
- Gespeicherter Nachweis des lokalen Tests
- MDN-Referenz: TextEncoder
- MDN-Referenz: atob
- MDN-Referenz: TextDecoder
- MDN-Referenz: ignoreBOM
- MDN-Referenz: decode
- MDN-Referenz: unescape
- Passende Anleitung: Base64 in Query-Parametern
- Warum scheinbar gültiges JSON schon am ersten Zeichen scheitert
- Warum gleich aussehende Texte nicht übereinstimmen