Warum gleich aussehende Texte nicht übereinstimmen
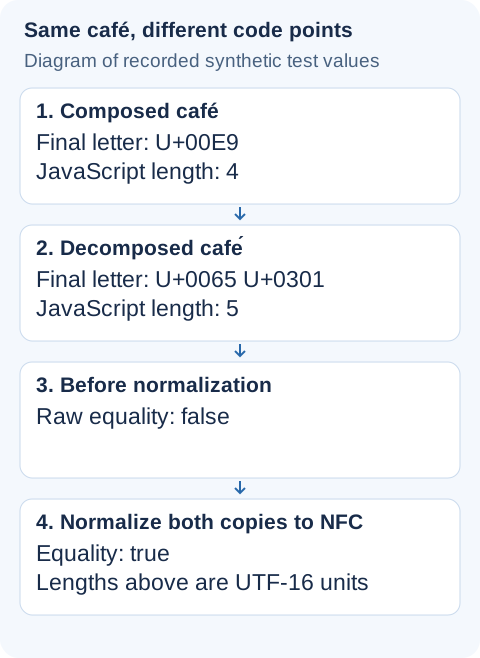
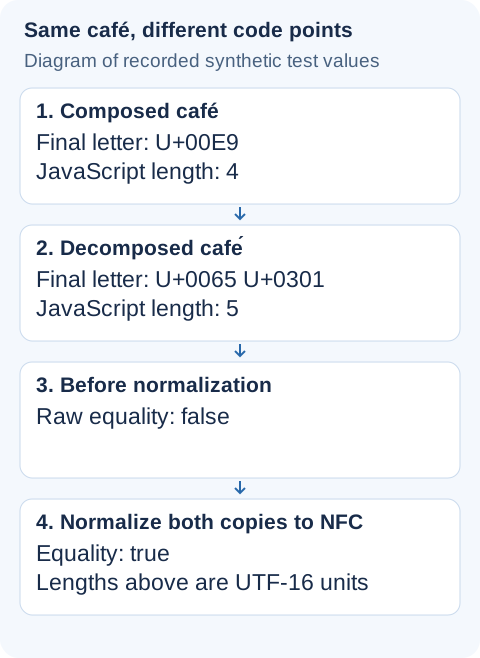
Zwei Schreibweisen von café können identisch aussehen und beim Vergleich trotzdem ungleich sein. Die eine endet möglicherweise mit U+00E9, die andere mit U+0065 und dem kombinierenden Zeichen U+0301. Der Akzent ist nicht falsch. Unterschiedlich sind die gespeicherten Unicode-Sequenzen. Die Vergleichsregel muss diesen Unterschied berücksichtigen.
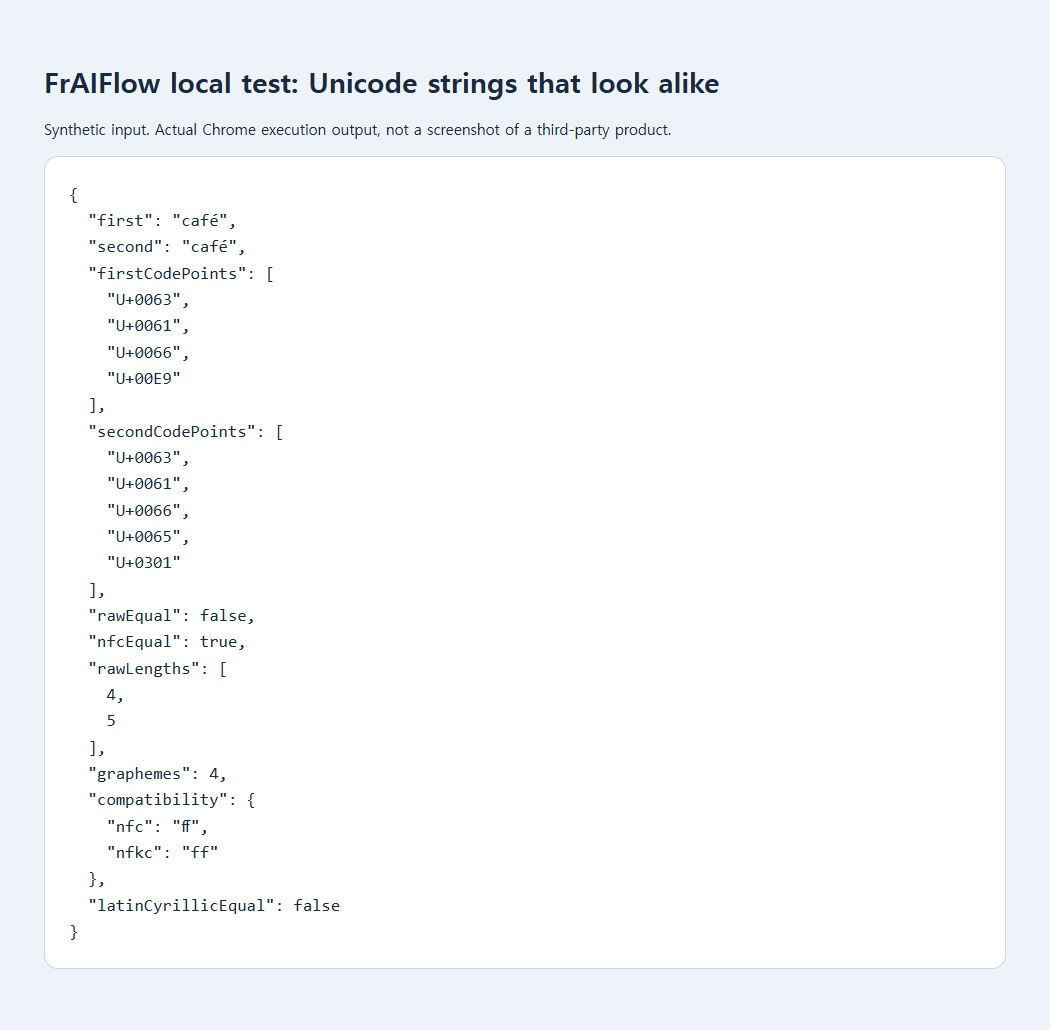
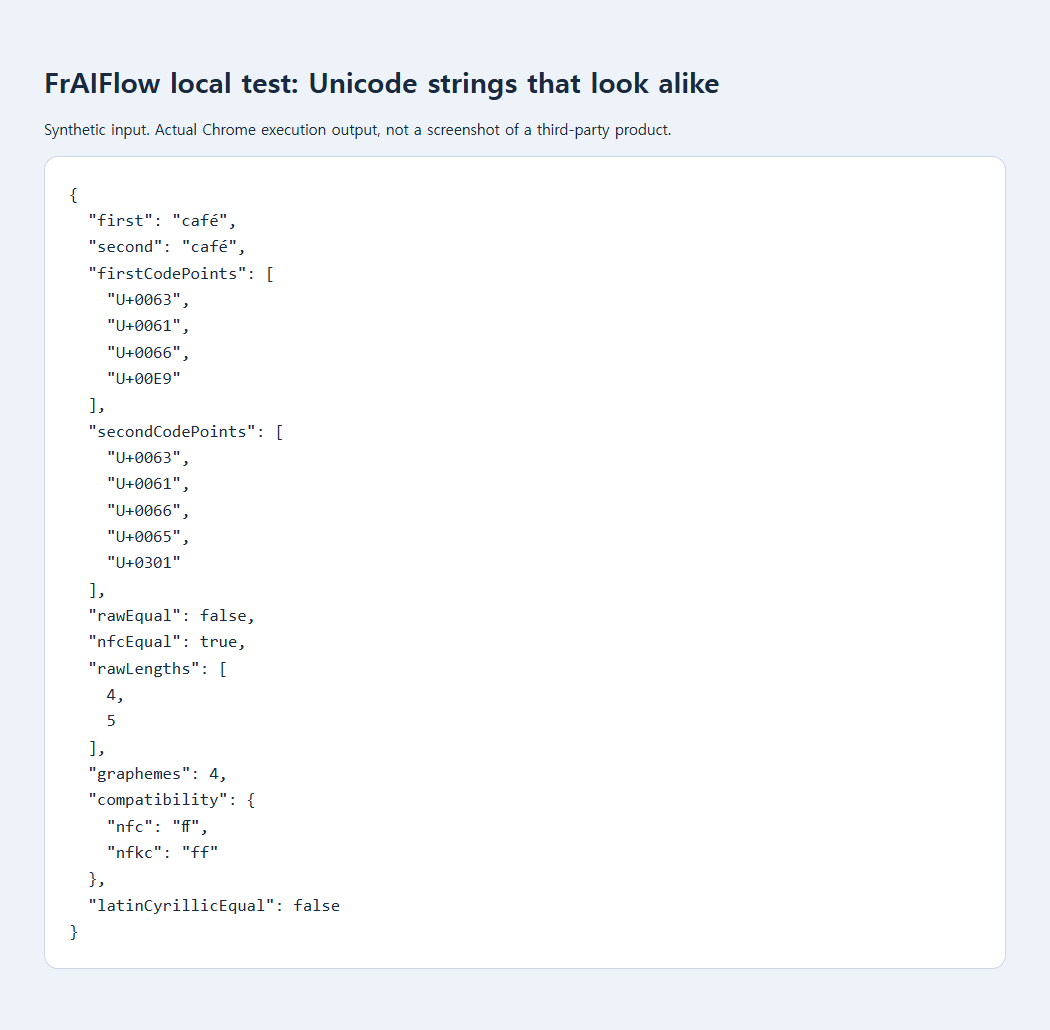
Eine Stack-Overflow-Frage von 2019 beschrieb optisch ähnliche vietnamesische Texte, deren Gleichheitsprüfung scheiterte. Die Antwort verwendete eine gemeinsame Normalisierungsform. Unser gespeicherter Browsertest nutzt ein anderes, künstlich zusammengestelltes café-Paar: Der direkte Vergleich ergab false, der Vergleich beider NFC-Formen true. Er stellt nicht die Anwendung aus dem Nutzerbericht nach.
Untersuchen Sie zuerst ein einzelnes abweichendes Wertepaar
Bevor Sie eine ganze Tabelle oder Datenbank ändern, übernehmen Sie nur die zwei Werte, die übereinstimmen sollten, in ein kleines lokales Skript. Verwenden Sie unverfängliche Beispieldaten, wenn die Originalwerte Kunden identifizieren. Die Codepunkte nebeneinander zu betrachten hilft mehr, als denselben Akzent immer wieder neu einzugeben.
const typed = "caf\u00E9";
const pasted = "cafe\u0301";
const points = s => Array.from(s, c =>
  "U+" + c.codePointAt(0).toString(16).toUpperCase().padStart(4, "0")
).join(" ");
console.log(points(typed));  // U+0063 U+0061 U+0066 U+00E9
console.log(points(pasted)); // U+0063 U+0061 U+0066 U+0065 U+0301
console.log(typed === pasted); // false
const matches = typed.normalize("NFC") === pasted.normalize("NFC");
console.log(matches); // true
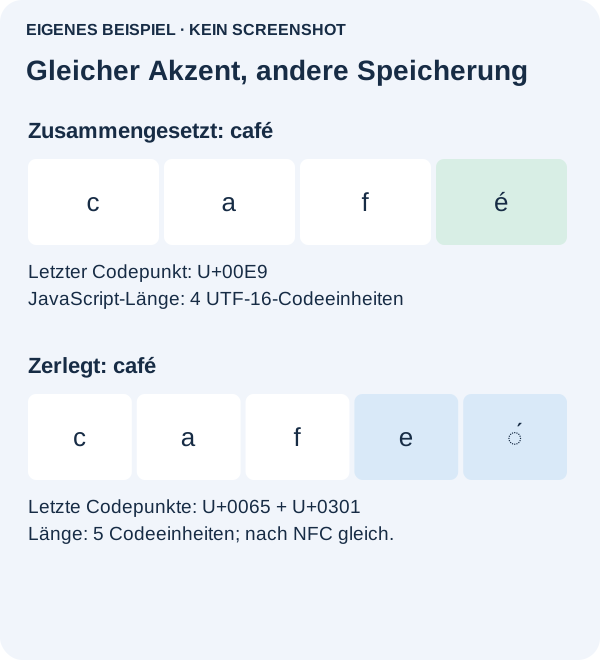
Lesen Sie beide Sequenzen von links nach rechts. Hier stimmen die ersten drei Buchstaben überein; nur der letzte Buchstabe mit Akzent ist unterschiedlich dargestellt. Genau dafür ist NFC vorgesehen. Die folgende Abbildung macht beide Speicherformen sichtbar. Das zusätzliche Zeichen ist ein kombinierender Akzent, kein unerwünschter weiterer Buchstabe.
Erzeugen Sie für eine Suche oder einen Importvergleich einen gesonderten normalisierten Vergleichsschlüssel und behalten Sie den Originalwert für die Anzeige. Normalisieren Sie beide Seiten des Vergleichs, auch bereits vorhandene Datenbankwerte. Wird nur die neue Eingabe normalisiert, bleiben ältere Datensätze uneinheitlich. Prüfen Sie vor der Anwendung auf alle Daten einige Paare, die übereinstimmen sollen, und einige, die unbedingt verschieden bleiben müssen.
Bleibt das Ergebnis false, suchen Sie nach einem abschließenden Leerzeichen, einem geschützten Leerzeichen oder Zeichen aus einem anderen Alphabet. Entfernen Sie nicht als pauschale Reaktion sämtliche Akzente oder Satzzeichen. Das wären zusätzliche Vergleichsregeln, die unterschiedliche Namen zusammenführen könnten. Betrifft eine vorgeschlagene Dublettengruppe Konten, Zahlungen oder Identitäten, lassen Sie sie prüfen, statt optische Ähnlichkeit als Beweis zu behandeln.
Unterscheiden Sie Textvergleich und Prüfung einer Kennung
Eine Übereinstimmung nach NFC beweist nicht, dass zwei Konten derselben Person gehören. Zeigen Sie vorgeschlagene Dublettengruppen zunächst an und entscheiden Sie, was eine Übereinstimmung in Ihren Daten bedeutet. Normalisieren Sie Passwörter, Signaturen oder undurchsichtige Tokens nicht nebenbei als Bereinigung: Dort können exakte Byte- oder Zeichenfolgen erforderlich sein.
Warum nicht überall NFKC verwenden?
NFKC ergänzt Kompatibilitätsabbildungen. Im aufgezeichneten Test blieb die Ligatur U+FB00 unter NFC unverändert, wurde unter NFKC aber zu ff. Für einen bewusst großzügigen Suchschlüssel kann das hilfreich sein. Dabei kann jedoch eine Unterscheidung verloren gehen, die in der ursprünglichen Schreibweise wichtig ist. Legen Sie deshalb erst die gewünschte Regel fest und wählen Sie dann die Umwandlung.
Normalisierung löst außerdem nicht das Problem ähnlich aussehender Zeichen: Das lateinische a und das kyrillische U+0430 blieben im Beispiel ungleich. Sie legt auch nicht die Zeichengrenze einer Website fest. Die beiden café-Formen hatten in JavaScript 4 beziehungsweise 5 UTF-16-Codeeinheiten; die Graphemsegmentierung des zerlegten Worts ergab 4 für Leser erkennbare Gruppen. Das sind unterschiedliche Messgrößen.
Quellen, Beispiele und weiterführende Informationen
- Öffentliche Diskussion: gleich aussehender Text ist nicht gleich – gemeinsame Kodierung finden
- Ursprüngliche ergänzende Darstellung
- Gespeicherter Nachweis des lokalen Tests
- MDN-Referenz: normalize
- Unicode-Spezifikation zur Normalisierung
- MDN-Referenz: length
- Öffentliche Diskussion: die korrekte Länge einer Zeichenfolge mit Emojis in JavaScript zählen
- Warum scheinbar gültiges JSON schon am ersten Zeichen scheitert
- Warum btoa() bei Unicode-Zeichen scheitert