Por que textos visualmente idênticos não coincidem
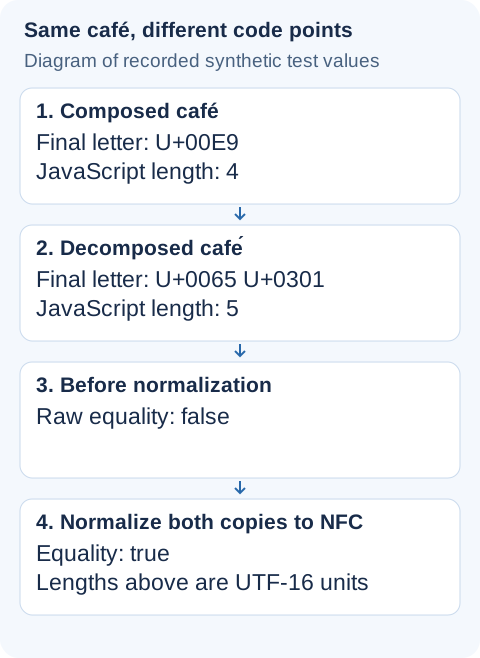
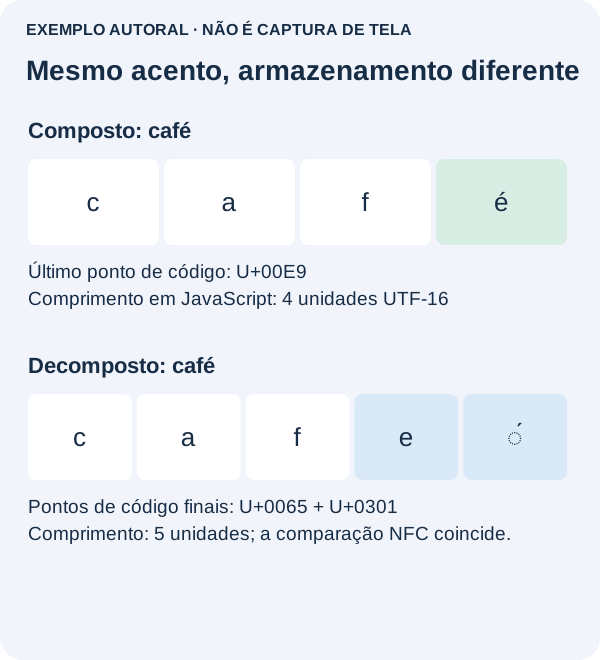
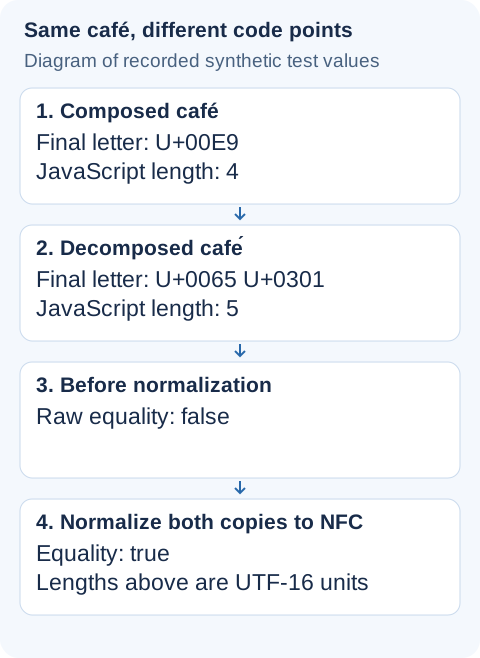
Duas cópias de café podem parecer idênticas e ainda ser diferentes em uma comparação. Uma pode terminar em U+00E9; a outra, em U+0065 seguido do combinante U+0301. O acento não está errado. As sequências Unicode armazenadas são diferentes, e a regra de comparação precisa considerar essa distinção.
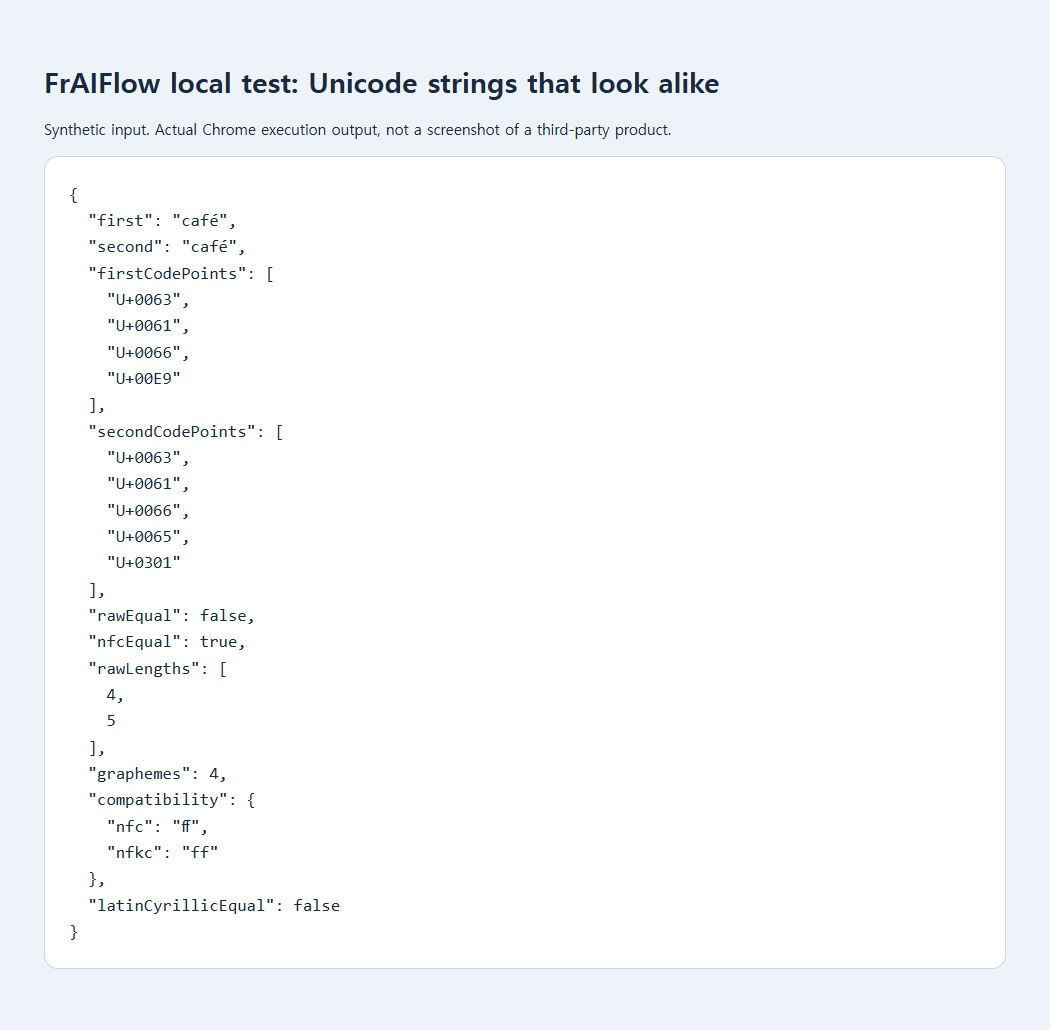
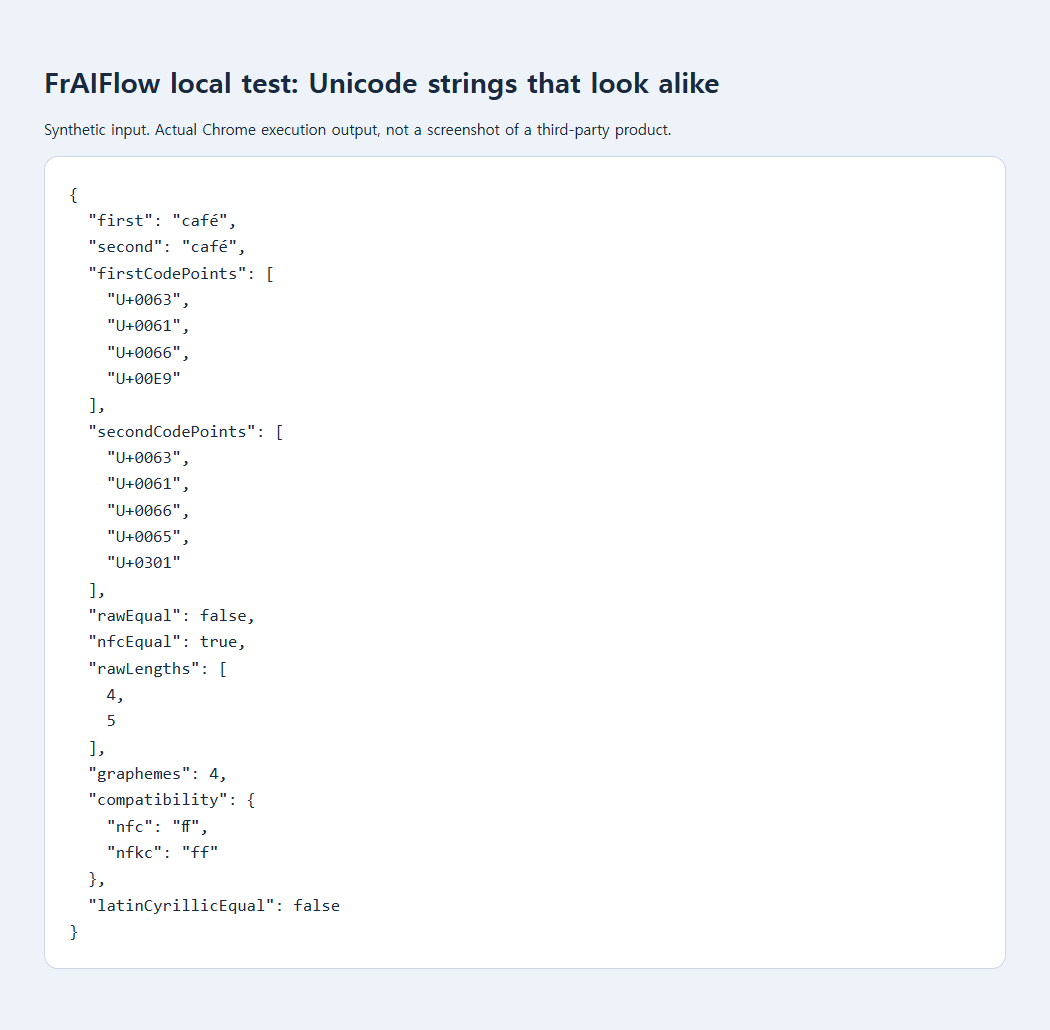
Uma pergunta de 2019 no Stack Overflow descreveu texto vietnamita visualmente semelhante que falhava nas comparações de igualdade. A resposta usou uma forma de normalização comum. Nosso teste de navegador preservado usa outro par sintético de café: a igualdade direta retornou false, enquanto comparar as duas formas NFC retornou true. Não é uma reprodução do aplicativo do autor do relato.
Comece por um único par que não coincide
Antes de mudar uma planilha ou um banco inteiro, copie apenas os dois valores que deveriam coincidir para um pequeno script local. Use amostras inofensivas se os valores reais identificarem clientes. Ver os pontos de código lado a lado ajuda muito mais do que redigitar repetidamente um acento.
const typed = "caf\u00E9";
const pasted = "cafe\u0301";
const points = s => Array.from(s, c =>
  "U+" + c.codePointAt(0).toString(16).toUpperCase().padStart(4, "0")
).join(" ");
console.log(points(typed));  // U+0063 U+0061 U+0066 U+00E9
console.log(points(pasted)); // U+0063 U+0061 U+0066 U+0065 U+0301
console.log(typed === pasted); // false
const matches = typed.normalize("NFC") === pasted.normalize("NFC");
console.log(matches); // true
Leia as duas sequências da esquerda para a direita. Aqui, as três primeiras letras coincidem; só a representação da letra final acentuada difere. É para esse caso que NFC foi criado. A ilustração abaixo mostra as duas formas de armazenamento; a marca extra é um acento combinante, não uma letra adicional indesejada.
Para uma comparação em busca ou importação, crie uma chave normalizada separada e mantenha o valor original para exibição. Normalize os dois lados da comparação, inclusive valores já existentes no banco. Normalizar apenas a entrada nova deixa os registros antigos inconsistentes. Antes de aplicar a regra a todos os registros, confira alguns pares que deveriam coincidir e outros que precisam permanecer diferentes.
Se o resultado ainda for false, procure um espaço no fim, um espaço não separável ou outro alfabeto. Não responda removendo todos os acentos ou sinais de pontuação. Essas são políticas adicionais de comparação que podem fundir nomes diferentes. Se um grupo proposto de duplicatas afetar contas, pagamentos ou identidade, encaminhe-o para revisão em vez de tratar semelhança visual como prova.
Separe comparação de identidade
Uma correspondência sob NFC não prova que duas contas pertencem à mesma pessoa. Examine os grupos propostos de duplicatas e defina o que uma correspondência significa para os dados. Não adicione normalização a senhas, assinaturas ou tokens opacos como uma limpeza incidental: esses sistemas podem exigir contratos exatos de bytes ou caracteres.
Por que não usar NFKC em tudo?
NFKC acrescenta mapeamentos de compatibilidade. No teste registrado, a ligatura U+FB00 permaneceu inalterada sob NFC, mas virou ff sob NFKC. Isso pode ajudar em uma chave de busca deliberadamente permissiva, mas eliminar uma distinção necessária na escrita original. Escolha a política antes da transformação.
A normalização também não resolve caracteres parecidos: o a latino e o U+0430 cirílico permaneceram diferentes no exemplo. Ela tampouco define o limite de caracteres de um site. As duas formas de café mediram 4 e 5 unidades de código UTF-16 em JavaScript; a segmentação em grafemas da palavra decomposta produziu 4 grupos percebidos pelo leitor. São medidas diferentes.
Fontes, exemplos e leituras adicionais
- Discussão pública: textos iguais não são iguais; como converter para a mesma codificação
- Diagrama complementar original
- Evidência preservada do teste local
- Referência MDN: normalize
- Especificação de normalização Unicode
- Referência MDN: length
- Discussão pública: contar corretamente o comprimento de uma string com emojis em JavaScript
- Por que um JSON aparentemente válido falha no primeiro caractere
- Por que o Base64 falha com texto em outros idiomas