Por que um JSON aparentemente válido falha no primeiro caractere
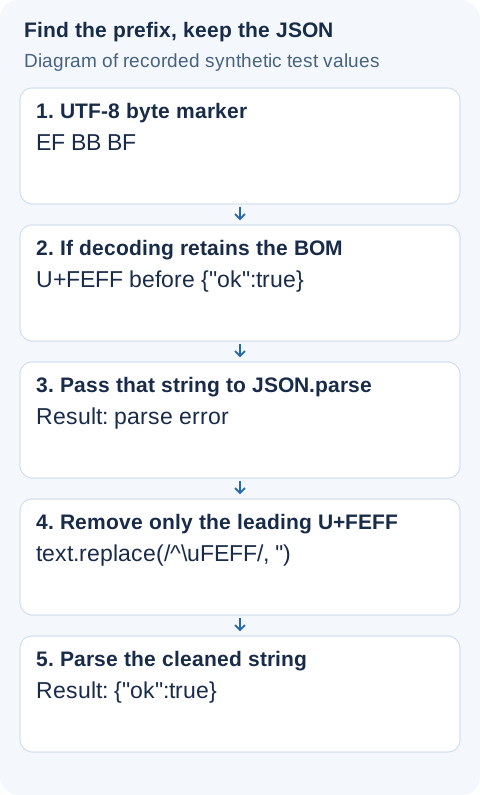
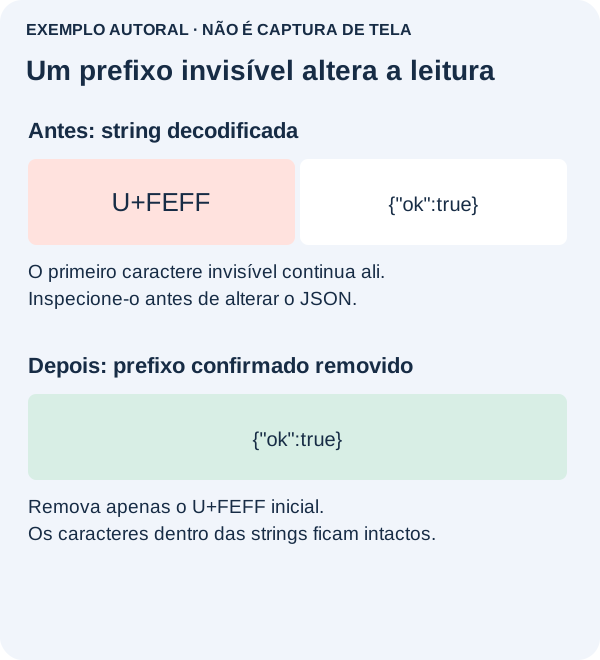
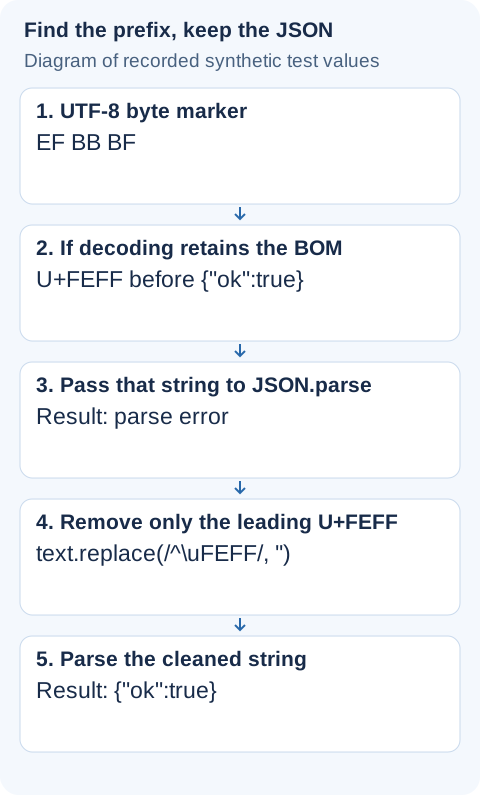
Você vê um objeto JSON válido e, mesmo assim, recebe um erro na posição zero. A chave de abertura pode não ser o primeiro caractere: um U+FEFF invisível pode estar antes dela. Preserve o original antes de tentar corrigir. Uma página HTML de login, uma resposta vazia ou um arquivo decodificado incorretamente exigem outra solução.
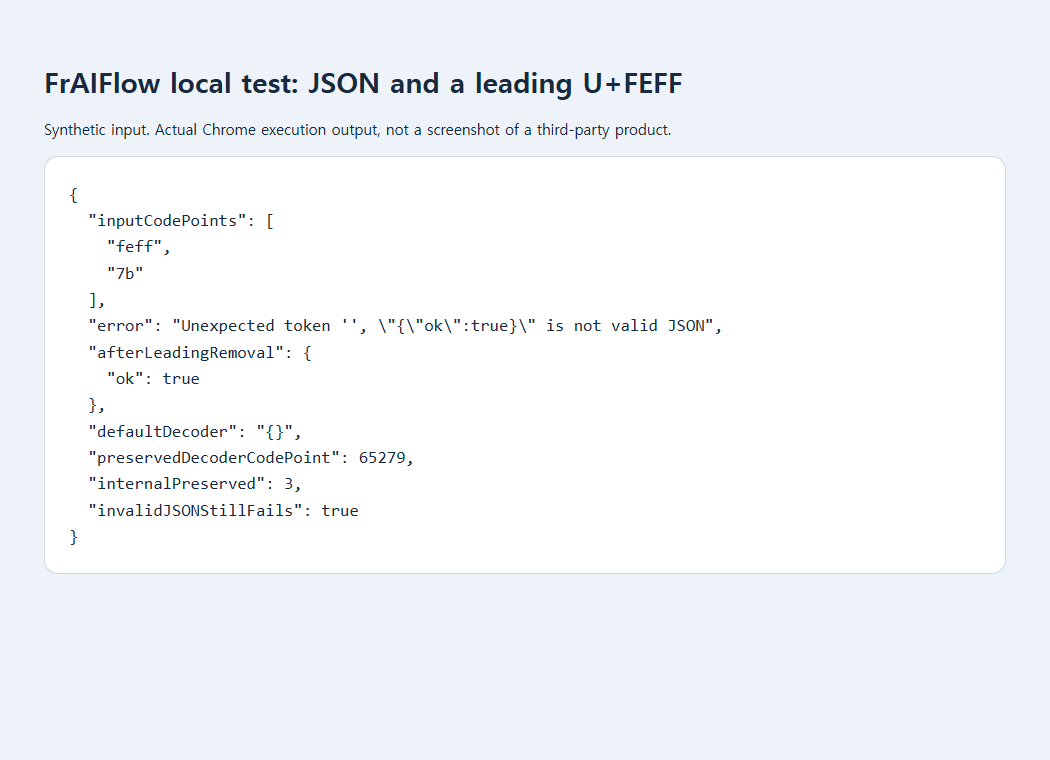
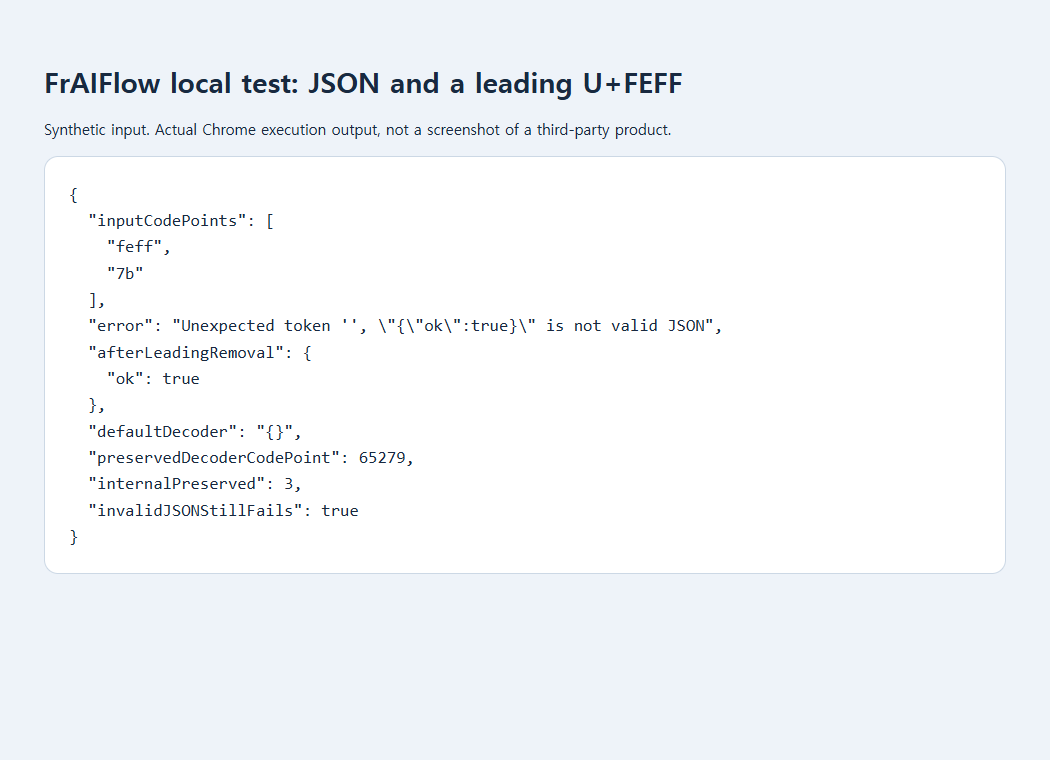
Um relato de 2017 no Stack Overflow associou uma falha semelhante no Node.js ao decimal 65279, ou U+FEFF. Um teste local de navegador preservado é uma evidência separada: um U+FEFF sintético seguido de {"ok":true} falhou, mas foi interpretado depois que apenas o prefixo foi removido. A captura registra esse teste local, não o arquivo do autor do relato.
Uma correção segura que você pode executar
Comece com uma cópia do arquivo, não com sua única exportação. Se ele veio de uma requisição web, confira primeiro o status HTTP e o tipo de conteúdo: uma página de login começando com <!doctype html> exige corrigir a autenticação, não limpar JSON. Para um arquivo local, use um editor que mostre a codificação. Não sobrescreva o original durante a investigação.
Depois de decodificar o arquivo para uma string JavaScript chamada text, use a pequena função abaixo no seu script de importação. Ela aceita um único marcador inicial conhecido e deixa todo o restante intacto.
function parseJsonText(text) {
  if (typeof text !== "string") throw new TypeError("Expected text");
  const hadBOM = text.charCodeAt(0) === 0xFEFF;
  const cleaned = hadBOM ? text.slice(1) : text;
  return { value: JSON.parse(cleaned), removedLeadingBOM: hadBOM };
}
const sample = '\uFEFF{"ok":true,"name":"한글"}';
const result = parseJsonText(sample);
console.log(result.removedLeadingBOM); // true
console.log(result.value.ok);          // true
console.log(result.value.name);        // 한글
Conferir o sucesso exige mais do que ver o erro desaparecer. Confirme se as propriedades esperadas existem e se o texto em outros idiomas continua legível. Execute a função também em JSON comum: ela deve interpretá-lo sem informar a remoção de um marcador. Entrada vazia ou objeto malformado ainda devem lançar erro. Mantenha o erro visível para quem chama a função, em vez de retornar um objeto vazio que poderia ser confundido com dados válidos.
Se o primeiro ponto de código não for U+FEFF, interrompa esse caminho de correção. Por exemplo, um arquivo decodificado com a codificação errada pode conter caracteres de substituição ou nulos alternados. Reabra-o usando a codificação escolhida pelo exportador ou solicite uma nova exportação UTF-8. Remover caracteres não reconstrói bytes decodificados incorretamente.
A diferença entre bytes e um caractere oculto
TextDecoder("utf-8") normalmente omite um BOM UTF-8 inicial. A opção ignoreBOM é contraintuitiva: true inclui o marcador na string decodificada. Nossa amostra de bytes EF BB BF 7B 7D tornou-se {} com o comportamento padrão. Isso não é detecção automática de codificação.
Confira quem produz o arquivo
Outro relato sobre PowerShell envolvia o caminho de decodificação errado. Out-File e redirecionamento do Windows PowerShell podem produzir UTF-16LE; versões mais recentes do PowerShell têm comportamento diferente. Remover texto não ASCII pode destruir nomes válidos sem corrigir essa incompatibilidade. Confira o comando produtor e sua versão e depois decodifique ou exporte corretamente. O fluxo daquele usuário não foi reproduzido em nosso teste.
RFC 8259 exige UTF-8 para JSON trocado fora de um ecossistema fechado e proíbe produtores de acrescentar BOM na transmissão em rede. Corrija o exportador se possível. No ponto de importação, teste JSON comum, o prefixo confirmado, JSON malformado e valores em outros idiomas. Registre somente o prefixo de diagnóstico, não o conteúdo privado do documento.
Fontes, exemplos e leituras adicionais
- Discussão pública: JSON.parse causa SyntaxError unexpected token na posição 0
- Diagrama complementar original
- Evidência preservada do teste local
- Referência MDN: ignoreBOM
- Discussão pública: JSON.parse e SyntaxError unexpected token na posição 0
- Documentação da Microsoft: about_character_encoding
- RFC 8259: formato de intercâmbio de dados JSON
- Por que textos visualmente idênticos não coincidem
- Por que o Base64 falha com texto em outros idiomas